Paysage
Les passerelles routent.
Les garde-fous inspectent.
Aucun ne compte.
Les outils qui se placent entre un agent de code et un modèle, relevés le 19/10/2026. Un outil conçu pour un autre travail n'est pas critiqué — et trois d'entre eux battent ce projet sur un point nommé ci-dessous.
Trois grappes, et un coin vide
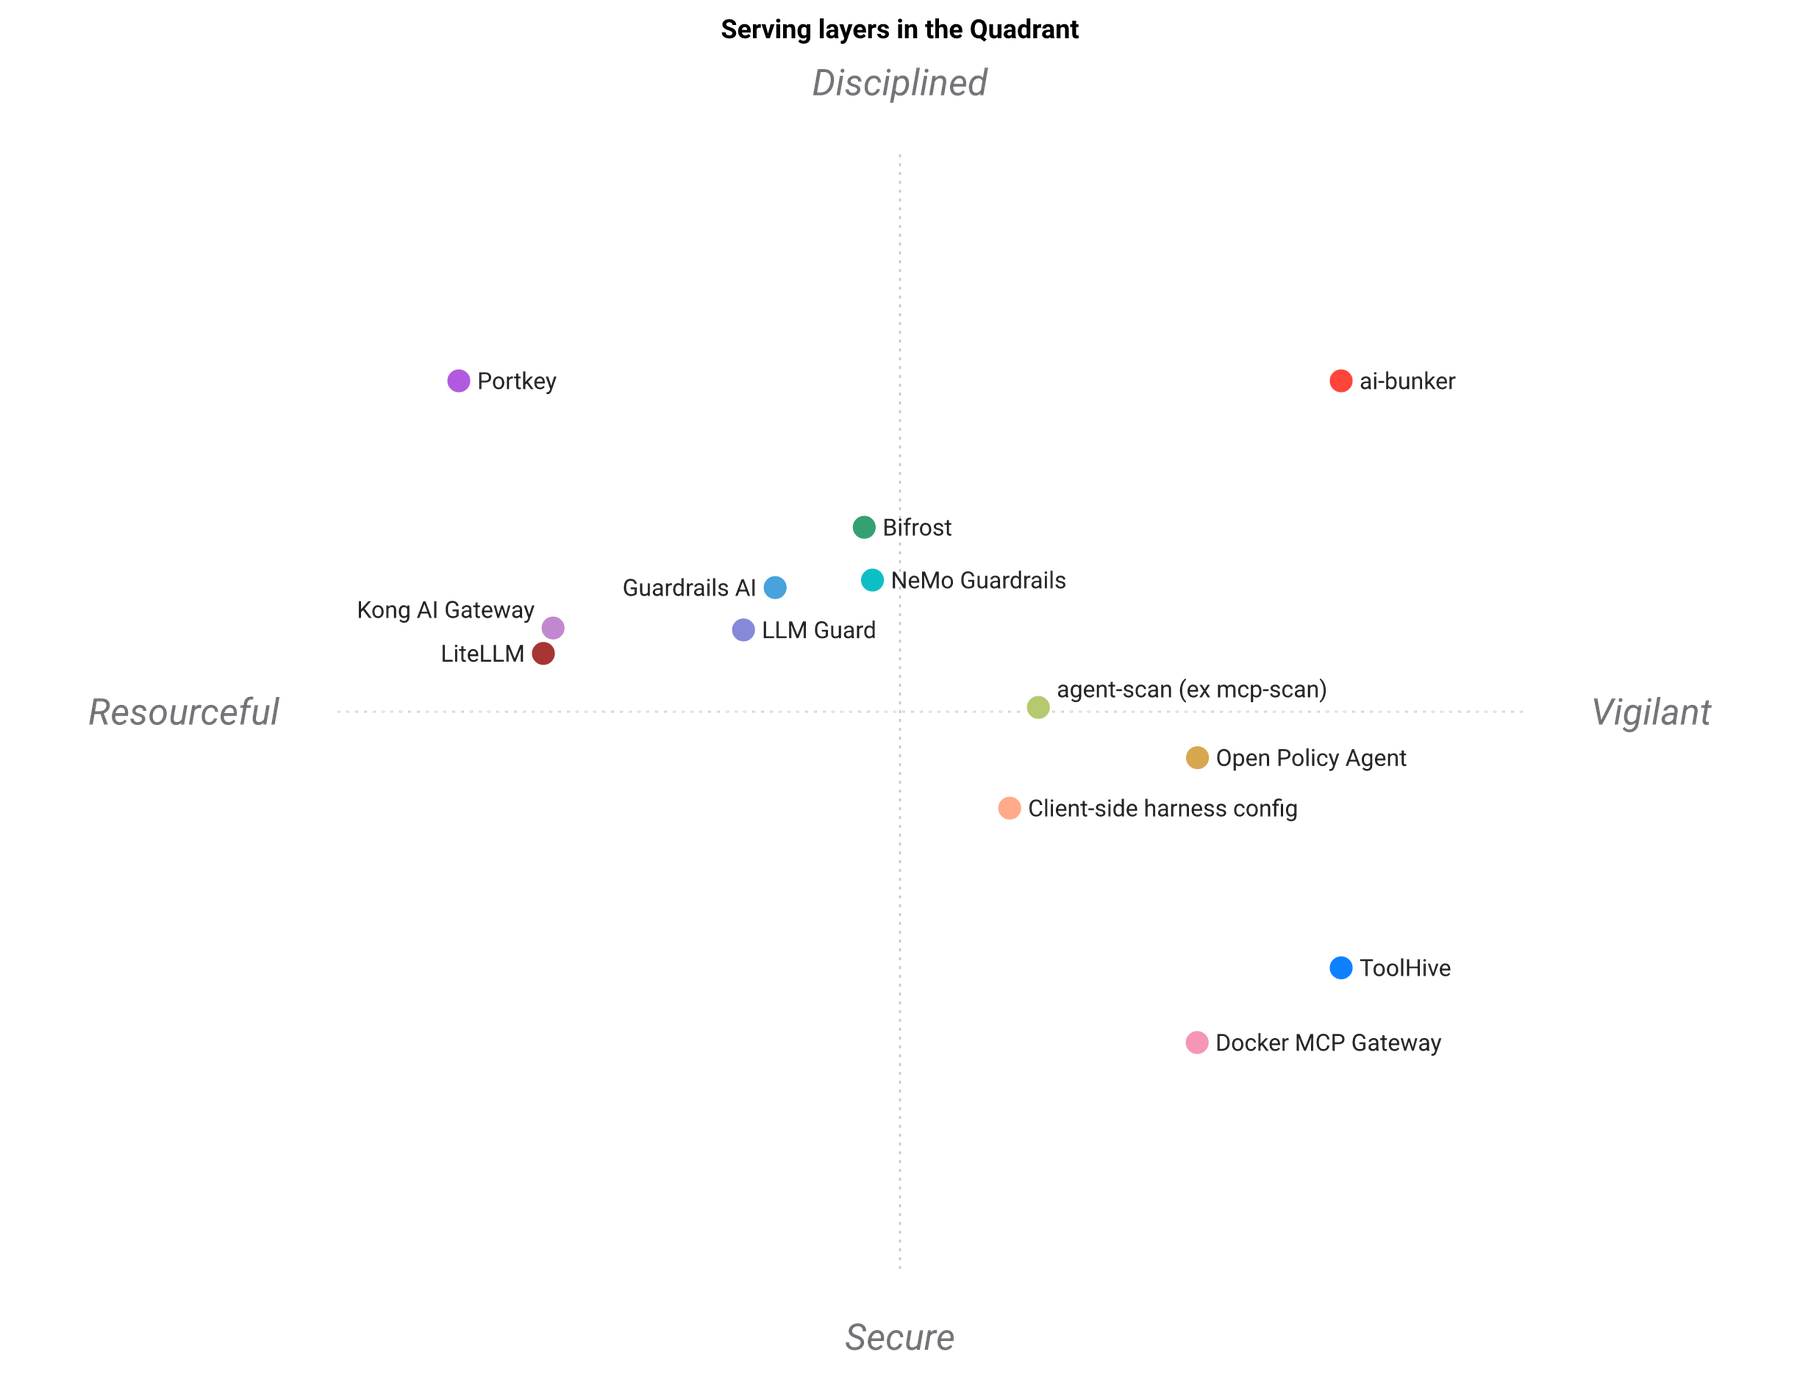
À gauche — les passerelles
LiteLLM, Kong, Portkey. Une seule surface compatible OpenAI sur une centaine de fournisseurs, avec clés, budgets, reprises et observabilité — et très bien faite. Ce qu'elles ne font pas : regarder ce que l'agent lit ou s'apprête à exécuter. Une sortie d'outil pleine de secrets et un rm -rf ~ les traversent comme des octets ordinaires.
À droite et en dessous — les moteurs de règles
NeMo Guardrails, Guardrails AI, LLM Guard. Ils inspectent le contenu correctement, et plusieurs le font mieux que ce projet. Ce qu'ils ne sont pas : des passerelles. Ce sont des bibliothèques que vous appelez, donc un agent qui ne les appelle pas n'est pas protégé, et changer de harnais les perd entièrement.
En haut à droite — vide, sauf celui-ci
Personne d'autre ne combine la position de la passerelle — chaque requête, chaque client, sans échappatoire — avec l'inspection du moteur de règles et un budget que le serveur compte. C'est une affirmation sur la couverture, pas sur la qualité.
Là où ce projet est en retard
À dire, parce qu'un paysage où un seul outil gagne toutes les colonnes n'est pas crédible.
- Largeur de fournisseurs — LiteLLM, et de loin
- Une centaine de fournisseurs contre ce que vous configurez ici. Si la question est « appeler beaucoup de fournisseurs depuis un seul client », LiteLLM est simplement la réponse — et ai-bunker peut se placer devant lui plutôt que le concurrencer.
- Classificateurs de contenu — LLM Guard et Guardrails AI
- Leurs scanners sont des modèles entraînés et des catalogues de validateurs curatés ; ici ce sont des expressions régulières versionnées avec un seuil d'entropie. Relisibles, diffables et gratuites à l'exécution — un arbitrage assumé, et sur la qualité brute de détection c'est un arbitrage, pas une victoire.
- Expressivité et test des politiques — OPA
- Rego exprime des conditions qu'une regex ne peut pas, et son outillage de test avec couverture est meilleur que rules --check. L'idée qu'une politique porte ses propres tests vient de là.
- Maturité
- C'est un 0.2.0-alpha à côté de projets qui ont des années de production.
Idées reprises au terrain
Rien de tout cela n'a été inventé ici, et le dire ne coûte rien.
-
Open Policy Agent
La politique porte ses propres tests, et les décisions sont journalisées dès le premier jour. Les deux sont désormais porteurs ici — et le premier a attrapé trois motifs faux avant tout déploiement.
-
gitleaks
Regex et seuil d'entropie, plus des listes d'exception par règle. Un scanner qui crie au loup apprend à ses lecteurs à l'ignorer.
-
Le spotlighting de Microsoft
Marquer le contenu récupéré comme de la donnée. La reconnaissance de motifs attrape les tentatives maladroites ; le marquage structurel est ce qui tient quand les motifs ratent.
-
La recherche sur les harnais d'agents
La distinction « prévention / remède » : borner structurellement le contexte, ou le laisser croître et compresser. Ce projet est de la prévention, déplacée côté serveur — une case que la taxonomie n'a pas.