En bref
L'apprentissage par renforcement (RL, pour reinforcement learning) entraîne une machine par essais et erreurs, guidée par une récompense. En 2018, Joelle Pineau a montré devant la conférence ICLR que ses résultats publiés résistaient mal à un examen simple : le meilleur algorithme change d'une tâche à l'autre, trois implémentations du même algorithme donnent trois résultats, deux paquets de cinq exécutions du même programme ressemblent à deux méthodes différentes ; enfin, les articles publient trois essais quand il en faudrait dix.
Huit ans plus tard, le RL a gagné sa place : c'est lui qui affine ChatGPT et qui a appris à raisonner à DeepSeek-R1. Les pièges de 2018 sont revenus avec lui, à plus grande échelle.
Nous avons recoché en 2026 la grille qu'elle appliquait aux articles de 2018, sur cinquante articles récents tirés au hasard : l'évaluation tenue à part a progressé, le réglage des références a reculé, le test statistique reste absent. Ma réponse : trois conditions, puis une grille de lecture.
- Quand le RL vaut son coût. Un environnement qu'on fait tourner pour presque rien, une récompense qu'on vérifie sans se tromper, le budget de dix graines et d'une référence réglée avec le même soin.
- Comment lire une annonce de RL. Combien de graines, quel intervalle, quelle référence, combien de familles de modèles, quel code.
Pourquoi je n'y suis jamais allé
On me pose la question depuis dix ans, sous deux formes. Les étudiants demandent : faut-il que je me mette au RL ? Les dirigeants demandent : est-ce que ça marche vraiment ? Je n'ai jamais fait de RL. Je fais des mathématiques appliquées avec un ordinateur, pour des entreprises, presque toujours en apprentissage supervisé : on montre à la machine des exemples dont on connaît la bonne réponse, elle apprend à la retrouver, puis on la juge sur des exemples qu'elle n'a jamais vus.
Le RL change le contrat. Personne ne donne la bonne réponse. Un agent agit dans un environnement, un jeu, un robot simulé, un marché ; il reçoit de temps en temps une récompense, un nombre ; il ajuste sa façon d'agir pour en recevoir davantage. L'idée est superbe. Elle a battu les meilleurs joueurs de backgammon dès les années 19901 puis ceux de go en 20162. Mes soupçons venaient du reste. Un seul nombre, parfois à la toute fin d'une longue suite d'actions, pour tout apprendre. Des courbes d'apprentissage qui zigzaguent. Des résultats spectaculaires que personne, autour de moi, n'arrivait à refaire.
Je n'étais pas seul. En février 2018, Alex Irpan, ingénieur chez Google, publiait un billet resté célèbre, « Deep Reinforcement Learning Doesn't Work Yet ». Il y écrivait : « Quand quelqu'un me demande si l'apprentissage par renforcement peut résoudre son problème, je lui réponds que non. Je pense avoir raison au moins 70 % du temps. »3 Un soupçon partagé reste un soupçon. Il me fallait quelqu'un du métier, qui connaisse le RL de l'intérieur et qui ait mesuré.
Joelle Pineau le 25 avril 2018, une semaine avant sa conférence de Vancouver. Photo Musée des sciences et de la technologie du Canada, licence CC BY 3.0, via Wikimedia Commons.
Vancouver, 3 mai 2018
Le jeudi 3 mai 2018, à 9 heures, Joelle Pineau ouvre la journée de la conférence ICLR, l'une des trois grandes conférences de l'apprentissage automatique, par une conférence invitée : « Reproducibility, Reusability, and Robustness in Deep Reinforcement Learning »4. Elle est professeure à l'université McGill et dirige le laboratoire de Facebook AI Research à Montréal. Elle fait du RL depuis 1999. À son premier atelier sur le sujet, en 2000, ils étaient trente-cinq dans la salle. En 2016, elle compte environ treize mille articles de RL publiés dans l'année. Personne ne peut accuser l'oratrice d'en vouloir au domaine.
Elle commence par une définition, celle de la National Science Foundation américaine : un résultat est reproductible quand un autre chercheur le retrouve avec le même matériel ; c'est la condition minimale pour qu'un résultat soit crédible et informatif5. Puis un chiffre. En 2016, la revue Nature a interrogé 1 576 chercheurs : 52 % voient une crise de la reproductibilité « significative », 38 % une crise « légère » ; plus de 70 % ont déjà échoué à refaire l'expérience d'un collègue6. Elle a posé la même question à vingt spécialistes de l'apprentissage automatique lors d'un atelier, en décembre 2017 : 80 % voient une crise.
Enfin une phrase de 1995, de deux statisticiens de Stanford, Jonathan Buckheit et David Donoho, qui la tenaient eux-mêmes du géophysicien Jon Claerbout : « Un article de science computationnelle n'est pas la recherche elle-même, il n'en est que la publicité. La recherche, c'est l'environnement logiciel complet et l'ensemble des instructions qui ont produit les figures. »7 La suite de la conférence met cette phrase à l'épreuve, sur le terrain qu'elle connaît le mieux.
Le meilleur algorithme change de tâche en tâche
Le terrain est celui des gradients de politique. Une politique est la règle de conduite de l'agent : dans telle situation, faire telle action. On la confie à un réseau de neurones et on la corrige petit à petit dans la direction qui augmente la récompense moyenne. Quatre algorithmes de cette famille servent alors de références dans presque tous les articles : TRPO, PPO, DDPG et ACKTR. Elle a vérifié que les sept articles de ce type acceptés à l'ICLR 2018 se comparent tous à eux.
Le banc d'essai est MuJoCo, un simulateur physique où des pantins articulés apprennent à avancer : HalfCheetah, un demi-guépard à deux pattes ; Hopper, une jambe qui sautille ; Walker2d, un marcheur ; Swimmer, un nageur. Les quatre tâches se ressemblent : quelques articulations, des commandes continues, une physique sans surprise. On attendrait le même vainqueur partout. Son équipe a lancé les quatre algorithmes sur les quatre tâches, avec cinq graines chacun8.
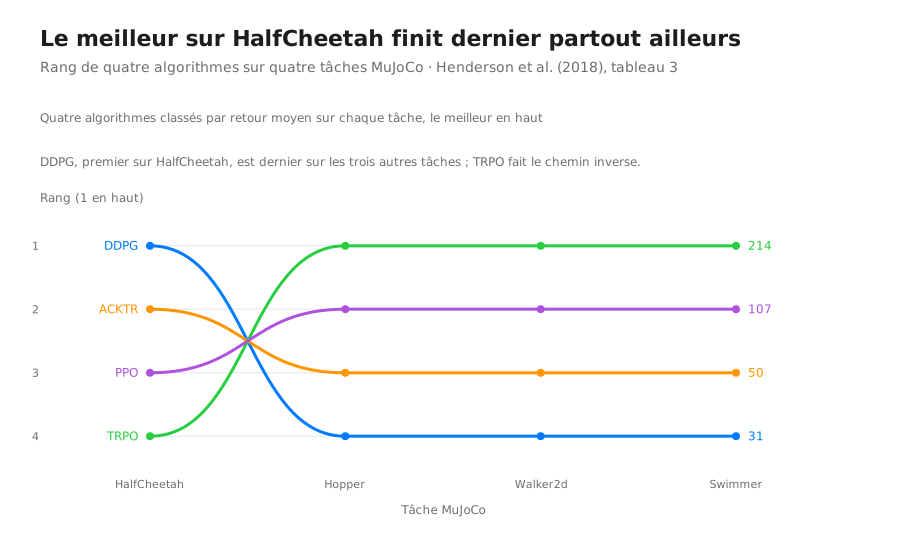
Le classement s'inverse dès qu'on quitte HalfCheetah. Retour moyen estimé par rééchantillonnage, d'après Henderson et al. (2018), tableau 3. Sur HalfCheetah, les intervalles de confiance de DDPG et d'ACKTR se chevauchent : même la première place y est fragile.
DDPG domine HalfCheetah ; il finit dernier sur les trois autres tâches. TRPO, dernier sur HalfCheetah, gagne partout ailleurs. Sur Swimmer, l'algorithme vainqueur de HalfCheetah n'apprend presque rien. Le classement entier dépend donc du choix de la tâche. Un auteur qui teste sa méthode sur HalfCheetah contre TRPO et un auteur qui la teste sur Hopper contre DDPG publient deux victoires faciles, sans que personne ait triché.
Trois implémentations, trois résultats
Elle pousse plus loin. Peut-être son équipe a-t-elle mal codé ces références ? Une recherche « TRPO » sur GitHub renvoie une dizaine de dépôts publics, ce qu'elle trouve d'abord réjouissant : c'est exactement le partage qu'elle défend. L'article de son équipe en compare trois, toutes sérieuses : le code d'origine de l'auteur de TRPO, celui de la bibliothèque OpenAI Baselines et celui de la bibliothèque rllab. Même algorithme, même tâche, mêmes réglages : trois courbes très différentes. L'expérience refaite sur trois implémentations de DDPG donne le même écart8.
Viennent ensuite les détails qu'un article ne mentionne presque jamais. La taille du réseau de neurones change le résultat. La fonction d'activation, ce petit calcul que chaque neurone applique à son entrée, aussi. L'échelle de la récompense, entre 0 et 1 ou entre 0 et 10, bouleverse l'apprentissage, alors qu'avec les méthodes d'avant les réseaux de neurones on la changeait sans conséquence. Ces réglages interagissent : l'effet de l'échelle s'inverse selon qu'on normalise ou non les couches du réseau.
Sa diapositive suivante pose la question qui fâche : « Quand on teste une référence, à quel point est-on motivé pour lui trouver ses meilleurs réglages ? » Chaque réglage oublié d'une référence devient un gain apparent pour la méthode nouvelle. Personne n'a besoin d'être malhonnête. Il suffit de régler son propre algorithme un mois et celui des autres un après-midi.
Même code, autre graine
Puis vient la diapositive que je n'ai jamais oubliée. Deux courbes d'apprentissage sur HalfCheetah. L'orange monte vers 4 000 ; la bleue plafonne vers 2 700. Chacune est la moyenne de cinq exécutions, avec sa bande d'incertitude. Les deux bandes se séparent nettement. N'importe quel relecteur y verrait deux algorithmes, l'un meilleur que l'autre. Elle fait durer le suspense, puis donne la réponse : les deux courbes sortent du même code TRPO, avec les mêmes réglages, les meilleurs connus. Seule la graine aléatoire change.
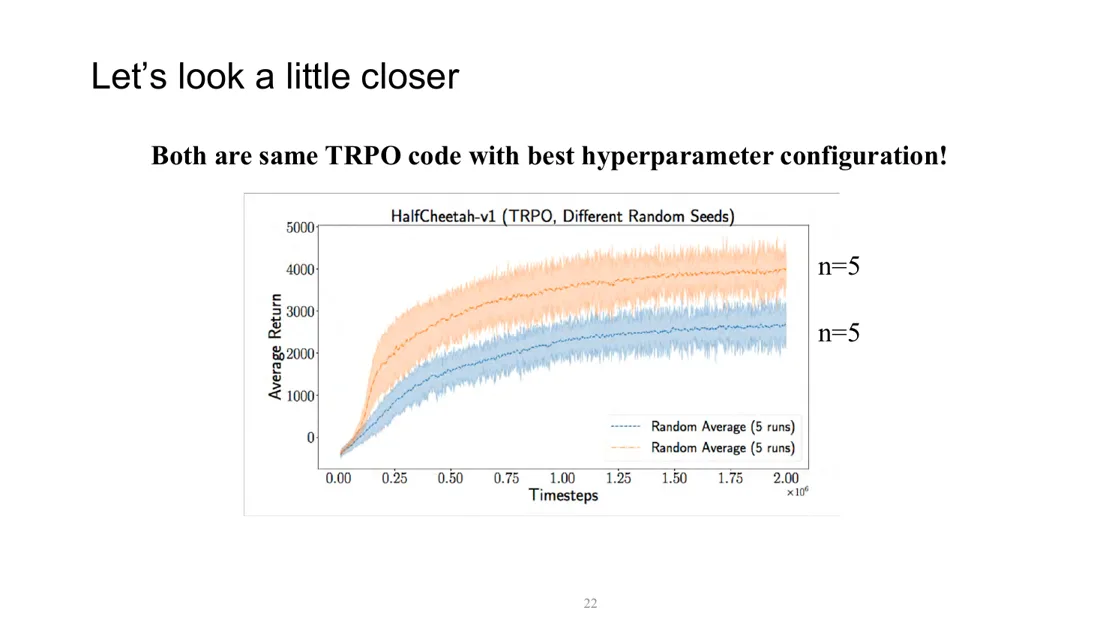
La diapositive telle qu'elle l'a reprise à NeurIPS en décembre 2018, où la réponse est écrite. Joelle Pineau, NeurIPS 2018, diapositive 22, d'après Henderson et al. (2018), figure 5.
La graine est le nombre qui initialise le générateur de hasard d'un programme. Elle décide des poids de départ du réseau, de l'ordre des épisodes, des petites perturbations du simulateur. En apprentissage supervisé, changer de graine fait d'ordinaire bouger un score de peu. En RL, le hasard du début décide de ce que l'agent explore, ce qu'il explore décide de ce qu'il apprend ; ce qu'il apprend décide de ce qu'il explorera ensuite. Une petite différence au départ devient un comportement différent à l'arrivée.
L'article publié dit exactement ce qui a été fait. Dix exécutions du même programme, coupées en deux groupes de cinq, puis un test statistique classique de comparaison de deux moyennes : t = −9,09, p = 0,00168. Avec le seuil habituel de 5 %, ce test déclare l'écart significatif. Il compare pourtant le même algorithme à lui-même. Pour comprendre comment, j'ai refait l'expérience en simulation.
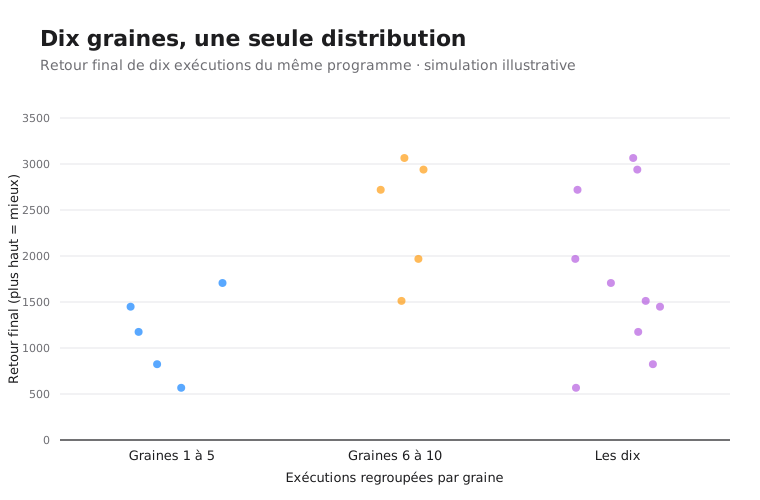
Dix exécutions simulées d'un même programme, où seule la graine change. Coupées en deux, elles semblent venir de deux méthodes ; réunies, elles forment un seul nuage. J'ai tiré des jeux de dix graines jusqu'à obtenir un écart net entre les deux moitiés : c'est précisément le biais que la figure dénonce. Valeurs illustratives.
Les deux paquets de cinq ne viennent pas de deux lois différentes ; ils viennent des deux bouts d'une seule loi, très étalée. Avec cinq tirages par groupe, ces deux bouts tombent souvent assez loin l'un de l'autre pour tromper un test qui suppose des résultats bien sages, regroupés en cloche. Si l'on ajoute qu'un laboratoire essaie plusieurs graines, plusieurs tâches et plusieurs réglages avant de publier, il en trouve toujours une combinaison qui « marche ». C'était exactement mon soupçon, en mieux mesuré.
Trois essais, jamais dix
Combien d'exécutions les articles publient-ils ? Elle a relevé le chiffre dans sept articles de RL parmi les plus cités de l'époque : cinq meilleurs essais sur un nombre non dit, entre trois et neuf, cinq, trois, cinq, cinq, les deux ou trois meilleurs8. Aucun n'atteint dix. Elle le dit avec indulgence, puisqu'une exécution dure des heures, voire des jours, après des semaines de réglage. Puis elle montre ce que coûte cette économie.
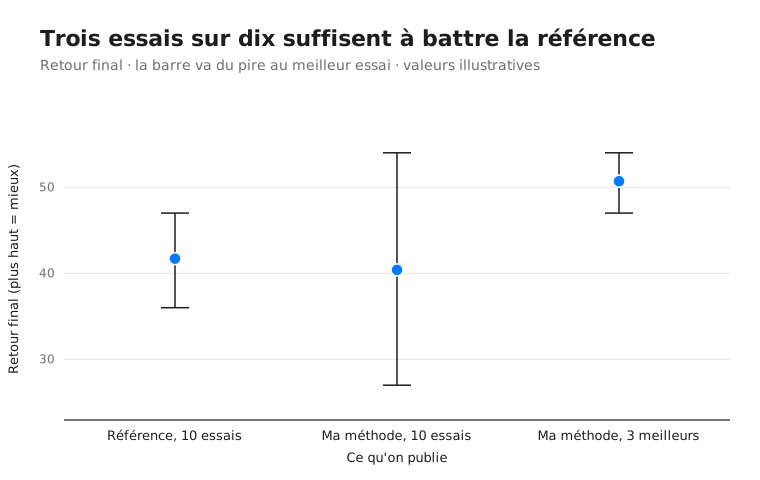
Sur dix essais, la nouvelle méthode ne bat pas la référence. Sur ses trois meilleurs, elle l'écrase, avec une dispersion trois fois plus petite. D'après la diapositive 30 de Vancouver ; valeurs illustratives.
Garder les trois meilleurs essais sur dix fait deux choses à la fois. La moyenne monte : c'est un biais positif. La dispersion fond, puisqu'on a jeté les mauvais cas : la méthode a l'air plus fiable qu'elle n'est. Un étudiant qui arrive avec ses dix courbes s'entend dire « ton algorithme apprend » ; avec les trois meilleures, « on a une tendance, écrivons l'article pour NIPS ». Elle raconte la scène pour faire rire la salle. La salle rit, parce qu'elle s'y reconnaît.
Elle termine sur l'enjeu. Pendant vingt ans, le RL n'a servi qu'à jouer, au backgammon puis au go ; ses imprécisions ne coûtaient rien. Il arrive maintenant vers la conception de traitements médicaux, la gestion de l'énergie, la finance. Elle cite en réponse aux questions de la salle ses habitudes personnelles : interroger les bons résultats autant que les mauvais, tout documenter, relancer ses expériences dans les heures qui précèdent la soumission. Elle voudrait aussi que les grandes conférences n'acceptent plus d'article sans son code.
Ce qu'elle a obtenu
Elle ne s'est pas contentée de parler. À l'automne 2017, elle avait confié à ses quelque 180 étudiants de McGill un projet de fin de cours : choisir un article soumis à l'ICLR 2018 et tenter de reproduire ses résultats. D'autres cours ont suivi dans plusieurs pays. Le bilan officiel, publié plus tard, compte 123 articles réclamés par des équipes de 31 institutions9. Parmi les participants qui ont répondu à son sondage, 54,5 % ont reproduit une partie du travail et 32,7 % l'essentiel ; 22 % ont jugé l'exercice très difficile. Côté auteurs, 79 % voulaient que leur article de 2019 passe par le même examen.
En décembre 2018, à Montréal, elle reprend sa conférence devant NeurIPS avec un chiffre nouveau. Son équipe a lu cinquante articles de RL publiés en 2018 à NeurIPS, ICML et ICLR, puis coché une grille de huit cases10.
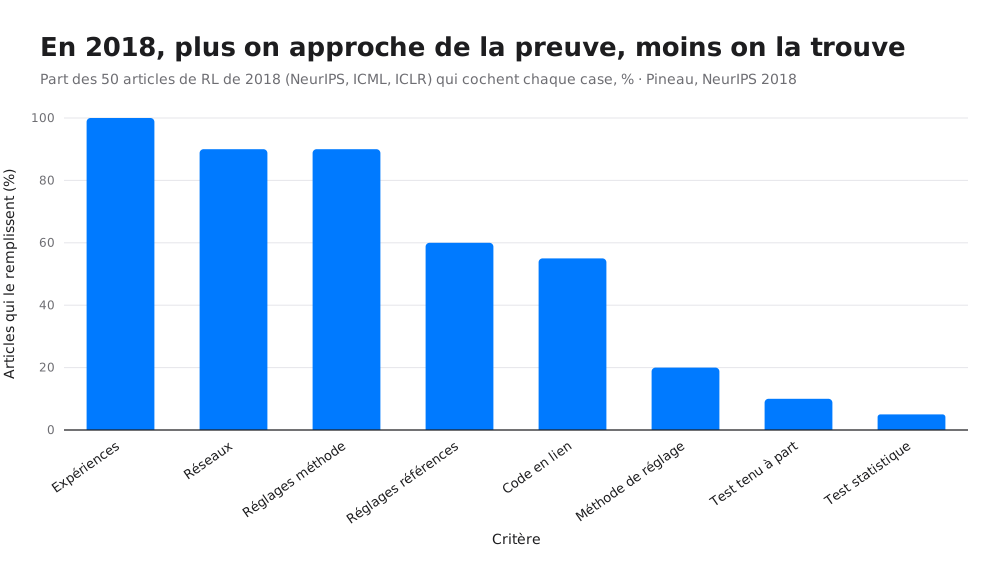
Cinquante articles de RL de 2018, huit questions. Plus la case se rapproche de la preuve, moins elle est cochée. Joelle Pineau, NeurIPS 2018, diapositive 29.
Neuf articles sur dix donnent les réglages de leur méthode ; six sur dix ceux des références. Un sur cinq dit comment il a choisi ses réglages. Un sur dix évalue l'agent ailleurs que là où il s'est entraîné. Un sur vingt applique un test statistique. La même conférence pose une question que je cite souvent : « Mythe ou réalité ? Le RL est le seul domaine de l'apprentissage automatique où il est acceptable de tester sur l'ensemble d'entraînement. » En apprentissage supervisé, ce serait une faute de débutant. En RL de 2018, c'était l'usage : on entraîne l'agent sur HalfCheetah et on publie son score sur HalfCheetah.
Elle propose une liste de contrôle de reproductibilité en fin d'année 2018. NeurIPS la rend obligatoire en 2019, à la soumission puis à la version finale, avec une politique d'incitation au code et un défi de reproduction. Le rapport de ce programme, publié en 2021, mesure l'effet : moins de 50 % des articles acceptés de NeurIPS 2018 fournissaient leur code dans leur version finale ; ils sont 74,4 % en 20199. La liste de contrôle est depuis devenue la norme des grandes conférences du domaine.
Remesuré en 2026
Une grille cochée en 2018 se recoche. Nous avons repris ses huit questions sur cinquante articles de RL tirés au hasard, avec une graine publiée, parmi les 1 252 articles dont le titre annonce du RL aux trois conférences les plus récentes : ICLR 2026, ICML 2026 et NeurIPS 2025. Les lecteurs sont des agents d'intelligence artificielle (Claude, d'Anthropic) qui justifient chaque réponse par une citation exacte de l'article et sa page ; deux lecteurs indépendants, sur dix articles lus deux fois, s'accordent sur 127 décisions sur 130, soit 98 %.
Les limites sont au nombre de quatre. Le filtre par le titre laisse de côté les articles de RL qui ne le disent pas dans leur titre. Seuls les articles dont le PDF est librement accessible entrent dans l'échantillon. Cinquante articles donnent des intervalles larges. Joelle Pineau ne décrit pas comment elle a choisi les siens. Pour savoir ce que valent nos lecteurs face à son équipe, nous avons d'abord relu avec la même grille douze articles de RL de 2018, tirés à ICML et NeurIPS : une différence ne compte que si elle tient à la fois contre ses chiffres et contre notre relecture de 2018. Le protocole a été écrit avant le premier article lu ; ses écarts sont consignés11.
L'échantillon de 2026 compte 27 articles de RL appliqué à de grands modèles de langage, 14 de RL classique (contrôle, jeux, robotique) et 9 de théorie, dont 5 sans aucune expérience. Les pourcentages se calculent sur les 45 articles expérimentaux.
| Question | Pineau, 2018 (50 articles) | Notre relecture de 2018 (12 articles) | Notre mesure, 2026 (50 articles) | Verdict |
|---|---|---|---|---|
| L'article a des expériences | 100 % | 11 sur 12 | 90 % [79 ; 96] | ambigu : la théorie est plus présente |
| Il emploie des réseaux de neurones | 90 % | 9 sur 11 | 89 % [77 ; 95] | pas bougé |
| Tous les réglages de la méthode sont donnés | 90 % | 6 sur 10 | 67 % [52 ; 79] | ambigu : notre grille est plus sévère |
| Tous les réglages des références sont donnés | 60 % | 6 sur 11 | 18 % [10 ; 32] | régressé |
| Le code est en lien | 55 % | 6 sur 11 | 67 % [52 ; 79] | pas bougé, tendance à la hausse |
| La méthode de réglage est décrite | 20 % | 2 sur 10 | 27 % [16 ; 41] | pas bougé |
| Une évaluation tenue à part | 10 % | 4 sur 10 | 70 % [56 ; 82] | amélioré |
| Un test de significativité | 5 % | 1 sur 11 | 4 % [1 ; 15] | pas bougé |
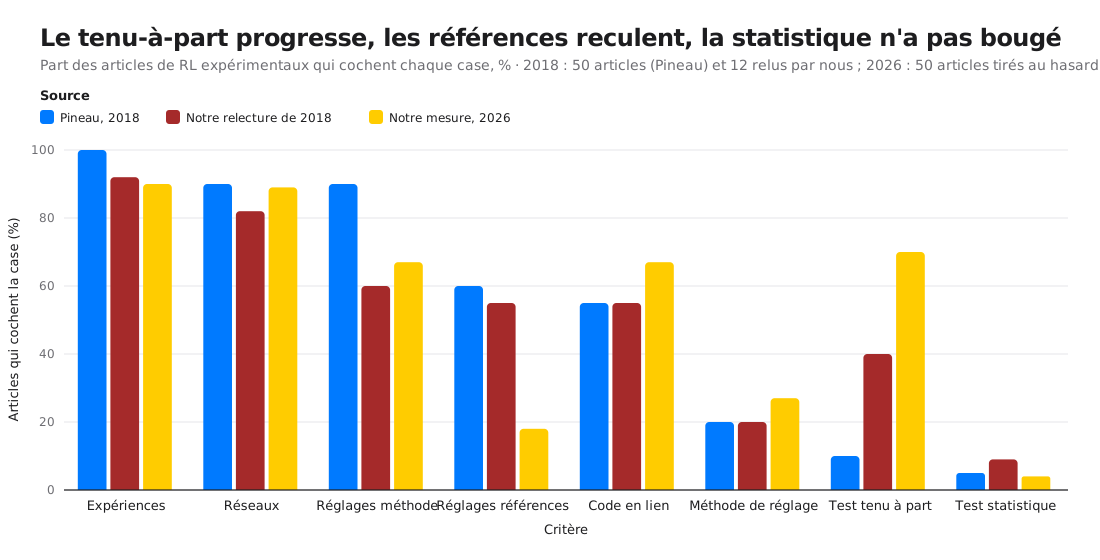
Huit cases, trois lectures. Notre relecture de 2018 sert d'étalon : elle montre où notre grille est plus sévère que celle de Pineau (réglages de la méthode) et où elle est plus indulgente (évaluation tenue à part).
Ce qui s'est amélioré : l'évaluation tenue à part. Sept articles sur dix évaluent désormais l'agent ailleurs que sur ce qui l'a entraîné, contre un sur dix chez Pineau et quatre sur dix dans notre propre relecture de 2018, plus indulgente sur ce point. Le progrès vient surtout du RL sur grands modèles de langage : on l'entraîne sur un jeu de problèmes et on le juge sur des bancs d'essai distincts, 26 articles sur 27. En RL classique, 5 articles sur 13 seulement le font. Le « mythe » de 2018, tester sur l'ensemble d'entraînement, survit là où il est né.
Ce qui a régressé : les réglages des références. En 2018, six articles sur dix donnaient tous les réglages des méthodes auxquelles ils se comparent. En 2026, moins de deux sur dix, 18 %, quand notre relecture de 2018 en trouvait encore six sur onze. Un seul article expérimental sur vingt, 5 %, dit avoir réglé ses références avec le même soin que sa propre méthode. La question de sa diapositive, « à quel point est-on motivé pour régler une référence ? », a aujourd'hui une réponse chiffrée.
Ce qui n'a pas bougé. Le code en lien progresse, de 55 % à 67 %, sans que notre intervalle exclue le chiffre de 2018. Un article sur quatre dit comment il a choisi ses réglages, contre un sur cinq. Le test de significativité reste l'exception : 4 %, deux articles sur quarante-cinq.
Ambigu, voici pourquoi. Les réglages de la méthode passent de 90 % chez Pineau à 67 % chez nous ; mais notre relecture de 2018 donnait 60 %, notre grille exigeant tous les réglages là où elle en acceptait sans doute l'essentiel. L'écart mesure nos lecteurs, pas le domaine. La part d'articles sans expérience augmente, avec la théorie, sans qu'un échantillon de cinquante permette d'en dire plus.
Les questions que nous avons ajoutées, tirées de sa conférence de Vancouver, en disent davantage. Sur les 41 articles de RL expérimentaux, 20 ne disent pas sur combien d'entraînements indépendants reposent leurs résultats principaux ; 4 n'en ont qu'un ; les autres en annoncent cinq en valeur médiane. L'incertitude des résultats est affichée par les 14 articles de RL classique sur 14, mais par 4 articles de RL sur grands modèles sur 27 : la discipline que Pineau réclamait a pris dans son propre domaine, puis s'est perdue en route vers les grands modèles. Parmi ces 27 articles, 15 n'essaient qu'une seule famille de modèles de départ, exactement le piège que l'étude de la récompense aléatoire décrit plus bas. Un sur deux, 47 %, chiffre le calcul consommé. Enfin, la sélection des meilleurs essais se voit encore : un article d'ICLR 2026 publie comme résultat principal un score de 23,00, le meilleur de trois entraînements identiques notés 19,87, 21,58 et 23,00, sans le dire. Il faut lire son tableau de balayage des réglages pour le voir.
Les données, le protocole et ses écarts, les codages article par article avec leurs citations sont en ligne : protocole, résultats et l'archive complète.
Ce qui a changé depuis
Ses avertissements ont été confirmés par d'autres, avec des moyens qu'elle n'avait pas. En 2020, une équipe du MIT a décortiqué PPO et TRPO : l'essentiel de l'avance de PPO venait d'« optimisations au niveau du code » que l'article d'origine traitait comme des détails secondaires12. En 2021, une équipe de Google a entraîné plus de 250 000 agents pour mesurer l'effet de plus de cinquante choix d'implémentation de ce type13. La même année, Rishabh Agarwal et ses coauteurs ont montré que, sur trois à cinq exécutions, les classements publiés sur les jeux Atari s'inversaient souvent quand on les réanalysait avec des intervalles de confiance ; ils ont publié une bibliothèque, rliable, pour faire ce calcul correctement. NeurIPS leur a décerné un prix du meilleur article14.
Pendant ce temps, le RL a trouvé l'emploi qui lui manquait. En janvier 2022, OpenAI décrit InstructGPT : un modèle de langage affiné par RL à partir de préférences humaines, dont la version de 1,3 milliard de paramètres est préférée par les évaluateurs à GPT-3 et ses 175 milliards15. Le 30 novembre 2022 sort ChatGPT, bâti sur la même méthode16. En mars 2025, Andrew Barto et Richard Sutton reçoivent le prix Turing pour avoir posé les fondations conceptuelles et algorithmiques du RL17. En avril, Sutton et David Silver annoncent « l'ère de l'expérience », où les agents apprendraient surtout de leurs propres essais18.
Le tournant décisif date de janvier 2025. DeepSeek publie R1, dont la version R1-Zero apprend à raisonner sur des problèmes de mathématiques par RL seul, sans exemples de raisonnement écrits par des humains. La récompense est vérifiable : la réponse finale est juste ou fausse, un programme le contrôle. L'article, publié dans Nature en septembre 2025 après relecture, rapporte un taux de réussite au premier essai qui passe de 15,6 % à 77,9 % au concours AIME 2024. Il chiffre aussi le coût de l'étape de RL : 294 000 dollars de calcul, sans compter l'entraînement du modèle de départ19.
Les mêmes pièges, en plus gros
Le RL de 2025 ne part plus de zéro. Il affine un modèle de langage qui sait déjà beaucoup de choses. Deux études de 2025 posent alors la question de 2018 sous une forme nouvelle : qu'apprend-il vraiment ?
La première, de Yang Yue et ses coauteurs à l'université Tsinghua, présentée en séance plénière à NeurIPS 2025, compare un modèle avant et après RL à récompense vérifiable. Elle mesure le pass@k, la part des problèmes résolus en au plus k tentatives. Pour une seule tentative, le modèle entraîné gagne nettement. Quand on laisse au modèle de base des centaines de tentatives, il résout autant de problèmes, voire davantage. Les auteurs concluent que les raisonnements trouvés après RL étaient déjà dans le modèle de base : le RL apprend à les sortir du premier coup, sans en ajouter de nouveaux. La distillation, qui fait imiter un modèle plus fort, en ajoute20.
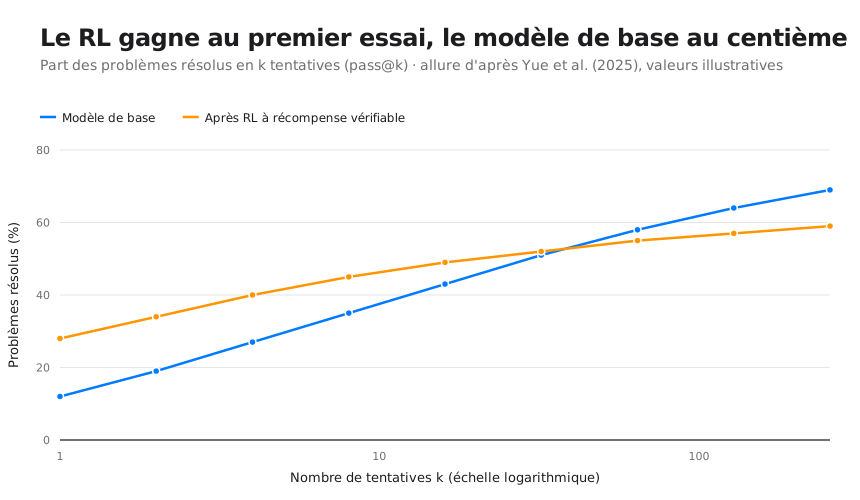
Le RL resserre ce que le modèle sait déjà : il gagne au premier essai, le modèle de base le rattrape quand on lui laisse le temps. Allure d'après Yue et al. (2025) ; valeurs illustratives.
La seconde, signée Rulin Shao et ses coauteurs à l'université de Washington, est la plus proche de la diapositive de Vancouver21. Sur le modèle Qwen2.5-Math-7B, le RL avec la vraie récompense fait gagner 29,1 points sur le banc d'essai MATH-500. Avec une récompense qui félicite les réponses fausses, 24,1 points. Avec une récompense tirée au hasard, sans aucun rapport avec la justesse de la réponse, 21,4 points.
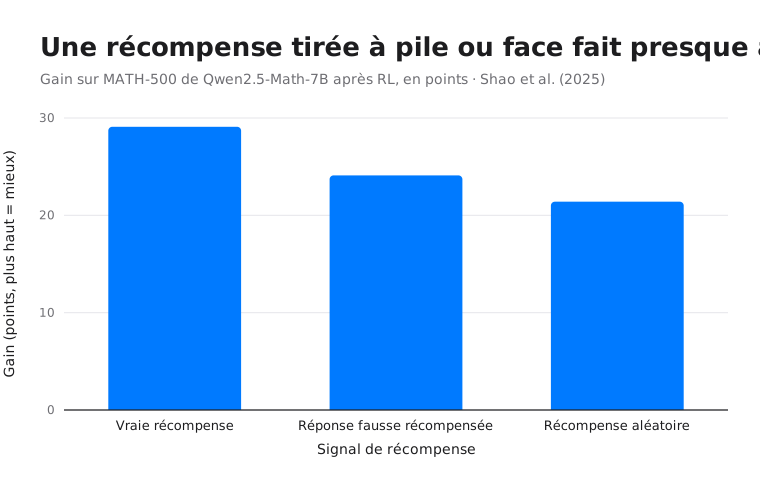
Sur Qwen2.5-Math-7B, une récompense aléatoire donne près des trois quarts du gain de la vraie. D'après Shao et al. (2025).
L'explication vient d'une particularité de l'algorithme d'entraînement, qui amplifie un comportement déjà présent dans ce modèle : écrire son raisonnement sous forme de code, sans l'exécuter. Cette habitude passe de 65 % à plus de 90 % des réponses ; elle se trouve payer sur ce banc d'essai. Le même traitement ne donne presque rien, ou fait baisser le score, sur les familles Llama et OLMo. Les auteurs recommandent de valider toute méthode de RL sur plusieurs familles de modèles plutôt que sur le seul modèle que tout le monde emploie. En 2018, le piège s'appelait la graine ; en 2025, il s'appelle aussi le modèle de départ.
Le bruit n'a pas disparu non plus. Une équipe emmenée par l'université de Tübingen a relancé en 2025 les évaluations de neuf modèles de raisonnement avec vingt graines : sur le concours AIME 2024, l'écart type du score au premier essai va de 5 à 15 points d'une graine à l'autre ; une seule question de plus ou de moins déplace le score de 3,3 points sur trente. Plusieurs gains annoncés par RL tombaient dans cette marge22. Le coût a changé d'échelle : une étude de 2025 sur la manière de faire croître le RL des grands modèles a consommé plus de 400 000 heures de processeur graphique23. Dix graines, à ce prix, deviennent un poste de budget.
Andrej Karpathy, cofondateur d'OpenAI, a résumé l'état des lieux en octobre 2025 : « L'apprentissage par renforcement est terrible. Il se trouve simplement que tout ce que nous avions avant est bien pire. » Il décrit l'agent qui travaille une minute entière pour recevoir une seule note à la fin, appliquée ensuite à chacune de ses actions, les bonnes comme les mauvaises : « on aspire la supervision à travers une paille »24.
Joelle Pineau a dirigé ensuite la recherche fondamentale en intelligence artificielle de Meta. Elle l'a quittée au printemps 2025 ; en août, la société canadienne Cohere l'a nommée directrice de l'intelligence artificielle, basée à Montréal25. Elle reste professeure à McGill.
Joelle Pineau à la conférence All In de Montréal, le 25 septembre 2025, peu après son arrivée chez Cohere. Photo Gabriel Hutchinson, licence CC BY-SA 4.0, via Wikimedia Commons.
Faut-il se mettre au RL ?
Ma réponse a changé de forme depuis 2018, pas de fond. Le RL est un outil coûteux, puissant, capricieux, qui paie dans des conditions précises. Je les vérifie dans cet ordre.
Un environnement qui coûte presque rien. Le RL apprend en essayant des millions de fois. Il lui faut un simulateur, un jeu, un vérificateur automatique, quelque chose qu'on relance sans frais ni danger. Un robot réel, un patient, un client ne se relancent pas un million de fois. Sans simulateur fidèle, le RL reste une idée.
Une récompense qu'on vérifie sans se tromper. Le succès de 2025 vient de récompenses qu'un programme contrôle : la réponse du problème de mathématiques est juste, le code passe ses tests. Dès que la récompense devient une approximation, une note donnée par un autre modèle, un indicateur métier qu'on espère lié au but, l'agent apprend à faire monter l'indicateur, qui se détache alors du but. L'expérience de la récompense aléatoire rappelle qu'un gain mesuré ne prouve pas que la récompense a servi.
Le budget de dix graines et d'une référence bien réglée. Si l'on ne peut pas lancer dix fois chaque configuration, comparer à une référence réglée avec le même soin et le même budget, on ne saura pas si l'on a gagné. Dans ce cas, je commence par la méthode la plus simple qui marche : de l'apprentissage supervisé, de la distillation d'un modèle plus fort, de meilleures données. C'est presque toujours là que je finis.
Quand les trois conditions sont réunies, j'y vais sans état d'âme : c'est ce qu'ont fait les équipes qui entraînent aujourd'hui des modèles à raisonner ou à coder, avec des vérificateurs automatiques et des budgets de calcul à la hauteur. Quand il en manque une, je n'y vais pas. Je l'explique alors au client avec la diapositive de Vancouver.
La grille pour lire une annonce de RL
Quand on me montre un article, un communiqué ou une démonstration de RL, je pose sept questions. Aucune ne demande de savoir programmer.
- Combien de graines ? Moins de cinq, je n'en tire rien ; « les meilleurs essais », je referme le document.
- Quel intervalle ? Une moyenne sans dispersion ne dit rien ; je veux un intervalle de confiance ou au moins une bande sur la courbe.
- Quelle référence, réglée comment ? Si la méthode nouvelle a eu un mois de réglages et la référence ses valeurs par défaut, l'écart mesure le mois.
- Sur combien de tâches, ou de familles de modèles ? Une seule tâche, un seul modèle de départ : le résultat vaut pour ce couple-là.
- Testé où ? Sur la tâche d'entraînement, l'agent a peut-être appris par cœur ; je veux une évaluation sur des situations qu'il n'a pas vues.
- Quel code ? Sans code publié, je ne sais pas ce que l'article a vraiment fait ; les détails décisifs n'y sont presque jamais.
- Quel coût ? Les heures de calcul, en clair. Un résultat qu'on ne peut pas se payer ne se reproduit pas.
La graine
Je ne me suis toujours pas mis au RL. Je me suis mis, depuis ce matin de mai 2018, à poser à chaque résultat la question qu'elle posait à ses étudiants : as-tu interrogé tes bons résultats autant que tes mauvais ? Elle vaut pour le RL, pour l'apprentissage supervisé, pour mes propres courbes. Le RL a seulement l'honnêteté de rendre le problème visible : ses graines font des écarts assez grands pour qu'on ne puisse plus les ignorer.
Les deux courbes de Vancouver avaient le même code. Elles n'avaient pas la même graine. La science expérimentale de ce domaine se joue dans ce que l'on fait de cet écart : le publier comme une découverte, ou le mesurer comme du bruit.
Bibliographie
Chaque titre ci-dessous a servi à écrire une section précise ; la notice dit laquelle. La vidéo de la conférence de Vancouver est en ligne sur YouTube ; les diapositives de sa reprise à NeurIPS 2018 sont publiées par la conférence.
- Tesauro, G. (1995). Temporal Difference Learning and TD-Gammon. Communications of the ACM, 38(3), p. 58-68. bkgm.com TD-Gammon, le joueur de backgammon entraîné en jouant contre lui-même : pendant vingt ans, le résultat que le RL citait faute de mieux.
- Silver, D., Huang, A., Maddison, C. J. et al. (2016). Mastering the game of Go with deep neural networks and tree search. Nature, 529, p. 484-489. nature.com AlphaGo, le résultat qui a remplacé TD-Gammon dans les conférences ; Pineau regrettait qu'il ne livre pas de plan pour le refaire.
- Irpan, A. (2018). Deep Reinforcement Learning Doesn't Work Yet. Billet de blog, 14 février 2018. alexirpan.com Le soupçon d'un praticien, cité par Pineau dans sa reprise de NeurIPS : « au moins 70 % du temps ».
- Pineau, J. (2018). Reproducibility, Reusability, and Robustness in Deep Reinforcement Learning. Conférence invitée, ICLR 2018, Vancouver, 3 mai 2018. iclr.cc La conférence elle-même, dont la vidéo et les diapositives sont la source principale de l'article.
- Bollen, K., Cacioppo, J. T., Kaplan, R. M. et al. (2015). Social, Behavioral, and Economic Sciences Perspectives on Robust and Reliable Science. Rapport à la National Science Foundation. Copie hébergée par Harvard La définition de la reproductibilité qui ouvre la conférence.
- Baker, M. (2016). 1,500 scientists lift the lid on reproducibility. Nature, 533, p. 452-454. nature.com Le sondage de 1 576 chercheurs : 52 % de crise significative, 38 % de crise légère. Pineau dit « 50 % » à l'oral ; sa diapositive dit 52 %.
- Buckheit, J. B. et Donoho, D. L. (1995). WaveLab and Reproducible Research. Dans Wavelets and Statistics, Springer, p. 55-81. doi.org La phrase sur l'article qui n'est que la publicité de la recherche, reprise de Jon Claerbout.
- Henderson, P., Islam, R., Bachman, P., Pineau, J., Precup, D. et Meger, D. (2018). Deep Reinforcement Learning that Matters. AAAI 2018. arxiv.org La source écrite des diapositives : le classement par tâche (tableau 3), les trois implémentations de TRPO et de DDPG, les deux groupes de cinq graines (figure 5, t = −9,09, p = 0,0016) et le nombre d'essais des articles publiés.
- Pineau, J., Vincent-Lamarre, P., Sinha, K. et al. (2021). Improving Reproducibility in Machine Learning Research (A Report from the NeurIPS 2019 Reproducibility Program). Journal of Machine Learning Research, 22(164), p. 1-20. jmlr.org Le bilan des défis de reproduction (123 articles réclamés en 2018) et de la liste de contrôle : le code fourni passe de moins de 50 % à 74,4 % des articles acceptés.
- Pineau, J. (2018). Reproducible, Reusable, and Robust Reinforcement Learning. Conférence invitée, NeurIPS 2018, Montréal, 5 décembre 2018. Diapositives La reprise de Montréal : la diapositive des deux graines avec sa réponse écrite, la grille des cinquante articles de 2018 et la première liste de contrôle.
- Harchaoui, W. (2026). Remesurer Pineau : la grille de 2018 réappliquée à 50 articles de RL de 2025-2026. Protocole, données et codages, 8 novembre 2026. deraison.ai Notre remesure : tirage, grille, calibration sur douze articles de 2018, double lecture, écarts au protocole.
- Engstrom, L., Ilyas, A., Santurkar, S. et al. (2020). Implementation Matters in Deep Policy Gradients: A Case Study on PPO and TRPO. ICLR 2020. arxiv.org Les « optimisations au niveau du code » qui expliquent l'essentiel de l'avance de PPO sur TRPO.
- Andrychowicz, M., Raichuk, A., Stańczyk, P. et al. (2021). What Matters In On-Policy Reinforcement Learning? A Large-Scale Empirical Study. ICLR 2021. arxiv.org Plus de 250 000 agents pour mesurer l'effet de plus de cinquante choix d'implémentation.
- Agarwal, R., Schwarzer, M., Castro, P. S., Courville, A. et Bellemare, M. G. (2021). Deep Reinforcement Learning at the Edge of the Statistical Precipice. NeurIPS 2021, prix de l'article remarquable. arxiv.org Sur trois à cinq exécutions, des classements qui s'inversent ; les intervalles de confiance et la bibliothèque rliable.
- Ouyang, L., Wu, J., Jiang, X. et al. (2022). Training language models to follow instructions with human feedback. arxiv.org InstructGPT : le RL à partir de préférences humaines ; le modèle de 1,3 milliard de paramètres préféré à GPT-3.
- OpenAI (2022). Introducing ChatGPT. 30 novembre 2022. openai.com La sortie de ChatGPT, entraîné par la même méthode.
- Association for Computing Machinery (2025). ACM A.M. Turing Award Honors Two Researchers Who Led the Development of Cornerstone AI Technology. 5 mars 2025. acm.org Le prix Turing 2024 de Barto et Sutton.
- Silver, D. et Sutton, R. S. (2025). Welcome to the Era of Experience. Chapitre à paraître dans Designing an Intelligence, MIT Press. storage.googleapis.com L'ère de l'expérience : des agents qui apprennent surtout de leurs propres essais.
- DeepSeek-AI (2025). DeepSeek-R1 incentivizes reasoning in LLMs through reinforcement learning. Nature, 645, p. 633-638. nature.com R1-Zero : de 15,6 % à 77,9 % au premier essai sur AIME 2024 (71,0 % dans la version de janvier 2025) ; 294 000 dollars pour l'étape de RL.
- Yue, Y., Chen, Z., Lu, R. et al. (2025). Does Reinforcement Learning Really Incentivize Reasoning Capacity in LLMs Beyond the Base Model? NeurIPS 2025. arxiv.org Le pass@k : le modèle de base rattrape le modèle entraîné quand on lui laisse assez de tentatives ; la distillation, elle, ajoute.
- Shao, R., Li, S. S., Xin, R. et al. (2025). Spurious Rewards: Rethinking Training Signals in RLVR. ICML 2026. arxiv.org La récompense aléatoire qui fait gagner 21,4 points à Qwen2.5-Math-7B mais presque rien à Llama ou OLMo.
- Hochlehnert, A., Bhatnagar, H., Udandarao, V. et al. (2025). A Sober Look at Progress in Language Model Reasoning: Pitfalls and Paths to Reproducibility. arxiv.org Vingt graines, neuf modèles : 5 à 15 points d'écart type sur AIME 2024.
- Khatri, D., Madaan, L., Tiwari, R. et al. (2025). The Art of Scaling Reinforcement Learning Compute for LLMs. arxiv.org Plus de 400 000 heures de processeur graphique pour étudier la croissance du RL.
- Patel, D. et Karpathy, A. (2025). Andrej Karpathy: AGI is still a decade away. Dwarkesh Podcast, 17 octobre 2025. dwarkesh.com « Reinforcement learning is terrible » et la supervision aspirée à travers une paille.
- Zeff, M. (2025). Cohere hires long-time Meta research head Joelle Pineau as its chief AI officer. TechCrunch, 14 août 2025. techcrunch.com L'arrivée de Joelle Pineau chez Cohere après son départ de Meta.