Prenons une boutique en ligne qui veut ranger ses clients en groupes qui se ressemblent : les chasseurs de promotions, les fidèles du dimanche, les gros paniers. Un algorithme nommé k-means sait faire ce tri, à une condition : qu'on lui dise d'avance combien de groupes former. Deux groupes ? Le tri reste grossier. Dix ? Les groupes rétrécissent jusqu'à ne plus rien vouloir dire. Le bon nombre est quelque part entre les deux.
Une courbe va le désigner. À l'horizontale, le nombre de groupes essayé. À la verticale, une mesure du désordre qui reste à l'intérieur des groupes. La courbe plonge d'abord, parce que chaque groupe ajouté absorbe beaucoup de désordre, puis elle s'aplatit, parce que les groupes supplémentaires n'apportent presque plus rien. On retrouve cette silhouette de rendements décroissants quand on se demande à quel moment arrêter d'entraîner un modèle, ou à partir de quel budget une campagne publicitaire sature. Le point où la courbe cesse de payer a reçu un nom d'anatomie : le coude1. Avant lui, chaque unité investie rapporte. Après lui, on s'obstine.
Trouver ce point paraît facile. Pourtant, un détecteur de coude répond toujours quelque chose. Donnez-lui une droite parfaite, il vous rend un coude. Donnez-lui du bruit pur, il vous en rend encore un.
elbow-helper pose des questions plus dures. Ce coude est-il net ? Est-il unique ? Reste-t-il au même endroit quand on lisse un peu la courbe ? Revient-il si on rejoue le calcul ? Et surtout : une courbe sans aucun coude aurait-elle pu donner la même chose par hasard ? Une seule mauvaise réponse suffit : l'outil s'abstient en disant pourquoi. Essayez pendant que vous lisez : à deraison.ai/elbow-helper, collez une courbe dans votre navigateur et la réponse arrive avec ses preuves bien avant la fin de cet article.
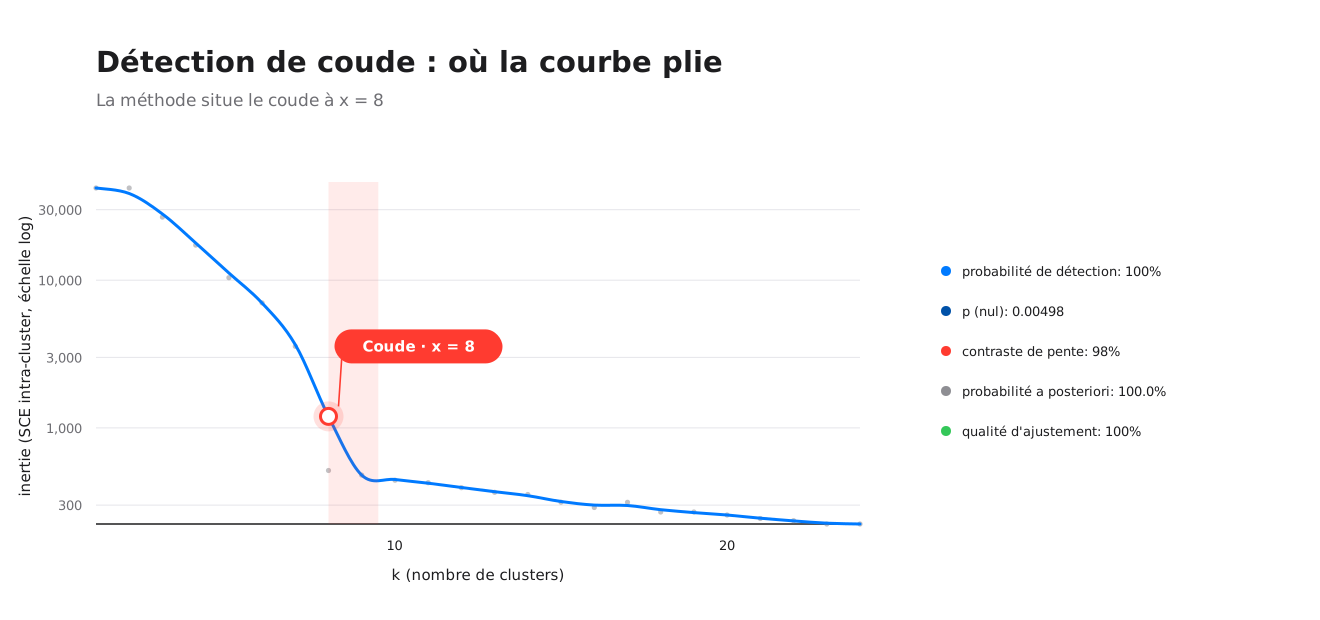
Le cas classique : une courbe d'inertie de k-means, avec le nombre de groupes à l'horizontale. Le k-means range des points en un nombre de groupes fixé d'avance. Son inertie est la somme des distances de chaque point au centre de son groupe. On lit le coude détecté, son intervalle bootstrap (expliqué plus bas) et, à côté, les preuves chiffrées.
Un point sans marge d'erreur
Proposer un emplacement, les méthodes existantes le font très bien, à commencer par l'algorithme Kneedle qui fait référence2. Mais elles ne disent jamais à quel point elles y croient : elles rendent un point, sans marge d'erreur, sans probabilité, sans droit de se taire. Sur une courbe bruitée, ce point isolé invite à la surinterprétation. On choisit quatre groupes, on dimensionne la mémoire rapide d'un système, on arrête une expérience. Trois décisions posées sur un accident du bruit.
Devant un cliché flou, un radiologue s'abstient de diagnostiquer. Il écrit que l'examen ne permet pas de conclure, puis il en demande un autre. Un programme statistique gagne à montrer la même retenue devant une courbe bruitée et à conclure seulement ce que les données permettent. Le radiologue, lui, exerce un jugement. Le programme applique des seuils fixés une fois pour toutes : il y gagne en prévisibilité et y perd en finesse.
elbow-helper s'est donc fixé une priorité : éviter les faux coudes, quitte à se taire plus souvent. Le programme qui l'appelle reçoit l'une de deux réponses et aucune autre, un ClearKnee (« coude net ») ou un NoClearKnee (« pas de coude net »). Le coude net arrive avec sa position, sa fourchette et ses preuves chiffrées. La fourchette est censée enfermer la vraie position dans environ neuf cas sur dix. À ce jour, seule la famille de courbes de test le confirme. Le refus arrive avec un code lisible par une machine, qui dit pourquoi l'outil s'est tu. L'outil s'interdit tout repli discret vers une estimation douteuse : l'abstention est une réponse que le programme appelant traite sans pouvoir la contourner.
Les outils déjà disponibles se rangent en trois groupes :
- Les chercheurs de coude :
kneed3,kneebow4, le visualiseur de Yellowbrick5. Ils répondent toujours par un point, sans jamais savoir dire « il n'y a rien ici ». - Les bibliothèques de détection de ruptures,
ruptures6 en tête. Elles sont excellentes, mais elles répondent à une autre question : combien de ruptures dans un signal ? Elles ne regardent jamais si les rendements diminuent. - Le jugement laissé à un humain qui regarde ou à un modèle de langage. Ce jugement ne se reproduit pas.
Le parent le plus proche d'elbow-helper échappe à ces trois groupes : le paquet segmented7 du langage R part de la même idée. Annoncer un coude, c'est annoncer aussi à quel point on en est sûr. Se taire quand la preuve manque reste pourtant rare, chez lui comme dans les trois groupes. C'est l'apport principal d'elbow-helper. La comparaison est chiffrée : le tableau de notes et la carte qui en résume les onze critères attendent plus bas, juste avant les limites de l'outil.
Huit versions, de v0.1.0 à v0.1.7, sont publiées sur PyPI, l'entrepôt public où pip install va chercher les bibliothèques Python. Tout envoi de code est refusé tant que les 85 tests automatiques échouent sur Python 3.12 ou que le vérificateur de style proteste. Chaque semaine, la même série de tests est rejouée sur les quatre versions de Python prises en charge, de 3.10 à 3.13. À eux seuls, ces 85 tests couvrent 96 % des lignes du paquet.
Une note de mathématiques composée en LaTeX démontre chaque formule du paquet avec un exemple travaillé : ELBOW.pdf, complétée par LIKELIHOOD.pdf. Ces documents existent en français comme en anglais et restent à jour avec le code.
De la courbe brute au candidat
Première étape, le ménage. Les points invalides sont écartés, les abscisses sont triées et dédoublonnées, les deux échelles sont ramenées entre 0 et 1. Pour cette mise à l'échelle, on se cale sur le 5e et le 95e centile au lieu du point le plus bas et du point le plus haut. Le 5e centile désigne la valeur sous laquelle tombent 5 % des points, le 95e celle sous laquelle il en tombe 95 %. Un point aberrant, si extravagant soit-il, n'écrase donc plus toute la courbe contre le bord.
Vient un premier examen de forme. La courbe monte-t-elle ou descend-elle sans jamais changer de sens ? On la dit alors monotone. La corrélation de Spearman8 répond à cette question en regardant l'ordre des valeurs, sans s'occuper de leur taille. Un second contrôle regarde les écarts et confirme le verdict. Une courbe sans tendance nette est écartée sur-le-champ, avant qu'on cherche le moindre coude.
Le sens de la courbe, le programme le lit tout seul dans le signe de la tendance, sauf si vous voulez l'imposer. Creuse ou bombée ? Il tend une corde entre le premier et le dernier point, puis il regarde de quel côté passe la courbe. Au-dessus de la corde, c'est un dôme. En dessous, c'est un bol. Les quatre cas possibles (bombée ou creuse, montante ou descendante) sont ainsi couverts sans que vous ayez à nommer la forme. Si vous la donnez quand même, la vôtre gagne.
La courbe est propre, son sens est connu. Que cherche-t-on au juste ? Prenez une courbe en racine carrée, qui monte vite puis se calme. Tracez la droite qui joint ses deux extrémités, puis soustrayez-la de la courbe. Il reste une bosse, nulle au départ et à l'arrivée, la plus haute là où la courbe s'écarte le plus de cette droite. Le sommet de la bosse est le coude. Une fois les données ramenées entre 0 et 1, la droite qui joint les extrémités devient la diagonale, celle où la hauteur égale la position horizontale. La soustraire revient donc à retirer à chaque point sa propre abscisse :
Les maxima locaux de cette différence, les points plus hauts que leurs voisins immédiats, sont les candidats. Un seuil de sensibilité décide ensuite si un sommet mérite le nom de coude ou s'il s'agit d'une simple ondulation. Le candidat doit dominer son voisinage d'une marge proportionnelle à un paramètre \(S\). La barre à franchir se note T :
On part de la hauteur du sommet et on retire une marge : le paramètre de sensibilité multiplié par l'écart moyen entre deux abscisses voisines. Augmentez \(S\) : la marge s'élargit, le sommet doit dominer de plus haut. On rejoue ensuite toute cette recherche sur une grille de lissages et de sensibilités. Un candidat qui change de place d'un réglage à l'autre est éliminé. Un vrai coude résiste quand on floute un peu la courbe. Un accident de bruit disparaît.
Cette recherche de sommets a des auteurs : c'est l'algorithme Kneedle2, décrit par Satopää, Albrecht, Irwin et Raghavan en 2011. Il est réécrit ici de zéro en NumPy. La façon de parcourir la courbe, la table des orientations et le seuil de sensibilité suivent de près la bibliothèque kneed de Kevin Arvai3. Elle est sous licence BSD et créditée dans le dépôt. elbow-helper tourne sans elle. Son apport vient ensuite, avec ce qu'il exige d'un candidat avant de l'appeler un coude.
Première exigence : la pente doit changer assez nettement pour que trois points aberrants n'aient pas pu fabriquer ce changement. Un estimateur de Theil-Sen9 mesure ce changement. La méthode habituelle, les moindres carrés, cherche la droite qui rend la somme des carrés des écarts la plus petite possible. Une valeur folle y pèse donc très lourd, puisque son écart est élevé au carré. Theil-Sen procède autrement : il calcule la pente de toutes les paires de points, puis il prend la valeur du milieu, la médiane. Quelques points fous auront beau hurler, la médiane ne les entend pas.
Écrivons maintenant le modèle. Un vrai coude casse la pente : une droite jusqu'au point \(k\), une autre pente ensuite. Il faut une ligne brisée d'un seul morceau, sans saut. Une fonction fait l'affaire, nulle avant \(k\), qui monte tout droit après :
Les lettres a et b décrivent une droite ordinaire, sa hauteur de départ et sa pente. Le terme avec le max vaut zéro tant qu'on n'a pas atteint la cassure, puis grandit régulièrement. Tout se joue dans le coefficient \(c\) : après la cassure, la pente devient b plus \(c\). S'il vaut zéro, on retombe sur une droite sans coude. Plus \(c\) s'éloigne de zéro, plus la pente casse fort en \(k\).
La ligne brisée affronte alors la simple droite sur deux terrains. Sur le premier, la validation croisée par blocs10, on cache une partie de la courbe, puis on regarde si le modèle devine ce qu'on lui a caché. On enlève des tronçons entiers au lieu de points isolés, parce qu'un point isolé se devine bien trop facilement d'après ses voisins. Sur le second, un score compare les deux modèles en tenant compte de leur complexité. Pour le construire, il faut d'abord dire ce que « mieux ajusté » veut dire.
Mesurer la surprise : la vraisemblance
Supposons le modèle vrai. S'il colle bien aux données, ce qu'on observe n'a rien de surprenant : c'est l'idée de vraisemblance. Pour la calculer, il faut se donner un modèle du hasard. Les points observés tombent toujours un peu à côté de la courbe théorique. Leur écart est un bruit gaussien, le hasard en courbe en cloche que produisent de petites erreurs qui s'additionnent. On tire chaque écart sans regarder les autres, avec une taille typique notée \(\sigma\). Chaque observation reçoit alors une densité de probabilité, un nombre qui dit à quel point cette valeur était attendue. Un point tombé tout près de la courbe proposée reçoit un grand nombre, un point tombé loin un petit.
Les manuels multiplient ces nombres entre eux, sur les \(n\) points. Ce produit pose un problème pratique : multiplier \(n\) nombres tous inférieurs à un donne un résultat qui s'effondre à toute vitesse quand \(n\) grandit. Prenons 0,9. Multiplié 80 fois par lui-même, il donne environ deux dix-millièmes. Multiplié 800 fois, il donne un nombre qui compte trente-six zéros après la virgule avant son premier chiffre significatif. Comment comparer alors une courbe de 80 points et une courbe de 800 ?
elbow-helper prend donc la vraisemblance par observation : on multiplie les \(n\) nombres, puis on prend la racine \(n\)-ième du résultat, ce qui revient à une moyenne. Le nombre de points cesse ainsi de peser. Dans la formule qui suit, θ désigne les réglages du modèle, σ² le carré de la taille typique du bruit, p la densité de chaque point et E une moyenne sur tous les points :
Les deux écritures disent la même chose : moyenner les logarithmes des densités puis revenir par l'exponentielle revient à prendre cette racine de la vraisemblance brute. Avec un bruit en cloche, tout se simplifie d'un coup. Il ne reste que l'erreur quadratique moyenne (EQM), la moyenne des carrés des écarts entre les points observés et la courbe ajustée :
Le premier facteur dépend seulement du bruit. L'exponentielle dépend de l'ajustement et baisse quand l'EQM monte. Prenons le logarithme népérien, qui défait cette exponentielle sans reste.
Regardez cette ligne. Le premier terme ignore tout des réglages du modèle. Le second contient l'EQM avec un signe moins. À bruit fixé, rendre l'erreur quadratique moyenne la plus petite possible revient donc à rendre la vraisemblance la plus grande possible. On apprend les moindres carrés comme une recette géométrique. On apprend le maximum de vraisemblance comme un principe statistique. Les deux sont une seule et même opération, vue de deux côtés !
Rapportée à l'échantillon entier, avec la taille du bruit estimée par l'EQM elle-même, cette log-vraisemblance se simplifie. Multipliée par moins deux, elle devient \(n\) fois le logarithme de l'EQM, plus une constante. C'est le terme d'ajustement de tous les critères qui suivent. La note mathématique ELBOW.pdf fait ce pont pas à pas. Comparer deux modèles sur ce seul ajustement serait truqué d'avance : un modèle qui a plus de réglages colle toujours mieux aux données, jusqu'à épouser le bruit lui-même. Il faut donc faire payer les réglages. Les critères de la famille du BIC (Bayesian Information Criterion)11 partent de la vraisemblance et y ajoutent une pénalité proportionnelle au nombre de réglages dépensés. Le coude coûte des réglages. Il doit les rembourser en ajustement, sinon la simple droite l'emporte.
Comment rendre tout cela lisible pour un humain ? Le réflexe serait le \(R^2\), le score d'ajustement des manuels. Il met en regard l'erreur du modèle et celle d'un élève paresseux qui répondrait toujours la moyenne des observations. Il vaut 1 pour un ajustement parfait, 0 pour « pas mieux que de répondre la moyenne ». Le problème vient de ce que la moyenne minimise l'erreur : parmi les réponses bêtes, elle est le meilleur adversaire possible. Battu par l'élève paresseux, un \(R^2\) passe sous zéro. elbow-helper choisit un adversaire franchement mauvais : le point observé d'où il est le plus difficile de prédire tous les autres.
Pour chaque valeur observée, on calcule l'erreur moyenne qu'on ferait en la répondant partout. La valeur qui produit la plus grande erreur devient la référence. La qualité compare notre erreur à la sienne. Elle vaut 1 pour un ajustement parfait et 0 pour un ajustement aussi mauvais que cette pire valeur fixe. Comme cette référence est toujours plus mauvaise que la moyenne, tomber sous zéro devient beaucoup plus difficile qu'avec un \(R^2\).
Ce nombre s'affiche dans la légende de la figure, avec trois autres. S'y ajoutent la probabilité de détection, la valeur \(p\) de la section suivante et un poids qui compare les deux modèles. Ce poids est la cote entre le modèle à coude et la simple droite, calculée à partir de l'écart de BIC12. Cette cote vaut seulement quand on dispose de beaucoup d'observations. Pour y voir une probabilité, il faudrait d'abord décider quelle confiance on accorde à chacun des deux modèles. Les données d'ici n'en disent rien. On la prend donc pour ce qu'elle est, un poids qui compare deux modèles.
Deux épreuves contre le hasard
Un modèle peut gagner ce duel sur les données qu'on a et n'être qu'un caprice du bruit. Deux épreuves s'en assurent. La première s'appelle le bootstrap13, d'après une expression anglaise : se hisser en tirant sur ses propres lacets. Vous n'avez qu'un jeu de données ? Fabriquez-en d'autres à partir de lui. Ôtez de la courbe le modèle ajusté : il reste les écarts. Battez ces écarts comme un jeu de cartes, puis recollez-les sur le modèle. Chaque copie ressemble à ce qu'on aurait observé si le hasard avait tiré autrement. La recherche complète repart sur chacune. Verdict : le coude doit revenir au même endroit dans au moins 90 % des copies, avec une fourchette serrée.
La seconde épreuve, le test de la droite pure, attaque le problème par l'autre côté. On simule deux cents droites affectées du même niveau de bruit, mille pour un réglage de validation. Puis on compte combien de fois le hasard seul produit une preuve aussi forte que celle qu'on a observée.
Ce nombre s'appelle la valeur \(p\). C'est l'une des quantités les plus mal lues de la statistique. Il ne dit pas la probabilité qu'il n'y ait pas de coude. Il dit l'inverse : en supposant qu'il n'y en ait aucun, à quelle fréquence le hasard seul fabriquerait-il une preuve aussi convaincante ? Prenez une valeur \(p\) de 0,01 : une droite pure y arrive une fois sur cent. C'est peu, donc on garde le coude. Ce n'est pas zéro : sur cent courbes sans aucun coude, une passerait quand même cette barre.
Pourquoi passer par la simulation ? Parce que s'il n'y a pas de coude, sa position n'existe pas. Les tests classiques perdent alors la référence sur laquelle ils s'appuient d'habitude14. Les deux barres doivent donc être franchies :
À gauche, la part des copies où le coude revient, au moins 90 %. À droite, la fréquence à laquelle une droite sans coude fait aussi bien, au plus 1 %. Seul un candidat qui franchit toutes ces barrières devient un ClearKnee. Ce dossier de preuves s'affiche à côté de la courbe, sur la figure de diagnostic. En cas d'abstention, elle passe à un état de refus : courbe grisée, raison affichée, marqueur absent pour ne pas laisser croire à plus de certitude qu'il n'y en a.
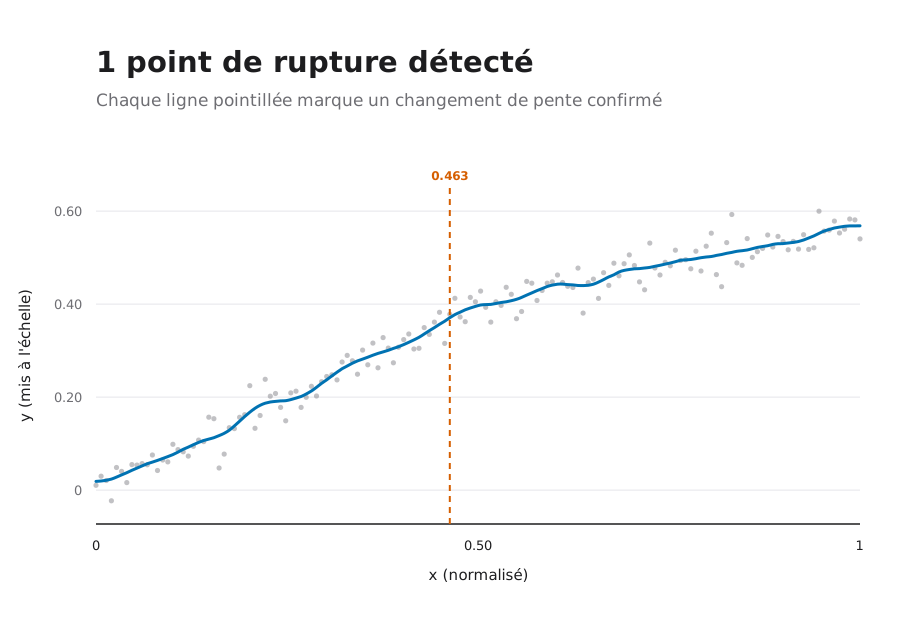
Bruit faible. La ligne pointillée marque le changement de pente confirmé, en x = 0,463. La vraie cassure est en 0,5 : l'écart mesure la discrétisation, puisque l'outil répond par l'un des points fournis.
La figure suivante reprend la même courbe, avec la même cassure en dessous. Seul le bruit a grossi.
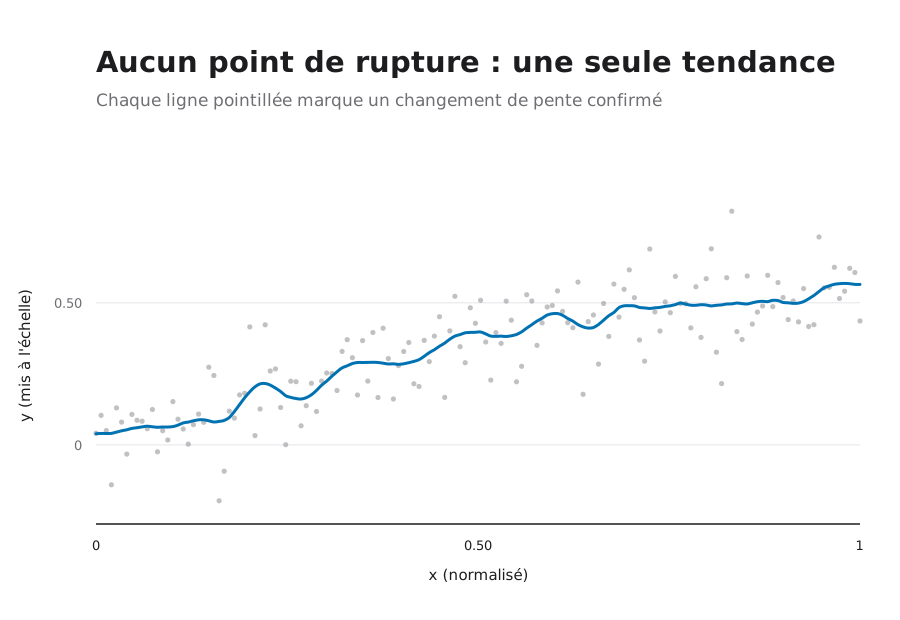
La même forme sous un bruit fort. La cassure n'est pas confirmée, donc la figure ne trace aucun repère : l'abstention se voit d'un coup d'œil.
Un code pour chaque refus
S'abstenir est une réponse à part entière, qui a un nom et n'a rien d'un échec silencieux. La fonction rend toujours l'un de deux objets, jamais autre chose, de sorte que le programme qui l'appelle est obligé de regarder lequel avant de continuer. Voici ces deux réponses telles qu'elles s'affichent, sur la même courbe à deux niveaux de bruit :
>>> from elbow_helper import robust_knee

>>> robust_knee(x, y)            # bruit d'écart-type 0,02
ClearKnee(knee_x=0.3038, ci90=(0.3038, 0.3418), detection_rate=0.98, null_p=0.00498)

>>> robust_knee(x, y_bruite)     # même coude, bruit dix fois plus fort
NoClearKnee(reason='INCOMPATIBLE_GLOBAL_SHAPE')
La première réponse se lit sans documentation : coude en 0,304, fourchette de 0,304 à 0,342, coude retrouvé dans 98 % des copies, probabilité de cinq pour mille qu'une droite sans coude fasse aussi bien. La seconde se tait sur la position. Elle le fait exprès : à ce niveau de bruit, la courbe ne passe même plus l'examen de forme, sa tendance n'étant plus assez nette.
Chaque refus reçoit un code stable, lisible par une machine comme par un humain. Ces codes forment une liste arrêtée d'avance, quinze motifs et pas un de plus. Un tableau de bord peut donc compter ses abstentions et savoir si ses courbes sont trop courtes, trop bruitées ou simplement ambiguës.
| Code renvoyé | Ce qu'il dit |
|---|---|
| Préparation des données | |
| INVALID_INPUT | les entrées sont inutilisables : tailles qui ne correspondent pas, aucune valeur finie, forme demandée inconnue. |
| INSUFFICIENT_DATA | la courbe compte moins de points que le minimum, vingt par défaut, trop peu pour que les épreuves suivantes veuillent dire quelque chose. |
| ZERO_RANGE | l'axe des abscisses ne varie pas : tous les points sont empilés au même endroit. |
| INCOMPATIBLE_GLOBAL_SHAPE | la courbe n'a pas la forme annoncée ou n'a pas de tendance assez nette pour qu'on la devine. |
| Recherche des candidats | |
| NO_KNEE_CANDIDATES | la courbe de différence n'a aucun sommet, à aucune échelle de lissage. |
| ALL_CANDIDATES_WEAK | des sommets existent, tous noyés dans le bruit local. |
| BOUNDARY_KNEE | le meilleur candidat colle à une extrémité de la courbe, où rien ne distingue un coude d'un simple effet de bord. |
| NO_PERSISTENT_CLUSTER | aucun candidat ne revient au même endroit quand on change l'échelle de lissage. |
| MULTIPLE_PLAUSIBLE_KNEES | deux coudes sont également défendables : répondre reviendrait à tirer à pile ou face. |
| Confirmation statistique | |
| WEAK_SLOPE_CHANGE | la pente, mesurée par la médiane de Theil-Sen, change trop peu pour mériter le mot coude. |
| SEGMENTED_MODEL_NOT_BETTER | la ligne brisée ne bat pas la droite simple, à la validation croisée par blocs ou au BIC. |
| BOOTSTRAP_UNSTABLE | le coude revient dans une minorité seulement des copies du bootstrap. |
| BOOTSTRAP_MULTIMODAL | il revient souvent, mais à deux endroits distincts selon la copie. |
| NULL_NOT_REJECTED | une droite sans coude, affectée du même bruit, produirait trop facilement une preuve aussi forte. |
| INTERNAL_NUMERICAL_FAILURE | un calcul a échoué : le paquet le déclare au lieu de renvoyer un nombre douteux. |
Les quinze motifs de refus, dans l'ordre où la chaîne peut les rencontrer.
Un refus dit aussi quoi faire. INSUFFICIENT_DATA demande plus de points. BOOTSTRAP_MULTIMODAL suggère qu'il y a peut-être deux coudes plutôt qu'aucun, ce qui renvoie vers la recherche au pluriel décrite plus bas. NULL_NOT_REJECTED dit que la courbe est jolie, mais que le bruit suffirait à l'expliquer.
Plusieurs portes, un seul verdict
Un détecteur sert seulement si on peut l'appeler depuis l'endroit où l'on travaille. elbow-helper offre donc la même chaîne par cinq accès :
- La bibliothèque Python convient à un carnet d'analyse.
- La commande en terminal convient à un script ou à ces vérifications automatiques qu'on rejoue à chaque modification du code.
- L'API HTTP sert un service écrit dans un autre langage que Python.
- Le serveur MCP (Model Context Protocol) sert un assistant conversationnel.
- L'application web s'adresse à qui ne veut rien installer.
Les quatre premiers sont de fines couches posées sur un seul moteur. Ils offrent les quatre mêmes opérations :
kneerend un coude avec son incertitude.elbowest le raccourci du cas k-means, où la courbe est connue d'avance comme creuse et descendante.diagnosticsrend la figure en SVG, un format de dessin qui reste net à toute taille.locatorrend la position seule, sans les preuves.
Ce que l'un renvoie, les autres le renvoient aussi.
À l'installation, on choisit son accès. Le moteur dépend de NumPy et de rien d'autre. Les accès réseau sont des options entre crochets, qu'on installe seulement si on s'en sert :
$ pip install elbow-helper            # bibliothèque + ligne de commande
$ pip install "elbow-helper[api]"     # + l'API HTTP
$ pip install "elbow-helper[mcp]"     # + le serveur MCP (qui embarque l'API)
La bibliothèque
Deux fonctions font tout le travail. robust_knee prend une courbe et devine sa forme. robust_elbow traite le cas k-means, dont on connaît la forme d'avance. Les abscisses sont facultatives : si vous donnez seulement les ordonnées, le paquet numérote les points de zéro à n moins un.
from elbow_helper import robust_knee, robust_elbow, RobustKneeConfig

res = robust_knee(x, y)                     # forme et sens devinés
res = robust_elbow(k_values, inerties)      # le cas k-means, forme imposée
res = robust_knee(y)                        # x implicite : 0, 1, 2, ...

# Plus de rejeux : plus lent, plus sûr.
res = robust_knee(x, y, config=RobustKneeConfig(bootstrap_replicates=500,
                                                null_replicates=1000,
                                                random_seed=0))

if res.is_clear:
    print(res.knee_x, res.ci90, res.detection_rate, res.null_p_value)
else:
    print("pas de coude net :", res.reason)
Tous les seuils sont rangés dans RobustKneeConfig, une structure qu'on ne modifie pas : on en fabrique une copie avec config.with_(...). Les réglages livrés visent la seconde de calcul plutôt que la dernière décimale : cent copies de bootstrap, deux cents droites simulées. Pour une validation sérieuse, prenez les valeurs ci-dessus, cinq à dix fois plus lentes.
La ligne de commande
Elle offre les quatre mêmes opérations et répond en JSON, un format de texte qu'un programme relit sans ambiguïté. De quoi l'enchaîner aux outils habituels. Les données entrent au choix en valeurs séparées par des virgules, en fichier NumPy ou en colonne d'un tableau CSV désignée par son numéro :
$ elbow-helper knee --y-values 0,0.1,0.3,0.6,0.85,0.9,0.92,0.93,0.94,0.95
{
  "reason": "INSUFFICIENT_DATA",
  "diagnostics": {
    "curve": "auto",
    "direction": "auto",
    "n": 10,
    "min_samples": 20
  },
  "is_clear": false
}

$ elbow-helper elbow --x-npy k.npy --y-npy inertie.npy
$ elbow-helper knee --y-csv mesures.csv:2 --config-json '{"bootstrap_replicates": 500}'
$ elbow-helper diagnostics --x-npy k.npy --y-npy inertie.npy > diagnostic.svg
Regardez de près la première commande. La courbe qu'elle reçoit a tout à fait la bonne allure. N'importe quel détecteur classique aurait rendu un chiffre. Dix points, pourtant, ne suffisent pas pour affirmer qu'il y a un coude. La réponse est donc un refus documenté, qui dit combien de points ont été fournis et combien il en faudrait, sans estimation de complaisance. Tous les accès obéissent à cette règle.
L'API HTTP
Un serveur se lance en une ligne et écoute quatre adresses, du nom des quatre opérations. La courbe voyage en JSON, les réglages aussi, dans un objet config_overrides. L'adresse diagnostics renvoie le SVG lui-même, sans emballage autour.
# uvicorn : le serveur qui fait tourner l'application Python.
$ uvicorn elbow_helper.api:app --port 8000

$ curl -s -X POST localhost:8000/knee -H 'Content-Type: application/json' \
       -d '{"x": [0, 0.0127, ...], "y": [0.0043, 0.0361, ...],
            "config_overrides": {"random_seed": 0}}'
{"reason": "CLEAR_KNEE", "knee_x": 0.3038, "ci90": [0.3038, 0.3418],
 "detection_rate": 0.98, "null_p_value": 0.00498, "is_clear": true,
 "diagnostics": {...}}                       # réponse abrégée
Le serveur MCP
Le serveur MCP est cette même application, avec les quatre opérations déclarées comme outils qu'un assistant conversationnel peut découvrir et appeler, servies sur /mcp :
$ uvicorn elbow_helper.mcp_server:app --port 8021
# L'assistant se connecte à http://127.0.0.1:8021/mcp et y découvre
# quatre outils : knee, elbow, diagnostics, locator.
L'intérêt dépasse le confort. Montrez une courbe à un assistant : il produira volontiers un coude plausible, sans rien pour le contredire. Branché sur cet outil, il obtient un verdict calculé, avec sa fourchette et sa valeur \(p\), ou bien un refus nommé qu'il ne peut pas transformer en certitude.
L'application web
Le dernier accès ne demande rien : deraison.ai/elbow-helper fait tourner la chaîne entière dans le navigateur, sur vos données, sans les téléverser nulle part. On y colle une courbe, on récupère le même verdict et la même figure de diagnostic que par les quatre autres portes, en français ou en anglais.
Plusieurs coudes, un tableau à remplir
Prenez trois paliers de prix sur une courbe de demande : la courbe change plusieurs fois de régime. La question devient alors : combien de cassures et où ? robust_knees, au pluriel, y répond. Changer de question oblige à changer de modèle. On découpe la courbe en morceaux, on ajuste à chacun sa propre droite et on accepte un saut à la jointure. On renonce volontairement à la ligne brisée d'un seul tenant de tout à l'heure. Avec elle, dès que plusieurs cassures peuvent bouger, le coût d'un découpage ne se calculerait plus morceau par morceau : déplacer une cassure changerait ce que ses voisines doivent respecter. Sans jointure imposée, chaque morceau devient un petit problème indépendant. C'est ce qui rend la recherche rapide.
Premier ingrédient : calculer d'un coup le coût d'un morceau. Ajuster une droite sur \(m\) points et mesurer son erreur semble demander de repasser sur chaque point. Six totaux cumulés suffisent pourtant, le nombre de points et ces cinq sommes :
On en tire la pente b et l'ordonnée à l'origine a des moindres carrés, puis l'erreur du morceau, notée \(\mathrm{SCR}\) pour somme des carrés des résidus :
La dernière égalité vient des équations des moindres carrés. Elle dit que le coût de n'importe quelle tranche de la courbe se lit dans ces totaux, sans retoucher aux points. Pour une tranche, on soustrait le total à son entrée du total à sa sortie. Calculer ces totaux une fois demande un temps proportionnel au nombre de points. Chaque coût de morceau s'obtient ensuite en temps constant, quelle que soit la longueur de la courbe.
Deuxième ingrédient : la recherche elle-même. Essayer toutes les façons de placer \(k\) cassures parmi \(n\) points est hors de portée. Sur une courbe de cent points, six cassures se placent déjà de plus d'un milliard de façons. La programmation dynamique contourne l'obstacle en construisant la réponse à partir de réponses plus petites déjà calculées. Notons \(C[k][t]\) le coût le plus faible pour expliquer les \(t\) premiers points avec \(k+1\) morceaux :
La première égalité traite le cas sans coupe : un seul morceau, dont le coût se lit directement. La seconde se lit ainsi. On essaie chaque position possible \(s\) de la dernière coupe. Pour chacune, on additionne deux coûts : le meilleur pour expliquer les \(s\) premiers points avec une cassure de moins, déjà calculé et qu'on relit, puis celui du dernier morceau, de \(s\) à \(t\). On garde le minimum.
Pourquoi a-t-on le droit de relire une réponse plus petite au lieu de tout recalculer ? Faisons le raisonnement à l'envers. Supposons que le meilleur découpage des \(t\) premiers points ait sa dernière coupe en \(s^\ast\), mais que son début ne soit pas le meilleur découpage possible de ce début. On pourrait alors remplacer ce début par le moins cher, garder le dernier morceau tel quel et obtenir un découpage valide encore moins cher que le meilleur. C'est impossible. Le début d'une solution optimale est donc lui-même optimal : c'est le principe de Bellman15.
Comptons les cases, sur la même courbe de cent points avec six cassures. Sept rangées pour le nombre de morceaux, cent colonnes pour les points, au plus cent positions à essayer par case : au plus 70 000 additions, là où l'énumération brute en demandait plus d'un milliard. Chaque case garde aussi une flèche vers la case d'où elle vient : on remonte les flèches, on retrouve les coupes.
Cette méthode est la méthode classique de la détection de ruptures. L'algorithme PELT16 part d'elle et va plus vite, parce qu'il abandonne en route les découpages devenus sans espoir. Ici, elle est vérifiée contre une énumération complète sur de petits jeux de données, au lieu d'être tenue pour acquise.
Troisième ingrédient : choisir le nombre de cassures. Plus on en ajoute, mieux on colle aux données, jusqu'à l'absurde d'un morceau par point. Un BIC modifié17 tranche : il ajoute une pénalité qui fait payer chaque cassure et qui surveille en plus la longueur de chaque morceau :
Cette formule additionne trois termes, pour k cassures donc k+1 morceaux :
- Le premier mesure l'ajustement : il baisse quand la somme des carrés des résidus baisse.
- Le deuxième fait payer les cassures, à raison de trois fois le logarithme du nombre de points pour chacune.
- Le troisième surveille les longueurs : chaque morceau compte par sa part de la courbe, sa longueur divisée par le nombre de points. Cette part est inférieure à un, donc son logarithme est négatif.
Le signe moins devant cette somme n'a pas toujours été là. Une source secondaire écrit ce terme avec un plus, alors que la littérature d'origine veut pénaliser les morceaux inégaux. Le paquet l'a d'abord repris tel quel. Testé, ce plus a produit l'effet inverse de celui qu'on lui prête : le terme étant toujours négatif, l'ajouter récompense les découpages déséquilibrés au lieu de les punir. Avec un moins, les morceaux courts et inégaux sont bien pénalisés, comme annoncé. La convention retenue ici est celle que les tests confirment. L'écart est documenté au grand jour.
Une incertitude demeure : un signe qui paraît inversé peut venir d'une définition différente de la vraisemblance, d'un score qu'on minimise au lieu de le maximiser ou d'une longueur normalisée autrement. Pour trancher, il faudrait mettre les formules en regard terme à terme, dans une annexe que le dépôt n'a pas encore écrite. Il s'agit donc d'un désaccord mesuré, pas d'une correction de la littérature.
Un test de permutation confirme enfin le gagnant. On mélange la courbe deux cents fois : aucune de ces versions mélangées n'a de vraie cassure, donc presque toutes doivent faire moins bien que l'ajustement réel. Comme multiplier les tests multiplie les occasions d'avoir de la chance, une correction de Bonferroni resserre la barre de chaque test en proportion de leur nombre18.
Une nuance sépare le singulier du pluriel. Au pluriel, une réponse vide est une conclusion plutôt qu'une abstention : cette courbe n'a aucune cassure réelle. Ce verdict a franchi les mêmes barrières qu'une réponse non vide. Seul un problème de préparation (entrée invalide, données trop courtes, plage nulle) renvoie une erreur au lieu d'une liste de cassures.
Ces choix (la programmation dynamique plutôt que la méthode gloutonne, le signe moins, la confirmation par permutation) ont été tranchés par la mesure. Dix combinaisons ont été mises en concurrence : deux façons de chercher, multipliées par cinq façons de choisir le nombre de cassures. La programmation dynamique examine tous les découpages. La méthode gloutonne pose ses cassures une par une sans jamais revenir dessus. Chaque méthode a traité trois cents courbes de cent points, fabriquées pour l'essai. Il y en a vingt-cinq pour chaque combinaison de quatre nombres de cassures (de zéro à trois) et de trois niveaux de bruit. Vingt-cinq fois quatre fois trois, le compte y est.
Les étiquettes des deux figures qui suivent se lisent ainsi :
- DP désigne la programmation dynamique (dynamic programming), Greedy la méthode gloutonne.
- BIC désigne le critère seul, mBIC_add et mBIC_sub les deux signes du terme de longueur, le plus et le moins.
- ICL est un critère voisin, qui fait payer en plus l'incertitude du découpage19.
- FWER désigne le test de permutation corrigé à la Bonferroni. Ce sigle anglais (family-wise error rate) nomme le risque de se tromper au moins une fois sur toute la série de tests.
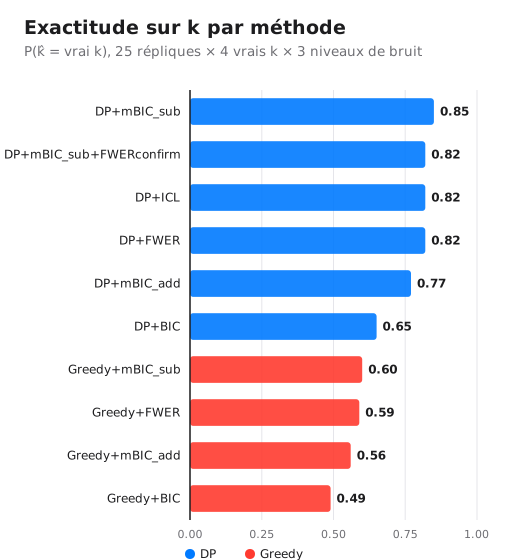
Probabilité de retrouver le bon nombre de cassures. Les cinq méthodes de tête reposent toutes sur la programmation dynamique, les cinq dernières sont leurs jumelles gloutonnes.
Dans ce classement, la recherche complète bat la méthode gloutonne à chaque fois et de loin : 0,85 contre 0,60 pour le même critère. Le mécanisme est connu20 : la méthode gloutonne s'engage tôt sur une coupe imparfaite, puis les coupes suivantes servent à réparer cette erreur au lieu de décrire la courbe. Le signe du terme de longueur, l'histoire racontée plus haut, se chiffre aussi : 0,85 avec le moins, 0,77 avec le plus de la littérature. Un seul signe fait gagner huit centièmes.
Reste le défaut qui intéresse le plus ce projet : inventer une cassure là où il n'y en a aucune. La seconde figure le mesure sur des courbes tracées plates exprès.
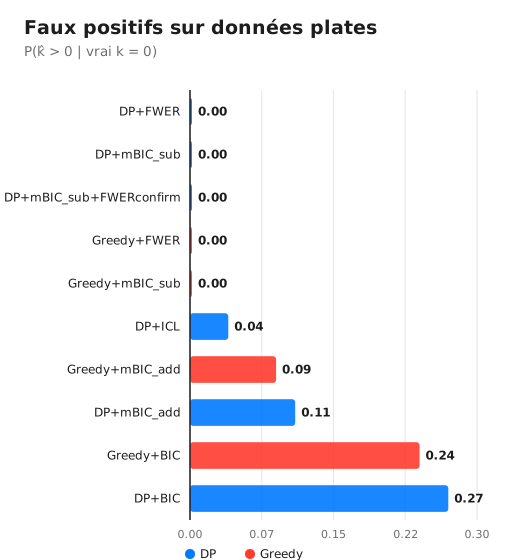
Probabilité d'annoncer au moins une cassure sur une courbe qui n'en a aucune. Le BIC nu se trompe une fois sur quatre, la dérive que la théorie lui prête depuis longtemps21. La forme soustractive et le filtre par permutation ne se trompent jamais sur les soixante-quinze courbes qui n'ont aucune cassure.
Toutes les méthodes butent sur la même limite. À fort bruit, face à trois cassures réelles, la meilleure en annonce 1,8 en moyenne et aucune ne les retrouve toutes. Dans ce cas difficile, l'erreur va vers moins de coudes et non vers plus. C'est la direction dans laquelle ce paquet accepte de se tromper. Ces chiffres valent pour cette famille de courbes et pour elle seule. Le dépôt publie le protocole complet, avec le tableau détaillé par niveau de bruit22.
Une seule dépendance de calcul fait tourner tout cela, NumPy. L'algorithme de recherche a été réécrit de zéro et la figure se dessine trait par trait en SVG, sans bibliothèque de graphiques. Chaque formule de cette chaîne, de la mise à l'échelle au test de permutation, est démontrée pas à pas dans la note mathématique du dépôt, ELBOW.pdf23. Elle est écrite intuition d'abord, avec un exemple travaillé avant chaque formule. La vraisemblance a sa note à part, LIKELIHOOD.pdf24, parce qu'elle ne doit rien à l'ajustement de courbes.
Le paysage, outil par outil
Où se place tout cela ? Le dépôt note huit façons de chercher un coude, sur onze critères. La note vise le travail de ce paquet, annoncer un coude seulement quand la preuve le soutient. Un outil excellent à un autre métier n'en est pas puni.
| Outil de détection de coude | Robustesse au bruit | Forme devinée | Abstention explicite | Cassures multiples | Test statistique | Incertitude chiffrée | Sélection de modèle | Dépendances légères | Appel en une ligne | Reproductible | Maths publiées |
|---|---|---|---|---|---|---|---|---|---|---|---|
| elbow-helper | ⭐️⭐️⭐️⭐️⭐️ | ⭐️⭐️⭐️⭐️⭐️ | ⭐️⭐️⭐️⭐️⭐️ | ⭐️⭐️⭐️⭐️⭐️ | ⭐️⭐️⭐️⭐️⭐️ | ⭐️⭐️⭐️⭐️⭐️ | ⭐️⭐️⭐️⭐️⭐️ | ⭐️⭐️⭐️⭐️⭐️ | ⭐️⭐️⭐️⭐️ | ⭐️⭐️⭐️⭐️⭐️ | ⭐️⭐️⭐️⭐️⭐️ |
| kneed | ⭐️⭐️ | ⭐️⭐️ | ⭐️ | ⭐️⭐️ | ⭐️ | ⭐️ | ⭐️ | ⭐️⭐️⭐️⭐️ | ⭐️⭐️⭐️⭐️⭐️ | ⭐️⭐️⭐️⭐️⭐️ | ⭐️⭐️⭐️ |
| ruptures | ⭐️⭐️⭐️ | ⭐️ | ⭐️⭐️ | ⭐️⭐️⭐️⭐️⭐️ | ⭐️⭐️ | ⭐️ | ⭐️⭐️⭐️ | ⭐️⭐️⭐️ | ⭐️⭐️⭐️ | ⭐️⭐️⭐️⭐️⭐️ | ⭐️⭐️⭐️⭐️ |
| kneebow | ⭐️⭐️ | ⭐️⭐️⭐️ | ⭐️ | ⭐️ | ⭐️ | ⭐️ | ⭐️ | ⭐️⭐️⭐️⭐️⭐️ | ⭐️⭐️⭐️⭐️ | ⭐️⭐️⭐️⭐️⭐️ | ⭐️⭐️ |
| KElbowVisualizer | ⭐️⭐️ | ⭐️⭐️⭐️ | ⭐️⭐️ | ⭐️ | ⭐️ | ⭐️ | ⭐️ | ⭐️ | ⭐️⭐️⭐️⭐️⭐️ | ⭐️⭐️⭐️⭐️ | ⭐️⭐️⭐️ |
| Paquet R segmented | ⭐️⭐️⭐️ | ⭐️⭐️ | ⭐️⭐️ | ⭐️⭐️⭐️⭐️ | ⭐️⭐️⭐️⭐️ | ⭐️⭐️⭐️⭐️ | ⭐️⭐️⭐️ | ⭐️⭐️ | ⭐️⭐️ | ⭐️⭐️⭐️⭐️ | ⭐️⭐️⭐️⭐️⭐️ |
| Estimation visuelle manuelle | ⭐️ | ⭐️ | ⭐️⭐️⭐️ | ⭐️⭐️ | ⭐️ | ⭐️ | ⭐️ | ⭐️⭐️⭐️⭐️⭐️ | ⭐️⭐️⭐️⭐️⭐️ | ⭐️ | ⭐️ |
| Demander à un LLM | ⭐️⭐️ | ⭐️⭐️⭐️⭐️ | ⭐️⭐️⭐️ | ⭐️⭐️⭐️ | ⭐️ | ⭐️⭐️ | ⭐️ | ⭐️⭐️ | ⭐️⭐️⭐️⭐️⭐️ | ⭐️⭐️ | ⭐️ |
Les onze critères du dépôt, de une à cinq étoiles. La ligne surlignée est celle du paquet dont parle cet article.
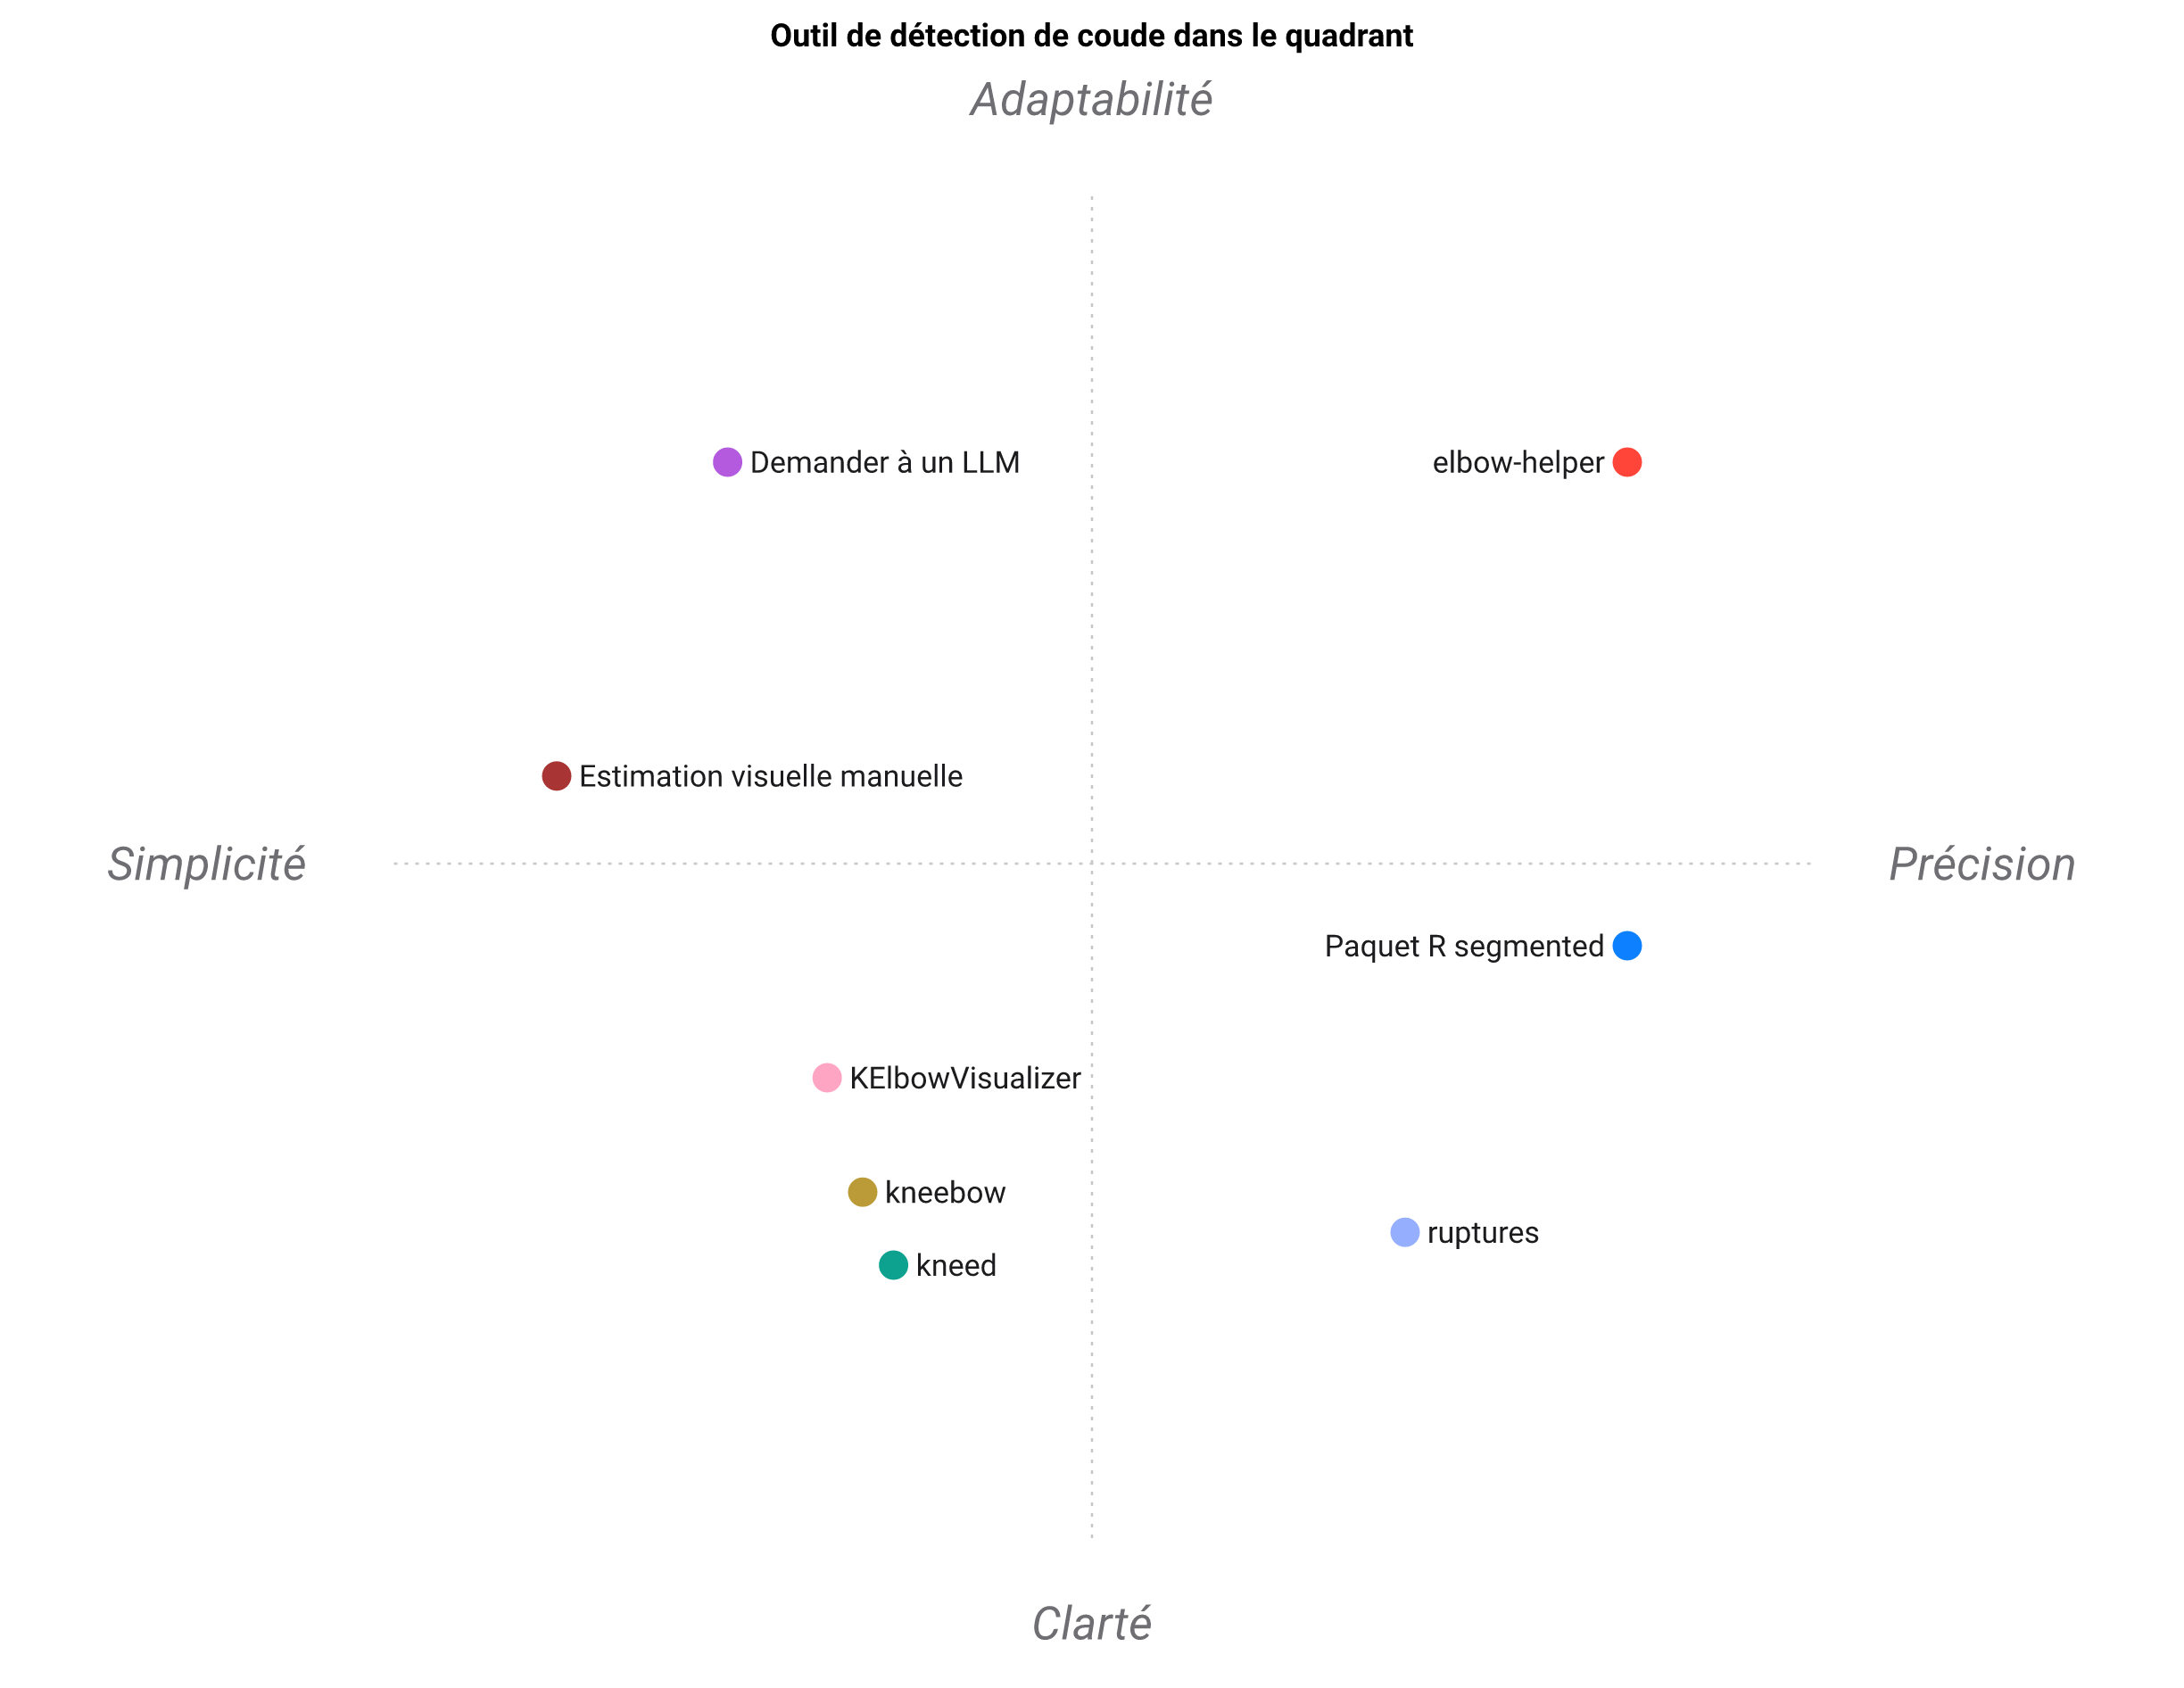
Le même tableau, vu de haut. Une analyse en composantes principales projette ses onze colonnes sur les deux directions qui le résument le mieux. Les axes sont ensuite nommés à la main. elbow-helper occupe seul le coin précision et adaptabilité. Carte produite par Standpoint, l'outil qui lit un tableau de notes et en dessine la carte.
- elbow-helper : le seul du lot qui puisse refuser de répondre. Un coude doit rester en place d'un lissage à l'autre, survivre au bootstrap et battre le modèle sans coude. L'outil rend alors un coude avec son intervalle, ou un motif d'abstention nommé.
- kneed : l'implémentation de référence de Kneedle, déterministe et immédiate. Elle rend toujours un point, sans marge d'erreur ni porte de sortie.
- kneebow : la même idée géométrique, obtenue en faisant tourner la courbe. Très léger en dépendances, il s'engage à chaque appel.
- KElbowVisualizer : la façon la plus répandue de lire un coude de k-means, on trace puis on regarde. Cet outil de visualisation, taillé pour une seule forme de courbe, hérite de scikit-learn et de matplotlib.
- ruptures : l'outil juste quand la question est « combien de ruptures et où », avec PELT et la segmentation binaire déjà en place. La notion de rendements décroissants lui est étrangère.
- Paquet R segmented : le plus rigoureux statistiquement, avec régression en ligne brisée, erreurs types, test de Davies et cassures multiples. Il demande R et une réelle aisance statistique.
- Estimation visuelle manuelle : un œil averti sait dire « je ne vois rien de net ici », ce que la plupart des outils ne savent pas. Ce jugement change d'une personne à l'autre et passe mal à l'échelle.
- Demander à un LLM : un grand modèle de langage décrit une forme en mots avec aisance et nuance si on le lui demande. Il rend cela sans incertitude calibrée, sans dérivation vérifiable, jamais deux fois la même réponse.
Ce que l'outil suppose
Le lissage suppose des abscisses à peu près régulièrement espacées : une courbe échantillonnée n'importe comment le mettrait en défaut.
La position rendue est l'un des points fournis et jamais une valeur entre deux. Avec peu de points, le coude peut donc tomber à quelques échantillons de la vérité. Une fois sur deux, sur la famille de courbes d'essai, l'erreur reste sous 5 % de la largeur de la courbe. La droite simulée et le bootstrap supposent autre chose : un bruit de même taille sur toute la courbe et un point qui ne dépend pas du suivant. Les variantes qui s'en passent restent à écrire.
Les seuils, enfin, sont calibrés sur une famille de courbes documentée. Exiger 90 % de redétections et une valeur \(p\) à 1 %, ce sont des choix raisonnés, pas des lois de la nature. Le paquet est en version 0.1. Son auteur le dit : si votre décision en dépend, recalibrez sur vos propres courbes. Toute méthode qui travaille sur des données limitées peut se tromper. Celle-ci se contente de rendre ses hypothèses vérifiables.
Le refus qui rend service
« Pas de coude net » est une vraie information. Elle évite de dimensionner un système, d'arrêter une expérience ou de trancher un budget sur un hasard. Un détecteur qui sait se taire rend un meilleur service qu'un détecteur qui répond toujours. Cette confiance affichée se paie en abstentions, un échange que j'assume.
elbow-helper s'installe en une ligne, pip install elbow-helper. Pour l'essayer sans rien installer, ouvrez le bac à sable en ligne : la chaîne complète tourne dans votre navigateur sans téléverser vos données. Le dépôt GitHub réunit le code, les exemples, le comparatif des outils voisins et les notes mathématiques. Pour chaque courbe, il rend soit un coude chiffré, soit un refus motivé.
Bibliographie
Voici les travaux dont ce paquet dépend, rangés dans l'ordre où l'article s'en sert. Chaque notice dit ce que la source établit et à quel endroit elle sert ici. Les classiques y figurent pour le résultat standard qu'ils fondent, les notes du dépôt pour leurs dérivations et leurs mesures.
- Thorndike, R. L. (1953). « Who belongs in the family? », Psychometrika, 18(4), 267-276. 10.1007/BF02289263 Adresse présidentielle à la Psychometric Society, couramment donnée comme la première formulation du critère du coude : on trace une mesure de dispersion contre le nombre de groupes et l'on cherche le pli. Elle pose la question dont vit cet article, sans proposer de règle de décision.
- Satopää, V., Albrecht, J., Irwin, D. et Raghavan, B. (2011). « Finding a Kneedle in a Haystack: Detecting Knee Points in System Behavior », ICDCSW, IEEE. Définit le coude comme le maximum de l'écart à la corde après normalisation, avec un seuil de sensibilité : c'est l'algorithme de localisation réécrit ici. Sa limite est dans son énoncé même : il propose un emplacement, il ne dit pas si ce coude existe.
- Arvai, K. kneed, bibliothèque Python, licence BSD à trois clauses. github.com/arvkevi/kneed L'implémentation de référence de Kneedle en Python. Sa logique de parcours, sa table d'orientations et son seuil de sensibilité ont guidé la réécriture NumPy d'elbow-helper, qui n'en dépend pas à l'exécution.
- kneebow, bibliothèque Python, licence MIT. github.com/georg-un/kneebow Fait tourner la courbe puis prend l'extremum de la courbe tournée. Représentatif du camp qui répond toujours par un point, sans jamais pouvoir se taire.
- Bengfort, B. et Bilbro, R. (2019).
« Yellowbrick: Visualizing the Scikit-Learn Model Selection Process », Journal of Open Source Software, 4(35), 1075. 10.21105/joss.01075 Bibliothèque de diagnostics visuels pour scikit-learn, dont
le
KElbowVisualizerqui trace l'inertie et marque un coude. L'outil vise la lecture à l'œil, pas la décision chiffrée. - Truong, C., Oudre, L. et Vayatis, N.
(2020). « Selective review of offline change point detection methods », Signal Processing, 167, 107299. arxiv.org/abs/1801.00718 Revue qui range la détection de ruptures en trois briques,
une fonction de coût, une méthode de recherche, une contrainte sur le nombre de ruptures ;
elle accompagne la bibliothèque
ruptures. C'est le cadre dont la partie multi-coudes de cet article hérite, sur une question voisine mais distincte de celle des rendements décroissants. - Muggeo, V. M. R. (2003).
« Estimating regression models with unknown break-points », Statistics in Medicine, 22(19), 3055-3071. 10.1002/sim.1545 Estime
la position d'une cassure par linéarisations successives et en donne une erreur type, donc un
intervalle. C'est le parent le plus proche d'elbow-helper sur l'idée qu'une affirmation de coude
doit venir avec son incertitude ; le paquet R
segmenteden est la mise en œuvre. - Spearman, C. (1904). « The Proof and Measurement of Association between Two Things », American Journal of Psychology, 15(1), 72-101. Corrélation calculée sur les rangs plutôt que sur les valeurs. Elle sert ici d'examen de forme, insensible à l'échelle et peu troublée par quelques points extrêmes.
- Theil, H. (1950). « A Rank-Invariant Method of Linear and Polynomial Regression Analysis », Proceedings of the Royal Netherlands Academy of Sciences, 53 ; Sen, P. K. (1968). « Estimates of the Regression Coefficient Based on Kendall's Tau », Journal of the American Statistical Association, 63(324), 1379-1389. Les deux articles fondent l'estimateur de pente par médiane des pentes de toutes les paires de points. C'est lui qui permet d'exiger un changement de pente sans qu'une poignée de valeurs aberrantes décide du verdict.
- Arlot, S. et Celisse, A. (2010). « A survey of cross-validation procedures for model selection », Statistics Surveys, 4, 40-79. 10.1214/09-SS054 Revue qui sépare soigneusement ce qui est démontré de ce qui n'est qu'observé en validation croisée et montre que la forme des blocs retirés doit épouser la dépendance des données. C'est la justification du retrait par tronçons contigus employé ici.
- Schwarz, G. (1978). « Estimating the Dimension of a Model », The Annals of Statistics, 6(2), 461-464. Fonde le BIC : une pénalité égale au nombre de paramètres multiplié par le logarithme du nombre d'observations, obtenue comme approximation de la vraisemblance marginale. C'est le score que la ligne brisée doit battre pour mériter son coude.
- Kass, R. E. et Raftery, A. E. (1995). « Bayes Factors », Journal of the American Statistical Association, 90(430), 773-795. Donne l'approximation par laquelle un écart de BIC se lit comme une cote entre deux modèles et l'échelle de lecture qui va avec. C'est d'elle que vient le poids que la légende de la figure de diagnostic affiche sous le nom de probabilité a posteriori.
- Efron, B. (1979). « Bootstrap Methods: Another Look at the Jackknife », The Annals of Statistics, 7(1), 1-26. Introduit le rééchantillonnage comme substitut à une loi d'échantillonnage qu'on ne sait pas écrire. Ici, c'est le bruit résiduel qu'on rebrasse, pour mesurer à quelle fréquence et à quel endroit le coude revient.
- Davies, R. B. (1977). « Hypothesis testing when a nuisance parameter is present only under the alternative », Biometrika, 64(2), 247-254. 10.1093/biomet/64.2.247 Traite exactement la difficulté du coude : un paramètre qui n'existe que si l'hypothèse alternative est vraie, ici la position \(k\). Le test du rapport de vraisemblance y perd sa loi asymptotique usuelle, ce qui explique le recours à une valeur \(p\) simulée plutôt que lue dans une table.
- Bellman, R. (1957). Dynamic Programming, Princeton University Press. Source canonique du principe d'optimalité : le début d'une solution optimale est optimal pour son propre sous-problème. C'est ce qui autorise la récursion utilisée ici pour placer plusieurs cassures.
- Killick, R., Fearnhead, P. et Eckley, I. A. (2012). « Optimal Detection of Changepoints With a Linear Computational Cost », Journal of the American Statistical Association, 107(500), 1590-1598. PELT : la même récursion exacte, accélérée par un élagage qui écarte définitivement les découpages devenus sans espoir, d'où un coût linéaire sous certaines conditions sur la pénalité.
- Zhang, N. R. et Siegmund, D. O. (2007). « A Modified Bayes Information Criterion with Applications to the Analysis of Comparative Genomic Hybridization Data », Biometrics, 63(1), 22-32. Introduit le BIC modifié dont le terme supplémentaire surveille la longueur des segments. C'est la référence dont le signe, repris tel quel d'abord, a dû être corrigé ici après mesure de son effet réel.
- Dunn, O. J. (1961). « Multiple Comparisons Among Means », Journal of the American Statistical Association, 56(293), 52-64. 10.1080/01621459.1961.10482090 Établit et met en pratique l'inégalité qui porte en statistique le nom de Bonferroni : diviser le seuil par le nombre de tests borne le risque de se tromper au moins une fois. Employée ici dès que plusieurs nombres de cassures sont mis à l'épreuve.
- Biernacki, C., Celeux, G. et Govaert, G. (2000). « Assessing a Mixture Model for Clustering with the Integrated Completed Likelihood », IEEE Transactions on Pattern Analysis and Machine Intelligence, 22(7), 719-725. Le critère ICL, qui ajoute au BIC une pénalité sur l'incertitude du classement. Concurrent testé dans le comparatif, où il atteint 0,82 d'exactitude et 4 % de faux positifs.
- Fryzlewicz, P. (2014). « Wild Binary Segmentation for Multiple Change-Point Detection », The Annals of Statistics, 42(6), 2243-2281. Analyse le défaut des recherches gloutonnes, qui s'engagent trop tôt sur une coupe et propagent l'erreur et propose d'y remédier par des intervalles tirés au hasard. Le comparatif de cet article retrouve ce défaut : chaque méthode gloutonne reste sous sa jumelle exhaustive.
- Yao, Y.-C. (1988). « Estimating the number of change-points via Schwarz' criterion », Statistics and Probability Letters, 6(3), 181-189. Étudie le BIC appliqué au nombre de ruptures et documente sa tendance à en retenir trop. Les 27 % de faux positifs mesurés ici en sont une illustration sur des courbes linéaires par morceaux.
- Harchaoui, W. (2026). Multi-knee method comparison: results, note de recherche du dépôt elbow-helper. research/multiknee/RESULTS.md Le protocole complet du comparatif cité plus haut : dix méthodes, trois cents courbes chacune, résultats détaillés par nombre de cassures et par niveau de bruit, temps de calcul et les six conclusions qui en sont tirées.
- Harchaoui, W. (2026). ELBOW: Noise-Robust Knee and Elbow Detection, note technique du dépôt elbow-helper, en anglais. doc/ELBOW-en.pdf Dérive pas à pas chaque formule du paquet, de la normalisation au test de permutation, intuition et exemple travaillé avant chaque formule. C'est la version longue de tout ce que cet article résume.
- Harchaoui, W. (2026). LIKELIHOOD, note technique du dépôt elbow-helper, en anglais. doc/LIKELIHOOD-en.pdf Le socle de vraisemblance repris plus haut : pourquoi la vraisemblance par observation, moyenne géométrique des densités, plutôt que le produit brut et comment la même construction se lit sur un modèle de classification.
Pour finir, trois lectures plus agréables qu'un article de revue. Mes livres préférés en IA donnent le panorama commenté d'où viennent les deux suivantes. The Elements of Statistical Learning de Hastie, Tibshirani et Friedman couvre la sélection de modèles et la validation croisée en général. Information Theory, Inference and Learning Algorithms de MacKay éclaire le lien entre vraisemblance, codage et perplexité.