Prenons douze voitures électriques. Notons chacune sur sept critères, de une à cinq étoiles. Rangeons le tout dans le tableau que voici : les options en lignes, les critères en colonnes, les notes dans les cases. Tout le monde a déjà reçu un tableau de ce genre juste avant de devoir trancher.
| Voiture | Autonomie | Performances | Recharge rapide | Rapport qualité-prix | Technologie embarquée | Sécurité | Réseau de recharge |
|---|---|---|---|---|---|---|---|
| Tesla Model 3 | ⭐️⭐️⭐️⭐️⭐️ | ⭐️⭐️⭐️⭐️⭐️ | ⭐️⭐️⭐️⭐️⭐️ | ⭐️⭐️⭐️ | ⭐️⭐️⭐️⭐️⭐️ | ⭐️⭐️⭐️⭐️⭐️ | ⭐️⭐️⭐️⭐️⭐️ |
| Renault Mégane E-Tech | ⭐️⭐️⭐️⭐️ | ⭐️⭐️⭐️⭐️ | ⭐️⭐️⭐️ | ⭐️⭐️⭐️⭐️ | ⭐️⭐️⭐️⭐️ | ⭐️⭐️⭐️⭐️ | ⭐️⭐️⭐️ |
| Peugeot e-208 | ⭐️⭐️⭐️ | ⭐️⭐️⭐️ | ⭐️⭐️⭐️ | ⭐️⭐️⭐️⭐️ | ⭐️⭐️⭐️ | ⭐️⭐️⭐️⭐️ | ⭐️⭐️⭐️ |
| Hyundai Ioniq 5 | ⭐️⭐️⭐️⭐️ | ⭐️⭐️⭐️⭐️ | ⭐️⭐️⭐️⭐️⭐️ | ⭐️⭐️⭐️ | ⭐️⭐️⭐️⭐️⭐️ | ⭐️⭐️⭐️⭐️⭐️ | ⭐️⭐️⭐️ |
| Kia EV6 | ⭐️⭐️⭐️⭐️ | ⭐️⭐️⭐️⭐️⭐️ | ⭐️⭐️⭐️⭐️⭐️ | ⭐️⭐️⭐️ | ⭐️⭐️⭐️⭐️ | ⭐️⭐️⭐️⭐️⭐️ | ⭐️⭐️⭐️ |
| Volkswagen ID.3 | ⭐️⭐️⭐️⭐️ | ⭐️⭐️⭐️ | ⭐️⭐️⭐️⭐️ | ⭐️⭐️⭐️ | ⭐️⭐️⭐️ | ⭐️⭐️⭐️⭐️ | ⭐️⭐️⭐️ |
| BMW i4 | ⭐️⭐️⭐️⭐️ | ⭐️⭐️⭐️⭐️⭐️ | ⭐️⭐️⭐️⭐️ | ⭐️⭐️ | ⭐️⭐️⭐️⭐️ | ⭐️⭐️⭐️⭐️⭐️ | ⭐️⭐️⭐️ |
| Polestar 2 | ⭐️⭐️⭐️⭐️ | ⭐️⭐️⭐️⭐️ | ⭐️⭐️⭐️⭐️ | ⭐️⭐️⭐️ | ⭐️⭐️⭐️⭐️ | ⭐️⭐️⭐️⭐️⭐️ | ⭐️⭐️⭐️ |
| Nissan Leaf | ⭐️⭐️⭐️ | ⭐️⭐️⭐️ | ⭐️⭐️ | ⭐️⭐️⭐️⭐️ | ⭐️⭐️⭐️ | ⭐️⭐️⭐️⭐️ | ⭐️⭐️⭐️ |
| MG4 | ⭐️⭐️⭐️ | ⭐️⭐️⭐️ | ⭐️⭐️⭐️ | ⭐️⭐️⭐️⭐️⭐️ | ⭐️⭐️⭐️ | ⭐️⭐️⭐️ | ⭐️⭐️⭐️ |
| Dacia Spring | ⭐️⭐️ | ⭐️⭐️ | ⭐️⭐️ | ⭐️⭐️⭐️⭐️⭐️ | ⭐️⭐️ | ⭐️⭐️⭐️ | ⭐️⭐️⭐️ |
| Fiat 500e | ⭐️⭐️ | ⭐️⭐️⭐️ | ⭐️⭐️⭐️ | ⭐️⭐️⭐️⭐️⭐️ | ⭐️⭐️⭐️ | ⭐️⭐️⭐️⭐️ | ⭐️⭐️⭐️ |
Le tableau d'entrée, tel qu'on le remplit : douze options, sept critères, une note par case. Standpoint lit ce fichier tel quel.
Alors, quelle voiture ? Douze lignes multipliées par sept colonnes donnent quatre-vingt-quatre cases d'étoiles à comparer de tête, sept colonnes à mettre en balance, et votre œil a sans doute abandonné vers la Polestar. Ce tableau ne ment pas : tout y est, chaque étoile se vérifie. Seulement personne n'arrive à le lire. Alors on choisit à l'instinct, la chose même que le tableau devait empêcher. Deux personnes de bonne foi lisent d'ailleurs les mêmes étoiles et désignent deux gagnants différents.
Standpoint fait de ce tableau une carte. Chaque option y devient un point du plan et deux points proches y sont deux profils semblables. Aux extrémités des axes s'inscrivent des mots simples, dans la langue de vos colonnes. Reste la question qu'on se posait en ouvrant le tableau, celle à laquelle la carte répond d'un regard : où vous situez-vous ?
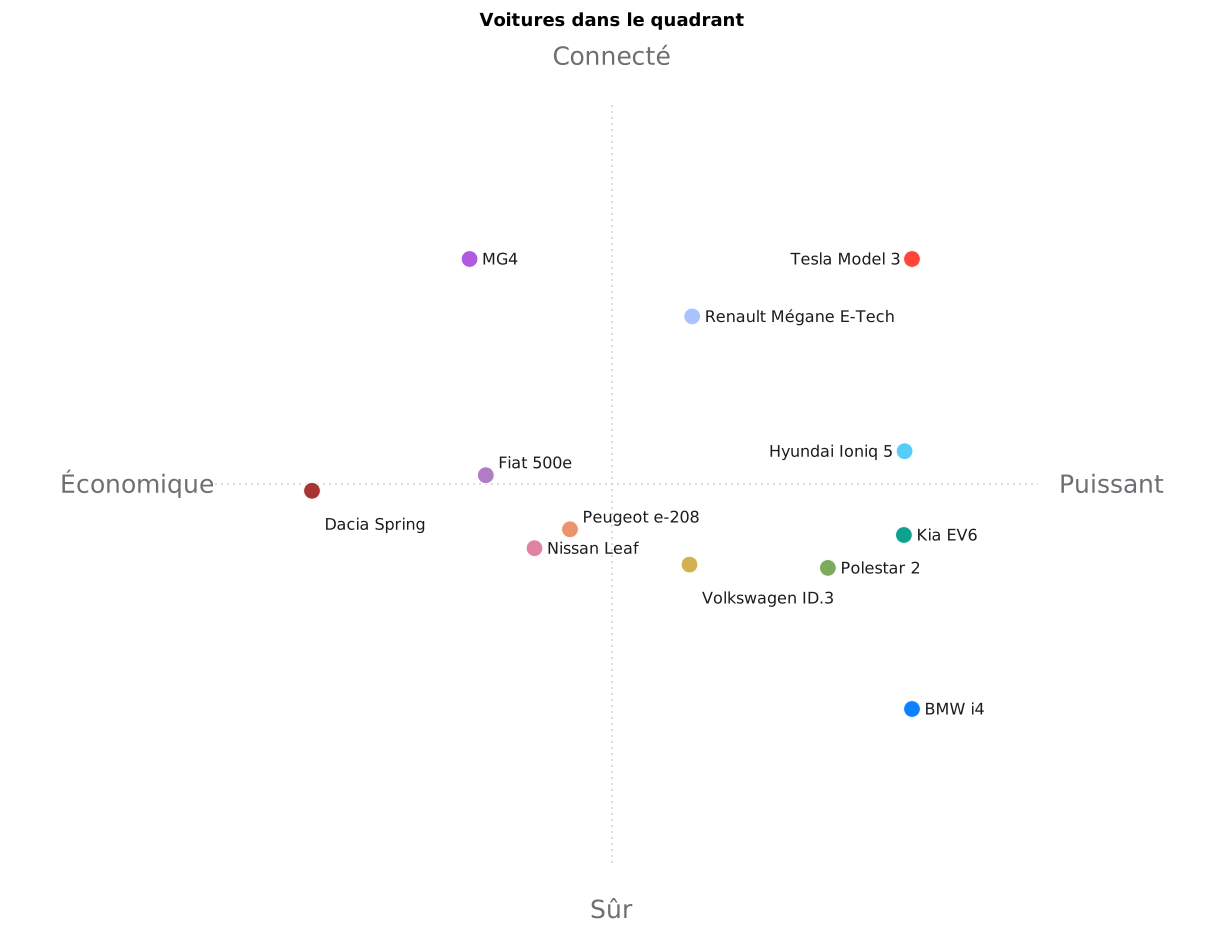
Le même tableau, vu de haut : les douze voitures placées les unes par rapport aux autres, axes nommés en français puisque le tableau l'était.
Les questions qui appellent une carte
Ces questions se reconnaissent vite : plusieurs options, plusieurs critères, puis l'obligation de dire où chacune se place par rapport aux autres. Quel hébergeur informatique choisir pour les trois prochaines années ? Dans quel langage une équipe va-t-elle écrire pendant cinq ans ? Où se situe votre produit face à six concurrents, avant un conseil d'administration ? Comment ramener quinze candidatures à une liste courte en sachant expliquer pourquoi celles-là ?
Le dépôt contient quatre tableaux de démonstration, qui montrent ce que l'outil accepte :
- Un tableau note des langages de programmation sur la performance, l'écosystème et le marché de l'emploi.
- Un autre compare des hébergeurs en ligne.
- Un troisième range des ordinateurs portables, où le prix et le poids sont signalés comme des colonnes où moins vaut mieux.
- Le dernier reprend les voitures électriques du début.
Quatre sujets sans rapport, donc, sauf par la forme du fichier : des noms dans la première colonne, des nombres partout ailleurs.
Avec une ou deux colonnes, oubliez la carte : un graphique ordinaire la bat. Pour classer sur un seul critère, triez la colonne. Si le calcul ne sert que d'étape à l'intérieur d'un programme d'apprentissage automatique, sans figure à montrer, la bibliothèque Python scikit-learn fait déjà le travail. Et surtout, Standpoint cartographie un tableau qui existe déjà. Il ne récupère aucune donnée et ne vérifie aucune note. Votre tableau est mal rempli ? Il n'en saura rien.
Un calcul de 1901, deux familles d'outils
Les cartes de positionnement sont un grand classique du marketing et du conseil : on les dessine au tableau blanc pour situer des marques, des produits, des concurrents. La méthode qui les calcule s'appelle l'analyse en composantes principales, ou ACP (Principal Component Analysis en anglais). Sa géométrie est posée par Karl Pearson en 1901, puis mise en forme par Harold Hotelling en 1933.
Prenez un bulletin scolaire. Il aligne huit notes et deux chiffres situent pourtant souvent l'élève : plutôt scientifique, plutôt littéraire. L'ACP refait ce raisonnement sur votre tableau. Elle cherche les deux ou trois directions le long desquelles les options diffèrent pour de bon. Puis elle résume chaque ligne de notes en deux nombres, qui gardent l'essentiel de ce qui la sépare des autres.
Cette méthode a cent vingt-cinq ans et elle reste la bonne en 2026, alors que le réflexe du moment est de jeter un gros modèle sur chaque problème. Regardez pourtant la taille du nôtre : douze lignes et sept colonnes. Quelques millisecondes règlent l'affaire, sans entraînement et sans une donnée venue d'ailleurs. Qui veut vérifier refait le calcul à la main. Pour aplatir un petit tableau de nombres, la méthode de 1901 n'a pas été dépassée.
Puisque le calcul est réglé depuis longtemps, le temps part dans ce qui l'entoure. Il faut tourner la carte pour qu'elle se lise dans le bon sens, nommer les axes avec des mots qu'un comité de direction comprend, colorer, poser les étiquettes sans qu'elles se chevauchent, exporter en bonne qualité. Standpoint automatise ce travail-là. Vous lui donnez votre tableau en CSV ou en Markdown. Une seule commande vous rend la figure en SVG et en PNG, plus un fichier YAML qui consigne toutes les coordonnées et tous les coefficients.
Deux familles d'outils se partagent déjà ce travail sans jamais le finir. La première réunit les boîtes à outils statistiques : prince ou l'ACP de scikit-learn en Python, FactoMineR et factoextra en R, le langage des statisticiens. Leur calcul est impeccable et il se rejoue. Mais leur sortie se résume à des axes bruts et à des nombres. À vous de nommer les axes, de tourner la carte, de la rendre présentable.
La seconde famille, celle des outils de mise en page, va droit au résultat : une diapositive à quatre cases, un gabarit Canva ou le quadrant magique du cabinet Gartner. Tout se montre tout de suite. Mais qui a placé les points ? Une main. Aucun point ne vient des données et aucun ne se rejoue. Les axes disent ce que leur auteur a décidé de leur faire dire.
Le carré qui déplace de l'argent
Dans cette seconde famille, un carré mérite qu'on s'arrête, car c'est la carte de positionnement la plus regardée au monde. Gartner est un cabinet américain qui analyse les marchés du logiciel pour les entreprises qui achètent. Il publie chaque année, pour des dizaines de marchés, une figure appelée Magic Quadrant. L'axe horizontal mesure la vision : ce que l'éditeur du logiciel a compris du marché et de la direction qu'il prend. L'axe vertical mesure l'exécution : ce que cet éditeur sait livrer aujourd'hui. Deux axes font quatre cases, dont les noms sont entrés dans le langage courant :
- En haut à droite se tiennent les Leaders.
- En haut à gauche, les Challengers livrent bien mais voient mal où va le marché.
- En bas à droite, les Visionnaires voient juste mais ne savent pas encore livrer.
- En bas à gauche se rangent les Acteurs de niche.
Y figurer est déjà une réussite, puisque Gartner place là les seules entreprises assez importantes, à ses yeux, pour être suivies. Beaucoup travaillent des années pour entrer. Une fois dedans, l'argent suit. Un directeur informatique qui défend devant son conseil un achat d'au moins un million y trouve une caution que tout le monde comprend d'un coup d'œil. Certains appels d'offres vont jusqu'à le recopier.
Comment ce carré est-il fabriqué ? La question est allée jusqu'au tribunal. En 2009, l'éditeur ZL Technologies attaque Gartner pour diffamation. Gartner plaide que le quadrant est une opinion. Une affirmation de fait peut se prouver fausse, une opinion ne le peut pas. Les juges américains lui donnent raison en 2010, puis en appel.
Un expert qui assume son opinion vaut mieux qu'une mesure inventée. L'opinion de Gartner repose sur une année d'entretiens, de réunions avec les éditeurs et d'appels à leurs clients, un travail qu'aucun calcul ne remplace. Il faut seulement savoir ce qu'on regarde : la position d'un point y est un jugement, qu'on ne refait pas à l'identique.
Standpoint promet beaucoup moins et ne remplace pas cette expertise. Mais ce qu'il promet se vérifie. La position d'un point vient d'un tableau et vous pouvez lire ce tableau. Elle vient d'un calcul et vous pouvez relancer ce calcul. Un point vous surprend ? Remontez à sa ligne, puis à ses notes.
Cette promesse a son prix. Une carte vaut ce que valent les notes du tableau. Remplir quatre-vingt-quatre cases à l'instinct puis les aplatir avec soin ne crée aucune connaissance. Le calcul rend visible et discutable ce que vous y avez mis. C'est déjà beaucoup. Ce n'est pas savoir.
Standpoint fait donc les deux : le calcul des statisticiens et la finition des outils de mise en page. S'y ajoute une idée nouvelle, confiée à un modèle de langage. Ces programmes, ChatGPT par exemple, sont entraînés à continuer du texte. Celui de Standpoint lit les axes sortis du calcul et leur donne des noms en français ordinaire. On a souvent utilisé l'ACP pour une carte de positionnement. On a beaucoup moins souvent fait nommer ses axes par une machine.
D'autres que moi peuvent s'en servir. Le paquet s'installe depuis PyPI, comme toute bibliothèque Python. Chaque modification du code relance les tests sans que personne y touche. Quatre jeux d'exemples sont livrés dans le dépôt avec leurs figures et la documentation existe en français comme en anglais. Le moteur s'atteint enfin de plusieurs façons, décrites à la fin de cet article.
Un choix me tient à cœur, même s'il prive du confort des services en ligne : tout tourne sur votre machine. Cela vaut pour le calcul, le dessin et jusqu'au nom des axes, confié à un modèle de langage ouvert que le logiciel Ollama lance sur votre propre ordinateur.
De la case vide au nom des axes
Une décision discrète vous protège avant même le calcul. Une case que vous laissez vide reçoit la plus petite note de sa colonne. Un trou ne risque donc jamais d'avantager une option. Oublier commodément de se noter sur le critère qui fâche ne rapporte rien.
Première étape, égaliser les critères. Prenez une note de confort sur 5 et un prix en milliers d'euros. Tels quels, ils ne se comparent pas : la colonne aux plus gros chiffres écraserait toutes les autres. À chaque colonne \(j\) on retire donc sa moyenne \(\mu_j\), puis on divise par son écart-type \(\sigma_j\) :
Une fois recentrés, tous les critères pèsent pareil. Dans n'importe quelle colonne, un écart de un veut dire un écart-type au-dessus de la moyenne.
Deuxième étape, le calcul lui-même. Représentez-vous les options comme un nuage de points dans un espace à sept dimensions, une par critère. Sept dimensions, personne ne les voit, mais le nuage reste une bonne image : chaque voiture y est un point, placé selon ses notes. Éclairez ce nuage avec une lampe très lointaine : chaque point projette son ombre sur un mur. Selon l'orientation du mur, les ombres se tassent ou s'étalent. L'ACP cherche l'orientation où elles s'étalent le plus. Ce mur est un plan, porté par deux directions \(v_1, v_2\), celles le long desquelles les options s'écartent le plus les unes des autres. La position d'une option sur la carte est alors son ombre sur ce plan :
Les crochets \(\langle\cdot,\cdot\rangle\) désignent le produit scalaire, qui mesure de combien un point avance le long d'une direction. Écraser sept dimensions sur un plan perd forcément quelque chose, puisque la carte résume un espace plus riche. Standpoint mesure la part d'information gardée et l'affiche sur la figure :
Autour de 80 %, la carte raconte fidèlement le tableau. En dessous, lisez-la comme une esquisse.
Troisième étape, l'orientation. L'ACP sort sa carte dans n'importe quel sens et rien n'oblige le « bon » coin à se trouver en haut à droite. Standpoint tourne donc le plan pour y amener votre option de référence, celle dont vous voulez raconter la position. Un cas limite a sa parade. Une référence notée au maximum partout partirait très loin de tout le reste. Standpoint la pose alors juste au-delà du meilleur concurrent, là où la carte reste lisible.
La géométrie choisit seule les quatre options que la carte met en avant. Le leader, en haut à droite, est votre référence. Le plus faible perd sur les deux axes. Restent deux challengers, le leader mis de côté : l'un monte le plus haut sur l'axe vertical, l'autre va le plus loin sur l'axe horizontal. Ces deux-là valent un coup d'œil, puisque chacun incarne un extrême mieux que personne sans gagner pour autant.
La couleur obéit à la même règle. Un concurrent prend sa teinte d'après sa direction, vue du centre de la carte. Les teintes font le tour du cercle des couleurs. Deux voisins sur la carte reçoivent donc des couleurs voisines, ce que l'œil lit sans y penser. La légende suit l'ordre de la carte, du coin en haut à droite vers le bas.
Dernière étape, des mots sur les axes. Les axes de l'ACP sont des mélanges de vos colonnes et ces mélanges se lisent. Un axe pèsera par exemple surtout sur l'autonomie et la recharge, l'autre sur le prix et le poids. Un modèle installé chez vous lit ces poids et baptise les quatre extrémités, toujours d'une qualité. Les noms des colonnes lui disent en quelle langue écrire : français, anglais ou espagnol. Une colonne marquée « (↓) », comme Prix (↓), signale que moins vaut mieux. Le nom retenu dit alors l'avantage : « Abordable », par exemple. Un garde-fou intercepte sigles, négations et mots contraires avant qu'ils n'atteignent une étiquette.
Que veut dire « modèle » ici ? Le mot recouvre des objets très différents. ChatGPT est un modèle de langage énorme. Sa taille se mesure en paramètres, les réglages internes appris pendant l'entraînement. Les plus gros modèles en comptent des centaines de milliards et ne tournent que dans des centres de calcul. Distiller, c'est faire apprendre à un petit modèle les réponses d'un gros, sur une tâche précise.
Le nôtre est tout petit : un Qwen3 de 0,6 milliard de paramètres. Face aux centaines de milliards des plus gros, faites la division : il est au moins cent fois plus petit. Il a été distillé pour trois tâches très limitées :
- Il donne leur nom aux quatre extrémités des axes.
- Il met les mots au bon nombre, singulier ou pluriel, pour que les intitulés sonnent juste dans les deux langues, français et anglais.
- Il propose une note de un à cinq pour une case vide, quand vous lui demandez de la remplir.
Cette troisième tâche touche à la position des points. Les notes proposées entrent dans le calcul comme les autres et déplacent donc le point sur la carte. Elles s'affichent pour que vous les corrigiez. D'après les mesures du projet, elles tombent à trois quarts de point de ce que proposerait un gros modèle, sur une échelle de un à cinq qui reste subjective.
Pourquoi si petit ? Parce que l'ACP a déjà calculé tout ce qui se calcule. Le modèle intervient là où il n'y a rien à calculer : mettre un mot sur un mélange de colonnes qui ont déjà des noms, proposer un chiffre là où la case est vide. Il ne voit jamais vos notes. Il voit des poids, des noms de colonnes et, pour le remplissage, les noms des lignes. Ce travail n'appelle aucun des très gros modèles du moment. Il appelle un modèle qui tienne dans un ordinateur portable et qui ne sorte pas de la pièce.
Un résultat d'entraînement va contre l'intuition. Au départ, on distille deux modèles, un par langue. On en ajoute un troisième, entraîné sur les deux langues ensemble, pour voir ce que la spécialisation apporte. Le bilingue gagne, partout. Pour nommer les axes, les deux spécialistes s'arrêtaient à 90 %. Le bilingue atteint 100 % dans chaque langue. Pour un modèle aussi petit, le point fragile est la forme exacte de la réponse : quatre noms rangés dans une structure fixe, la même en français et en anglais. S'entraîner en deux langues montre donc cette structure deux fois plus souvent. Un seul modèle part à la livraison, meilleur partout et deux fois moins lourd à entretenir.
Le même souci de vérifier a conduit à retirer un modèle. Standpoint contrôle sa propre figure en se posant trois questions. Le leader est-il bien en haut à droite ? Les étiquettes se lisent-elles ? La légende se voit-elle ? Un modèle qui lit les images y répondait. On a compté ses réponses sur les 1 480 exemples enregistrés pendant la distillation : deux des trois questions recevaient « oui » les 1 480 fois. Deux fois 1 480 font 2 960 réponses et pas un seul « non » ! La troisième question vise le signe d'une coordonnée, que le programme connaît déjà au chiffre près. On faisait donc regarder une image à un modèle pour y retrouver des nombres déjà sous la main. Le programme fait maintenant cette vérification lui-même, sans modèle, tout de suite et hors ligne.
La carte suivante place Standpoint parmi les autres façons de dessiner un positionnement, sur sept critères. Il l'a produite lui-même, à partir d'un tableau de notes que j'ai rempli. Il y arrive en haut à droite. Gardez vos applaudissements : Standpoint est la ligne de référence, donc il finit là par construction. Et les notes du tableau sont les miennes. Changez la référence et la même carte se réorganise autour d'un autre outil.
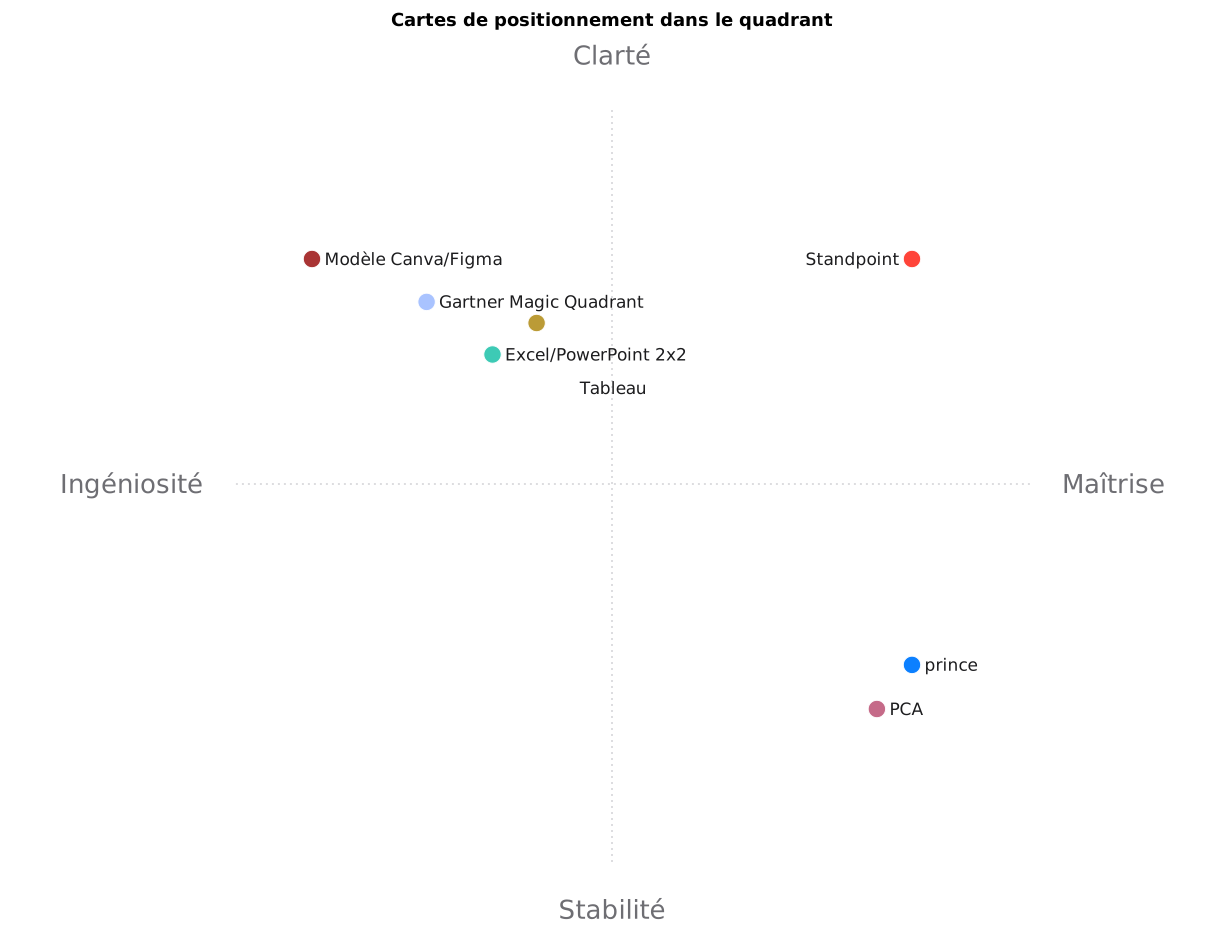
L'outil se juge lui-même : les boîtes à outils statistiques d'un côté, les outils de mise en page de l'autre et le coin visé au croisement des deux.
Le même moteur s'atteint par sept chemins :
- Une bibliothèque Python s'importe dans votre code (
import standpoint). - Deux commandes jumelles se tapent dans un terminal et comptent pour deux chemins.
- Une interface graphique s'ouvre dans le navigateur.
- Une API HTTP est une porte par laquelle d'autres programmes appellent l'outil par le réseau.
- Un serveur s'adresse aux agents d'intelligence artificielle, au protocole Model Context Protocol (MCP).
- Une version entièrement statique traduit le moteur en WebAssembly, un format que tous les navigateurs savent exécuter. Elle tourne donc chez le visiteur, sans serveur.
Cette dernière version est en ligne à deraison.ai/standpoint. Collez votre tableau, récupérez la carte, sans rien installer. L'outil installé sur votre poste et la version en ligne ne nomment pas les axes de la même façon. Sur votre poste, Standpoint choisit le meilleur modèle local que votre machine sait faire tourner. Dans le navigateur, la page charge une seule fois le petit modèle distillé décrit plus haut, qui nomme les axes et remplit les cases vides quand vous le lui demandez. La figure, elle, est du SVG écrit à la main, sans bibliothèque de dessin. Chaque trait est choisi.
Prises une à une, les pièces n'impressionnent personne. Le calcul, Pearson le faisait à la main en 1901. Le modèle de poche sait faire ses trois petites tâches et rien d'autre. Restent un dessin sans bibliothèque, un format de tableau que n'importe qui sait écrire et un onglet de navigateur. Tout l'intérêt vient de l'assemblage, où chaque pièce passe à la suivante ce qu'elle ne sait pas faire.
L'ensemble tourne dans un onglet parce que chaque pièce est petite. Vos notes sur vos concurrents restent chez vous sans qu'aucun contrat ait à le promettre, puisqu'il n'existe aucun serveur pour les recevoir. Gartner emploie une année d'entretiens et des équipes d'analystes pour situer un marché. Standpoint ne prétend pas à cela, c'est entendu. Mais il tourne dans la page que vous êtes en train de lire, où tout se vérifie ligne à ligne.
Essayer sur votre propre tableau
Un tableau honnête mérite mieux qu'une lecture à l'instinct. La carte laisse le tableau à sa place et lui ajoute la vue d'ensemble, celle qui vous dit quelles lignes relire de près. Ses axes restent des mélanges de vos propres critères. Chaque position se retrace donc jusqu'aux chiffres de départ, gardés dans le fichier YAML de sortie.
Pour vous faire une opinion, essayez : deraison.ai/standpoint fait tourner le moteur dans votre navigateur, sans installation ni téléversement.
Le code est open source, sous licence BSD : pip install standpoint, puis une commande sur votre CSV. Le code, les exemples et la documentation se trouvent sur github.com/warith-harchaoui/standpoint. Il ne manque plus que votre tableau pour savoir où vous vous situez.