Posez une question sur vos données à un assistant conversationnel. Le modèle de langage qui le fait marcher répond un chiffre, avec l'aplomb d'un élève qui n'a pas ouvert son livre. Le chiffre est plausible. Il est faux. Personne, en comité de direction, ne signe sur un chiffre plausible. Ce blocage suffit à arrêter un déploiement en entreprise.
D'abord, trois mots. Une base de données est un ensemble de grands tableaux, cousins des feuilles de calcul : une table des clients, une table des factures, des milliers de lignes chacune. Une requête est une question posée à ces tableaux. Elle s'écrit en SQL, un langage rigide et sans double sens qui dit quelles lignes prendre et quoi en faire. Le modèle de langage comprend le français et il sait écrire du SQL.
Le remède enlève au modèle le droit d'écrire le chiffre. Mieux poser la question n'y changerait rien. Le modèle écrit la requête et la base répond, avec ce qu'elle contient. La nuance a l'air de rien et elle change la nature de l'erreur. Une requête fausse se voit, se garde, se rejoue, se corrige. Un chiffre inventé ne se voit pas, puisqu'il a la même tête qu'un chiffre juste.
Cet article suit quatre questions vraiment posées à un déploiement en entreprise. Elles arrivent en réunion dans cet ordre : un chiffre du mois dernier, une prédiction ligne à ligne, une prévision à trois mois, puis un graphique. Elles occupent trois étages sur un même socle. Leurs noms se lisent comme des adresses : txt2sql pour le chiffre, txt2sql2ml pour la prédiction et la prévision, txt2sql2viz pour la figure. L'industrie connaît bien le premier étage. Les deux autres sont beaucoup plus rares. Ce sont ceux que j'ai construits.

Le socle est le même aux trois étages : la question devient une requête, la requête est analysée avant d'être exécutée, la base répond. Seul le dernier maillon change.
« Combien de factures sont en retard de paiement ? »
Treize, répond l'écran en deux secondes. Et dépliée sous ce treize, la requête qui l'a produit.
SELECT COUNT(*) FROM invoices WHERE status = 'overdue' LIMIT 500
Cette ligne se déchiffre sans avoir jamais lu de SQL. Elle compte (COUNT) les lignes de la table des factures (invoices), garde celles dont le statut vaut « en retard » (overdue) et n'en ramène jamais plus de cinq cents (LIMIT 500).
Cette ligne affichée est la preuve du chiffre. Quelqu'un qui connaît la base la lit, la conteste, la relance. Le chiffre se vérifie au lieu de se croire.
Un modèle de langage récent écrit très bien du SQL en général. La difficulté commence avec cette base-là. Il lui faut les bons noms de tables, les bonnes jointures et surtout les bonnes valeurs de filtre. Une jointure rapproche deux tables par une colonne commune, les factures et leurs clients par exemple. Le statut d'une facture impayée s'écrit-il overdue, unpaid ou 3 ? Les noms et les jointures sont écrits dans le schéma, la liste des tables et de leurs colonnes. Les valeurs, elles, n'y sont pas : il faut aller les lire dans les tables. Un modèle sans ce schéma invente des noms qui ont l'air justes et qui sont faux. Un outil qui traduit une question en requête se juge donc à sa manière de coller à la base qu'on a devant soi.
Deux chemins mènent là. Le premier renvoie le modèle à l'école : le réglage fin, ou fine-tuning, reprend son entraînement sur les données du client jusqu'à ce qu'il les connaisse par cœur. Il coûte cher, il prend du temps et tout recommence dès que la base change. Le second laisse le modèle tel quel et lui glisse, à chaque question, une fiche de révision avec les quelques informations utiles pour cette question-là2. Cette méthode s'appelle la génération augmentée par récupération, en anglais Retrieval-Augmented Generation ou RAG. Vanna, l'outil libre de référence du domaine, suit ce second chemin1.
Chez Vanna, « entraîner » veut dire autre chose qu'ailleurs. C'est le point qui déroute le plus : le mot désigne le remplissage d'une base de connaissances que le système consultera au moment de répondre. Le modèle reste intact : aucun de ses réglages internes ne bouge. Imaginez une bibliothèque où l'on range des textes. Quand une question arrive, on y cherche les textes qui parlent de la même chose, même avec d'autres mots, puis on les joint à la question posée au modèle3.
Ce qui entre dans la bibliothèque et ce qui compte le plus
Trois contenus entrent dans cette bibliothèque et l'intuition se trompe sur leur poids.
Première étagère, la structure des tables : le CREATE TABLE de chaque table. C'est sa carte d'identité : son nom, ses colonnes, le type de chacune (nombre, texte ou date) et ses clés, qui la relient aux autres tables. Le modèle y découvre ce qui existe et n'a plus à l'inventer. Chaque table occupe sa propre fiche, pour ressortir seule quand une question la concerne.
Deuxième étagère, la documentation métier dit ce que la structure tait : comment se calcule une mesure, ce que veut dire le vocabulaire maison, à quoi correspondent les valeurs codées. Une phrase par fiche, écrite comme un utilisateur la dirait : « Le chiffre d'affaires hors taxes des commandes s'obtient en additionnant orders.total_ht_eur. » C'est ici qu'on gagne le plus, parce que c'est ici qu'un modèle sans contexte se trompe.
Troisième étagère, les paires question-requête, dernières écrites et premières dans les résultats. Une question en français, la requête juste à côté. La documentation de Vanna le dit sans détour : leur qualité décide du résultat1. Le mécanisme explique pourquoi. À chaque question, le système montre au modèle les quelques fiches les plus proches et le reste de la bibliothèque n'existe plus pour lui. Un bon exemple, voisin de la question posée, vaut donc mille exemples lointains. On range pour couvrir des cas, jamais pour faire du volume.
Vingt à cent paires vérifiées suffisent à démarrer9. Elles doivent couvrir les familles de questions que les gens vont poser : compter, croiser deux tables, filtrer sur une valeur codée, classer les plus gros. Cet ordre de grandeur vaut pour une base de cette taille. Ailleurs, il dépend du nombre de tables, de l'ambiguïté du vocabulaire, du nombre de métiers couverts et surtout des questions que les gens posent vraiment.
Deux règles décident de ce qui entre dans la bibliothèque.
- Toujours du SQL vérifié, exécuté pour de vrai et confirmé juste : une paire fausse apprend au système à produire du SQL faux.
- Jamais de
SELECT *: cette requête ramène toutes les colonnes sans en nommer aucune, donc elle n'apprend aucun nom de colonne.
Deux verrous entre le modèle et la base
Le travail du modèle s'arrête à la requête. Elle s'exécute ailleurs, sous un compte autorisé à lire la base et jamais à la modifier. Avant de la lancer, des garde-fous l'analysent : ils la découpent comme on fait l'analyse grammaticale d'une phrase, sujet, verbe, compléments. Ce découpage s'appelle un arbre syntaxique4 et c'est en le lisant que la chaîne refuse tout ce qui n'est pas une simple lecture. Cette séparation protège la base : la partie qui parle au modèle n'a jamais le droit d'y écrire.
Un échec daté a forgé le second verrou. Le 4 septembre 2026, le modèle connaissait les noms et les types des colonnes et personne ne lui avait montré les valeurs qu'elles contiennent. Sur la table des factures, il a écrit WHERE status = 'confirmed'. La requête était correcte, les garde-fous l'ont acceptée, elle a tourné sans erreur et elle a rendu zéro ligne. Les factures ne connaissaient que paid, overdue et sent. Le mot confirmed existait bien, mais dans la table des commandes. À l'écran, un résultat vide et pas un mot d'explication.
Le défaut se répare des deux côtés. Prévenir d'abord : on s'occupe des colonnes à peu de valeurs différentes, un statut, une catégorie, jamais un montant. La base livre la liste réelle de leurs valeurs et le modèle la reçoit avec le reste. Les premières servies sont les colonnes dont la base connaît d'avance la liste exacte. Viennent ensuite les colonnes de texte que ses statistiques signalent comme peu variées, relues par une lecture limitée. Une colonne sans statistiques, on ne la sonde jamais, parce qu'une liste fausse ferait pire que pas de liste.
Guérir ensuite. Une requête qui s'exécute sans erreur et ne ramène aucune ligne, parce qu'elle filtre sur une valeur absente de la colonne, ne rend plus un vide muet. Le système retente sa chance une fois, vraies valeurs en main. Au second échec, la réponse nomme la colonne, la valeur inventée et les valeurs réellement présentes.
L'examen qui prouve que le rangement a servi
On saute trop souvent cette étape, la seule pourtant qui prouve que tout ce rangement a servi. On met de côté quelques paires question-requête qu'on ne range pas dans la bibliothèque, pour s'en servir d'examen. Un professeur sérieux ne note pas un élève sur des exercices dont il a le corrigé sous les yeux. Une mesure sur des questions déjà rangées évalue seulement la capacité du système à ressortir un exemple appris.
Les points se comptent de trois façons, de la moins fiable à la plus fiable.
- Le taux de SQL valide sert de simple garde-fou, puisqu'une requête peut être valide et fausse.
- La comparaison caractère par caractère des deux requêtes sous-estime beaucoup la justesse, parce que deux requêtes justes s'écrivent presque toujours différemment5.
- La comparaison des résultats est la bonne et la plus simple aussi : on exécute la requête produite et la requête de référence, puis on compare ce qu'elles rendent.
Les bancs d'essai du domaine, Spider6 et BIRD7, emploient cette mesure. Toutes les équipes se comparent sur ces jeux publics de questions. Elle gagne parce qu'elle regarde ce que l'utilisateur recevra vraiment, la réponse.

Sur le jeu de contrôle, la documentation métier et les exemples font passer la part de réponses justes de 62,5 % à 87,5 %. Trois exemples ajoutés sur les deux familles en retard, les jointures et un filtre, l'amènent à 100 %. La même mesure rejouée sur trois tailles de base donne le même résultat : la bibliothèque d'exemples déplace la note et le volume de données ne la déplace pas. Attention à ne pas surinterpréter ces chiffres. Le jeu de contrôle est petit et les scores s'y déplacent par paliers de 12,5 points, ce qui dit assez sa finesse. Ce 100 % signifie que rien ne manque sur ces questions-là. Il ne dit pas que la chaîne est juste en général, car une étude de cas ne vaut pas un banc d'essai.
La note globale a un défaut : elle cache la famille de questions qui échoue8. Découpée par famille (comptages, croisements de tables, filtres, classements), elle se met à dire quoi faire ensuite. Des croisements faibles réclament des exemples de croisements, pas un modèle plus gros. Le saut de 87,5 % à 100 % sur la figure vient de là.
« Quels clients risquent de partir et avec quelle confiance ? »
Un chiffre exact répond à une question sur le passé : combien avons-nous facturé le mois dernier, quels clients ont dépassé leur budget ? Le dirigeant pose juste après une autre question, sur l'avenir. Jusqu'ici, elle demandait un projet de plusieurs mois, confié à des spécialistes des données et à refaire pour chaque client et chaque question.
Changeons ce que la requête rapporte. Elle ramène désormais un tableau dont la dernière colonne est celle qu'on veut prédire. Cette colonne est remplie pour certaines lignes et vide pour celles qu'on veut prédire.
| Client | Segment | Récence | Fréquence | Tickets | Parti ? |
|---|---|---|---|---|---|
| Studio Moreau | PME | 12 j | 8 | 1 | non |
| Fabrique Horizon | Grand compte | 190 j | 1 | 4 | oui |
| Maison Central | PME | 45 j | 5 | 0 | ? |
Une seule question, une seule requête : les trous se remplissent. Le SQL ne sait pas prédire, il sait aller chercher la bonne forme de tableau.
Ce tableau contient les exemples et la question. Un modèle tabulaire fondationnel le lit tel quel. Son éducation est finie : il a été entraîné une seule fois, dans son laboratoire, sur des millions de tableaux fabriqués pour l'exercice. Il ignore tout de vos données et il connaît la façon dont un tableau se comporte. Pensez à un correcteur qui a lu des milliers de copies et qui repère une erreur du premier coup d'œil sur une copie qu'il n'a jamais vue. On lui montre le tableau et il remplit les trous en une seule fois. Rien n'est entraîné sur vos données, aucun réglage interne ne bouge, aucun modèle n'est à stocker.
Cela s'appelle l'apprentissage en contexte et tout le monde l'a déjà vécu. On donne un exemple à un assistant conversationnel dans la conversation même : il comprend sans qu'on le réentraîne10. La comparaison a pourtant une limite. Un texte se lit de gauche à droite, alors qu'un tableau n'a d'ordre ni entre ses lignes ni entre ses colonnes. Ces modèles ont dû résoudre ce problème-là.
La conséquence est directe : aucun projet d'entraînement, rien à maintenir, aucun modèle à réentraîner le jour où l'on branche un nouveau client. Et le même code sert à quatre choses.
- Il prédit une catégorie, par exemple partira ou ne partira pas.
- Il prédit un nombre, par exemple le montant du mois prochain.
- Il remplit des trous.
- Il classe les N premiers.
Deux écoles européennes, puis NVIDIA : pourquoi j'ai choisi TabICL
Jusqu'à l'automne 2026, deux équipes européennes menaient ce domaine. À Fribourg-en-Brisgau, autour de Frank Hutter, l'école allemande a produit TabPFN, publié dans Nature en janvier 202511. SAP a racheté Prior Labs, sa suite industrielle, avec plus d'un milliard d'euros engagés sur quatre ans12. C'est un signal de marché, sans valeur de preuve technique.
L'école française travaille à l'Inria Saclay, dans l'équipe SODA, autour de Gaël Varoquaux, co-créateur de scikit-learn. Son modèle, TabICL, a été présenté à la conférence ICML en 2025. Il fait jeu égal en justesse avec TabPFN v2 sur deux cents jeux de données de classification. Il va jusqu'à dix fois plus vite et passe devant en justesse au-delà de dix mille lignes13. La deuxième version, TabICLv2, est sortie en février 202614. Les comparaisons de cet article visent la première.
J'ai choisi TabICL, et pas par patriotisme. Les deux modèles tournent chez le client sans que rien ne sorte. Les deux publient leurs poids, les réglages appris pendant l'entraînement. TabICL publie en plus le code qui a servi à l'entraîner14, générateur de données compris. Avec les poids seuls, on refait tourner les prédictions. Avec le code d'entraînement, on refait le modèle depuis zéro. Le jour où l'on annonce à un dirigeant « ce client va partir », il faut pouvoir montrer d'où vient la réponse.
Le 29 septembre 2026, NVIDIA a publié Kumo Tabular, entraîné lui aussi sur des tableaux fabriqués de toutes pièces. Sans aucun réglage, il arrive premier sur TabArena23. Ce banc d'essai public a été présenté en 2025 à la conférence NeurIPS25. Tous les modèles y passent la même épreuve sur cinquante et un jeux de données réels, retenus parmi mille cinquante-trois. Ce rang sort des calculs de NVIDIA et je n'en ai trouvé aucune reproduction indépendante. En vidéo, Jure Leskovec, professeur à Stanford, va plus loin au nom de NVIDIA24 : le modèle battrait les « grands maîtres », les meilleurs compétiteurs humains, sur de nombreux concours Kaggle. Cette affirmation est orale et aucune mesure publiée ne l'établit.
TabArena classe les modèles comme on classe les joueurs d'échecs, par la note Elo. Sur chaque jeu de données, le modèle qui prédit le mieux gagne la partie. La forêt aléatoire réglée par défaut, un modèle classique et robuste, sert de repère à 1 000 points. Une avance de 400 points prédit dix victoires pour une défaite. Kumo Tabular affiche 1 950 points, 950 de plus que la forêt. Faisons le compte : deux tranches de 400 points donnent dix fois dix, cent victoires pour une défaite, avec encore 150 points d'avance. Le calcul lui prédit donc de battre la forêt sur plus de 99 jeux sur 100. La note compte les victoires sans regarder leur ampleur, ses auteurs l'écrivent eux-mêmes : gagner d'un cheveu vaut autant que gagner de loin.
Ce premier rang laisse intact le choix fait ici. NVIDIA publie les poids sous OpenMDW 1.1, une licence gratuite qui permet l'usage commercial26. Kumo Tabular peut donc s'installer chez un client au même titre que TabICL, placé sous licence BSD comme scikit-learn. Mais la recette d'entraînement et le générateur de tableaux restent promis pour « bientôt ». Avec Kumo Tabular, on refait tourner les prédictions. Avec TabICL, on refait aussi le modèle depuis zéro. Que NVIDIA publie sa recette et la question se rouvrira.
Les équipes se lisent les unes les autres et le disent. Le code de prévision de TabICL vient de TabPFN-TS, écrit par l'équipe allemande : il reste donc sous la licence de Prior Labs27. Le billet de Kumo Tabular dit lire le tableau « comme l'ont introduit TabICL et TabPFN ». Son premier auteur, Jingang Qu, est aussi le premier auteur de TabICL, écrit à l'Inria. Il se présente aujourd'hui comme ingénieur chez NVIDIA, à Paris. SAP a racheté l'entreprise de TabPFN, NVIDIA a recruté le premier auteur de TabICL. Vingt mois se sont écoulés entre l'article de Nature et le billet de NVIDIA. Ils ont suffi pour que ces modèles sortent du laboratoire et battent des chaînes automatiques réglées pendant quatre heures sur les données elles-mêmes, comme AutoGluon, la référence de TabArena.
Trois libertés se confondent facilement.
- Lire un modèle, comprendre comment il marche, est offert à tout le monde par les articles et les billets.
- L'installer chez un client ne dépend que de la licence.
- Le refaire depuis zéro réclame le code d'entraînement.
Aujourd'hui, Kumo Tabular accorde les deux premières et TabICL les trois. Entre deux modèles qu'on a le droit d'installer, je choisis celui qu'on sait refaire.
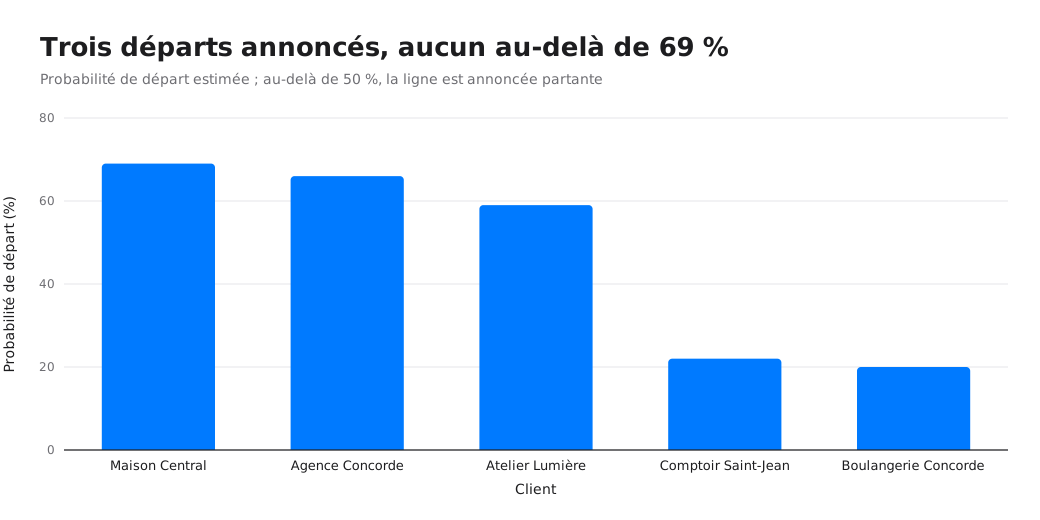
La réponse ligne à ligne, sur les clients dont le statut de départ n'est pas consolidé. Trois départs annoncés, aucun au-delà de 69 % : chaque prédiction vient avec sa confiance et celle-ci reste modeste.
Ce 69 % se lit presque toujours de travers. On croit y voir une certitude à 69 % que ce client va partir. Prenez plutôt les clients qui ressemblent à celui-là sur les colonnes observées : environ soixante-neuf sur cent sont partis. Le nombre décrit une fréquence constatée. Il ne prédit rien sur une personne.
Deux choses très différentes rendent ce chiffre incertain et les confondre coûte cher. La première est notre ignorance : l'historique compte peu de clients comparables, donc l'estimation bougerait si on ajoutait des données. La seconde vient du hasard du monde : un historique parfait n'empêcherait pas deux clients identiques sur le papier de décider autrement l'un que l'autre. Davantage de données réduisent la première. La seconde ne diminue jamais, ce qui explique qu'une prédiction honnête reste prudente.
Une règle vaut pour les trois étages : un chiffre sans son incertitude est une opinion déguisée en fait. Sur ces données, aucune prédiction ne dépasse 69 % et c'est bon signe. Un outil qui aurait annoncé 97 % aurait menti.
Savoir qui va partir ne sert à rien sans savoir pourquoi. On retient un client avec une raison assez précise pour qu'on puisse agir, jamais avec une probabilité.
Le commerce a nommé ce problème bien avant la statistique. Sa formule la plus célèbre dit : « La moitié de l'argent que je dépense en publicité est gaspillée ; l'ennui, c'est que je ne sais pas laquelle. » On la prête à John Wanamaker, patron de grand magasin américain, sans que ses archives en gardent trace15.
Cet ennui existe bel et bien. Il est même mal posé : aucune mesure ne peut le trancher. La vente a eu lieu une fois. Ce qui serait arrivé sans l'affiche dans le métro, personne ne le saura jamais, parce que ce monde-là n'a pas existé. Partager le mérite entre les canaux relève donc forcément d'une convention : on choisit une règle de partage, puis on l'assume.
Mesurons le poids du choix de la règle sur une petite expérience. Prenons deux canaux publicitaires, l'affichage et la publicité en ligne, achetés ensemble. Ils montent et baissent de concert : leur corrélation vaut 0,84 sur deux cents semaines simulées, sur une échelle qui s'arrête à 1. Par construction, seul l'affichage agit sur les ventes et l'en ligne voyage en passager. Interrogeons maintenant chaque canal sur ce qu'il explique.

Le même canal, les mêmes données, deux réponses incompatibles : la seule différence est l'ordre dans lequel on pose la question.
Tout se joue dans les deux premières barres. Interrogé seul, le canal en ligne explique 55,3 % de la variation des ventes, de quoi faire un beau tableau de bord. Posé à côté de l'affichage, il tombe à 0,0 %. L'ennui de Wanamaker tient dans ces deux chiffres.
Le partage de Shapley, dont je reparle plus bas, fait la moyenne des deux ordres et tranche : 52,5 % à l'affichage, 27,7 % à l'en ligne. Vérifions : l'affichage reçoit la moyenne de 80,1 et 24,8, l'en ligne celle de 55,3 et 0,0. Les deux parts font 80,1 % à l'arrondi près, ce que les deux canaux expliquent ensemble. Cette égalité n'a rien d'un hasard heureux, car Shapley a exigé que les parts s'additionnent. C'est ce qui permet de présenter le résultat à un comité de direction. Le protocole est publié, à refaire plutôt qu'à croire : deux cents semaines simulées, graine aléatoire 20260925, régression linéaire. On mesure la valeur d'un groupe de canaux à la part des variations de ventes qu'il explique.
Regardez pourtant les 27,7 % accordés à l'en ligne : nous savons, puisque nous avons fabriqué l'exemple, que ce canal ne cause rien. La méthode n'a pas fauté pour autant. Elle répond fidèlement à la question posée : qu'est-ce que le modèle a utilisé ? Cette question diffère de celle-ci : qu'est-ce qui a causé la vente ? Celle-là n'a pas de raccourci. Il faut une expérience : couper le budget d'un canal sur une région et comparer avec les autres. Le partage explique le modèle et seule l'expérience atteint la cause.
Revenons à notre 69 %. Le modèle l'a produit d'un seul coup, en regardant une dizaine de colonnes à la fois. Quelle part vient de l'ancienneté du contrat, quelle part du nombre de réclamations, quelle part du dernier montant facturé ? Découper ainsi un résultat en parts, une par variable, s'appelle l'attribution. Rien ne garantit d'avance qu'elle soit possible, parce que le modèle n'a pas calculé son nombre comme une somme. Il a tout mélangé. L'attribution reconstruit donc, une fois le calcul fini, un partage qui n'existait pas dans le calcul.
Un essai naïf montre la difficulté. Pour mesurer ce qu'apporte une variable, retirons-la et regardons de combien la prédiction baisse. Seulement, la réponse dépend de l'ordre dans lequel on retire les autres. Si rien n'a encore été retiré, enlever l'ancienneté du contrat fait beaucoup baisser la prédiction. Le même retrait ne change presque rien si le nombre de réclamations est déjà parti, parce que les deux disent en partie la même chose. Il y a donc autant de réponses que d'ordres possibles.
La solution date de 1953 et visait un tout autre usage. Lloyd Shapley cherchait à partager équitablement le gain d'une équipe entre ses membres, quand chacun apporte autre chose et que les apports se recouvrent16. Son idée est simple : puisque l'ordre change le résultat, regardons tous les ordres possibles et prenons la moyenne. Pensez à une addition au restaurant. Selon qui arrive en premier et ce qu'on partage, la part de chacun change. La moyenne sur tous les ordres d'arrivée donne un partage que personne ne peut contester. Le prix Nobel d'économie a récompensé ces travaux en 2012. Appliqué à une prédiction au lieu d'un dîner, le même calcul dit combien chaque variable a pesé et dans quel sens17.
Une seconde méthode part d'une autre idée, tout aussi simple. Un modèle compliqué reste compliqué, mais autour d'un seul client il se comporte presque comme une droite, de la même façon qu'une courbe paraît droite quand on zoome assez. Dans ce petit voisinage seulement, on fabrique donc un modèle simple qui imite le gros. Il ne reste qu'à lire ses coefficients18.
L'outil montre les deux méthodes côte à côte. D'accord entre elles, elles donnent une lecture solide. Quand elles divergent, la divergence est déjà une information : la prédiction dépend d'un équilibre fragile entre variables et mieux vaut le savoir avant d'appeler le client.
« Quelle est la prévision du chiffre d'affaires pour les trois prochains mois ? »
Même socle, même modèle, autre question. La requête ramène cette fois une série dans le temps et la réponse vise des mois qui n'existent pas encore.
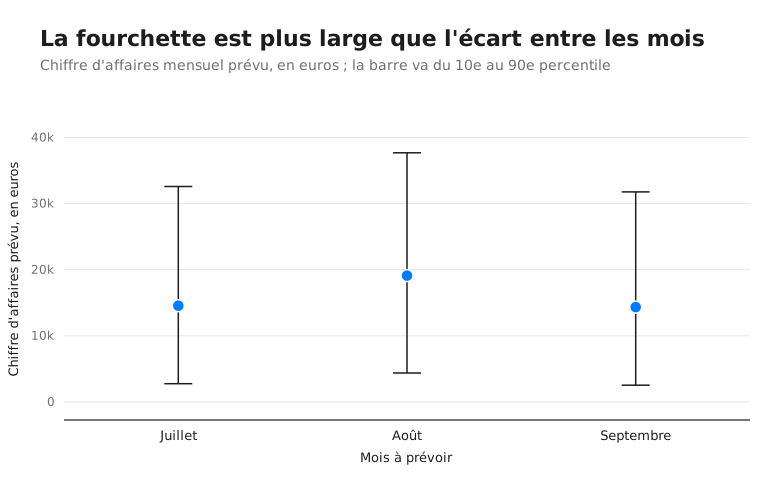
Chaque mois prévu affiche sa fourchette, du dixième au quatre-vingt-dixième percentile. Un percentile découpe les valeurs possibles en cent parts. Le dixième est celle au-dessous de laquelle il n'y a qu'une chance sur dix de tomber, le quatre-vingt-dixième celle au-dessous de laquelle il y en a neuf sur dix. Entre les deux, il reste huit chances sur dix et c'est ce que dit la barre.
Un seul chiffre sur l'avenir, c'est de la voyance. Un chiffre avec sa fourchette, c'est une décision. Cette figure annonce une nouvelle désagréable qu'il faut savoir lire : la fourchette dépasse l'écart entre les trois mois. Août a beau paraître meilleur que juillet, les barres se recouvrent presque entièrement et l'écart entre ces deux mois ne veut rien dire.
La donnée est mauvaise, l'outil n'y est pour rien. Dans cette base de démonstration, la série mensuelle n'est que du bruit, des sauts sans aucune régularité. Vingt et un mois y alignent 293 euros un mois, 72 380 un an plus tard et trois mois manquants. Aucune méthode ne prévoit cela. Seule une fourchette large répond honnêtement. Trois beaux chiffres alignés auraient maquillé la situation. Le principe est le même qu'au premier étage : la promesse vise l'incertitude affichée à côté de la réponse, jamais la qualité de la réponse elle-même.
Un détail d'implémentation montre dans quel monde on travaille. Le nombre de mois à prédire se lit dans la question de l'utilisateur, donc dans du texte libre. « Dans cent mille mois » devenait cent mille mois à prévoir. Cent mille mois, plus de huit mille ans ! La machine sortait des dates absurdes et se bloquait sur un calcul que personne n'avait demandé sérieusement. Ce nombre est maintenant borné : au-delà, une prévision n'a de toute façon aucune valeur, donc on ne perd rien.
« Montre-moi où se concentre le chiffre d'affaires »
Dernière question, dernier maillon différent : le résultat devient une figure, choisie automatiquement selon la forme des données et ce que demande la question, puis dessinée sur le moment. Il n'y a donc aucun tableau de bord à entretenir. Un tableau de bord est une page de graphiques figés, préparée à l'avance. Il répond aux questions qu'on avait prévues en le construisant, il y a six mois.
Ce choix est l'endroit où un modèle de langage peut faire n'importe quoi. Montrez-lui cent soixante-huit noms de graphiques : il arrive qu'il en invente un, qu'il en écorche un autre ou qu'il en choisisse un qui ne va pas avec les colonnes présentes. Il propose par exemple une carte quand aucune colonne ne contient de lieu. Compter sur sa bonne volonté ne protégerait de rien. La protection se trouve dans la forme du programme, là où le modèle ne peut pas passer à côté.

Trois étapes déterministes alternent avec les deux appels au modèle. Les étapes 1, 3 et 5 se passent de modèle, donc de surprise. La troisième étape élimine tout candidat structurellement incompatible avant que le modèle ne voie quoi que ce soit. La quatrième ne peut que réordonner et annoter cette liste déjà sûre, jamais l'étendre.
Le modèle choisit un plat dans un menu qu'il n'a pas écrit. Cette garantie est d'une autre nature qu'un réglage de température, qui rend le modèle plus ou moins aventureux, ou qu'une consigne ajoutée au début de la conversation. Elle dépend de la forme du programme et jamais de la docilité du modèle. Comme au premier étage, elle rend l'erreur qui reste visible et réparable : une figure mal choisie se corrige d'un clic, sans jamais se confondre avec une figure juste.
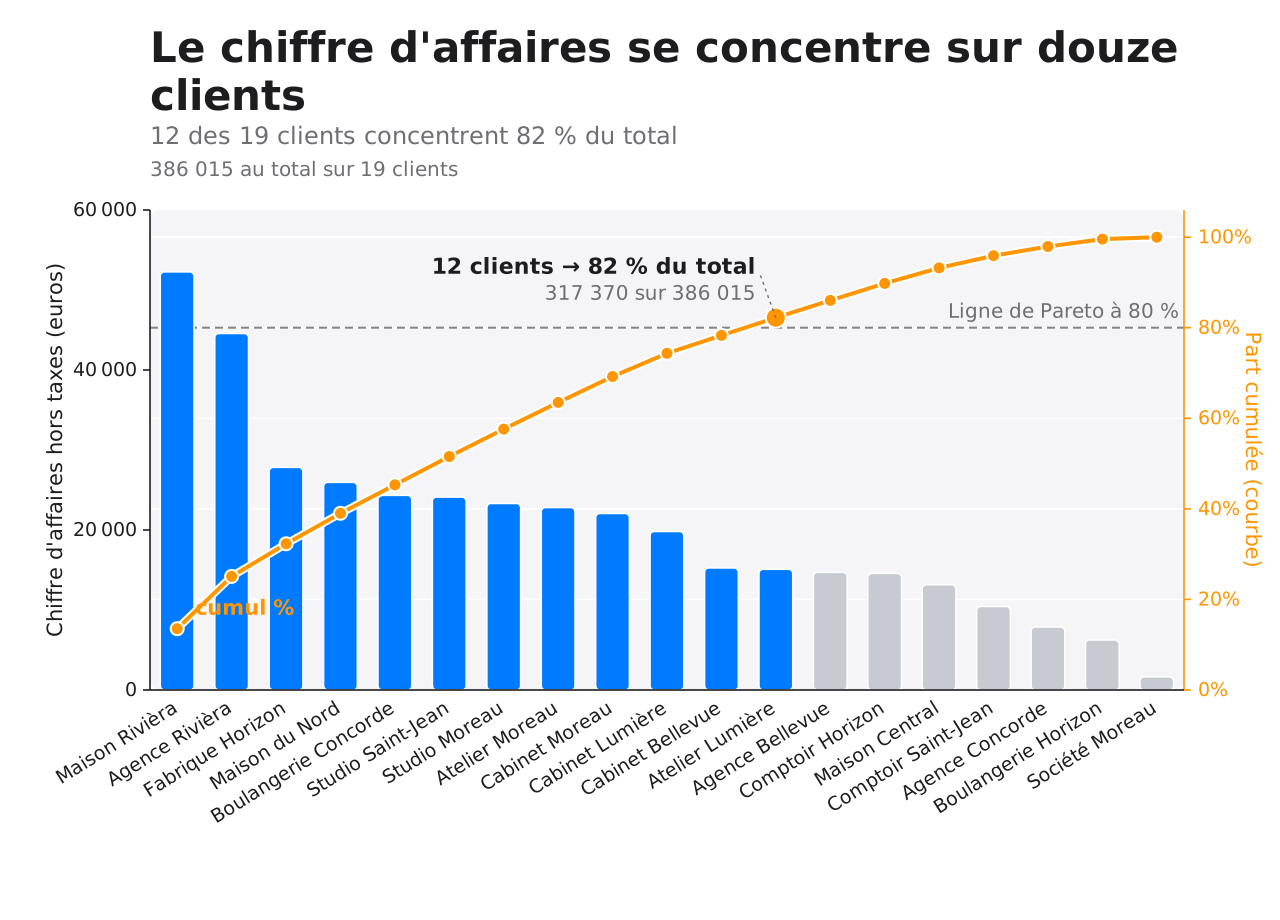
La réponse à la question posée : douze des dix-neuf clients que la requête a ramenés font 82 % du chiffre d'affaires. La part cumulée se calcule sur ces dix-neuf clients et la précaution compte. Un diagramme de Pareto classe les contributions de la plus grosse à la plus petite, puis trace à côté la courbe de leur cumul. On lit ainsi d'un coup d'œil combien de clients font l'essentiel du total. Tracé sur un palmarès déjà tronqué en amont, il annonce une part « du total » qui n'en est pas une, malgré sa belle courbe.
Le dessin revient à sprezzature.ai, un moteur de figures libre21. Cent soixante-huit types de graphiques garnissent son catalogue, des courbes aux diagrammes de flux, en passant par les treemaps, les cascades et les cartes. Plus le catalogue est large, plus il offre de graphiques compatibles avec les colonnes qu'on a et plus le choix automatique tombe juste.
Chaque figure obéit en plus à des règles d'accessibilité et de couleur.
- Le contraste est vérifié.
- Une personne daltonienne lit la figure sans peine.
- Une information ne dépend jamais d'une couleur seule.
- Tout axe où monter vaut mieux que descendre indique son sens de lecture.
Rien de cosmétique là-dedans. Personne ne lit un graphique mal contrasté projeté dans une salle. Un graphique qui demande de distinguer deux verts exclut un homme sur douze. Ces règles descendent de la sémiologie graphique, qui étudie ce que les formes visuelles savent vraiment transmettre19, et de mesures sur la perception20. Ici, elles sont des lignes de code et non des recommandations.
Ce que la production apprend et que la préparation ne devine pas
Aucun rangement préparé à l'avance ne devine comment les gens vont formuler leurs demandes, leurs tournures, leurs raccourcis, les cas particuliers de chaque entreprise. Les vraies questions n'apparaissent qu'en production. Chaque question bien traitée, surtout chaque correction, apprend quelque chose que le rangement initial ignorait.
La boucle est simple. Quelqu'un pose une question, le système écrit la requête, qui s'exécute en lecture seule. Un humain valide le résultat ou corrige la requête. Une fois validée, la paire rejoint la bibliothèque d'exemples et la question suivante qui lui ressemble retrouvera ce nouvel exemple.
Une règle de sûreté ne souffre aucune exception et c'est la plus facile à rater : jamais d'apprentissage aveugle. Capturer automatiquement toutes les requêtes produites pour les réinjecter comme exemples empoisonne la bibliothèque pour toutes les questions semblables à venir. Du mauvais SQL apprend au système à produire du mauvais SQL. Une paire entre donc par un chemin dédié, qui rejoue les garde-fous et réexécute la requête avant de l'accepter. Même ce qu'on nous présente comme déjà vérifié repasse par là.
Un mécanisme qui marche sur un poste diffère par quatre propriétés d'une boucle qui tient en production.
- Persistance : la bibliothèque vit dans la base déjà en place22, et non dans une mémoire perdue au premier redémarrage.
- Idempotence : l'identifiant d'une paire est calculé à partir de son contenu, donc la soumettre deux fois ne crée pas de doublon.
- Traçabilité : chaque paire venue du terrain est marquée comme telle, à part du corpus rangé à la main. On vérifie ainsi ce que la production a appris au système et on retire un mauvais exemple précis.
- Mesure : après chaque lot d'ajouts, on repasse l'examen. Le progrès se constate au lieu de se supposer.
Trois jours devenus trois secondes, et la limite qui demeure
Hier, une question métier partait en ticket vers l'équipe data et revenait trois jours plus tard, la décision souvent prise sans elle. Une question sur l'avenir partait en projet. Aujourd'hui, on la pose à voix haute, la réponse chiffrée tombe en quelques secondes et la question suivante aussi. La réunion garde son rythme. Le gain se mesure en délai : entre la question et un chiffre fiable, on passe de trois jours à trois secondes, parce que le chiffre vient de la base. Trois jours contre trois secondes, le rapport vaut 86 400, le nombre de secondes d'une journée.
Le modèle peut toujours écrire une mauvaise requête. L'architecture garantit qu'on se borne à lire la base, dans des limites connues. Que la requête corresponde à ce que la personne voulait vraiment demander, elle ne le garantit pas. Sur ce point, elle réduit les façons de se tromper et les rend visibles, sans les supprimer. La vraie limite vient de la qualité du schéma et du vocabulaire, jamais du volume de données. La chaîne interroge la base directement et c'est le SQL qui filtre. Une base dont les colonnes s'appellent col_17 ne se laissera pas interroger en français et aucun modèle n'y changera rien.
Les trois lignes
txt2sql      question → SQL → base → le chiffre réel
txt2sql2ml   question → SQL → tableau à trous → la prédiction et sa fourchette
txt2sql2viz  question → SQL → lignes → le bon graphique, en direct
Un seul socle, trois étages et partout la même discipline : le modèle écrit la requête, le reste de la chaîne vérifie et répond. Le chiffre plausible du début avait seulement l'air juste. Celui-ci, on peut le relire, le relancer et le signer.
Remerciements
Merci chaleureusement à Marie Sacksick, Edmond Jacoupeau, Bachir Zerroug et Vincent Sammiez pour nos discussions fructueuses sur ces sujets.
Parlons IA.
Les figures de cet article ont été faites avec sprezzature.ai par Deraison.ai
 sprezzature.ai
 Deraison.ai
Bibliographie
Chacun de ces titres justifie une décision de conception prise plus haut. Les notices disent laquelle.
- Vanna AI. Training advice, documentation du projet. vanna.ai/docs/training-advice Pose sans détour la hiérarchie des trois contenus et la règle de sûreté reprise ici : la qualité des paires question vers requête est le principal déterminant du résultat et du mauvais SQL appris apprend au système à produire du mauvais SQL.
- Lewis, P. et al. (2020). « Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks », NeurIPS. arXiv:2005.11401 L'article qui a donné son nom à la génération augmentée par récupération. Il établit le principe employé au premier étage : laisser le modèle intact et lui fournir, à chaque question, les éléments de contexte utiles, plutôt que de réentraîner ses poids.
- Vanna AI (2023). How Vanna works, how to train it, data security. medium.com/vanna-ai Décrit pas à pas le mécanisme de récupération dont dépend tout le reste : la question est vectorisée, les connaissances les plus proches sont ramenées par type et seules celles-là entrent dans le contexte. C'est de là que vient la règle « la couverture prime sur le volume ».
- Mao, T. sqlglot, analyseur et transpileur SQL en Python, licence MIT. github.com/tobymao/sqlglot L'analyseur qui transforme la requête produite en arbre syntaxique avant toute exécution. C'est lui qui rend les garde-fous possibles : on inspecte la structure de la requête, pas une chaîne de caractères et l'on refuse tout ce qui n'est pas une lecture.
- Pourreza, M. et Rafiei, D. (2023). « Evaluating Cross-Domain Text-to-SQL Models and Benchmarks », EMNLP. arXiv:2310.18538 Montre que les notes des bancs d'essai sous-estiment les modèles, parce qu'une question en langue naturelle admet plusieurs requêtes justes. Justifie le choix de la correspondance à l'exécution contre la comparaison textuelle, fait ici.
- Yu, T. et al. (2018). « Spider: A Large-Scale Human-Labeled Dataset for Complex and Cross-Domain Semantic Parsing and Text-to-SQL Task », EMNLP. arXiv:1809.08887 Le banc d'essai qui a fixé les usages du domaine, à commencer par l'évaluation sur des bases jamais vues à l'entraînement. Le jeu de contrôle tenu à l'écart décrit ici en est la transposition à l'échelle d'un seul client.
- Li, J. et al. (2023). « Can LLM Already Serve as A Database Interface? A BIg Bench for Large-Scale Database Grounded Text-to-SQLs », NeurIPS. arXiv:2305.03111 Le banc d'essai BIRD, bâti sur de vraies bases, sales et volumineuses. Il documente l'écart entre une requête syntaxiquement correcte et une requête juste, qui est exactement l'écart que le bug du domaine de colonne a fait apparaître ici.
- Zavaleta, G. (2026). « Why 90 % accuracy in text-to-SQL is 100 % useless », Towards Data Science. towardsdatascience.com Défend la lecture par catégorie contre la note globale : une justesse moyenne élevée cache la famille de requêtes qui échoue, celle-là même qui décide de l'usage réel. C'est la lecture qui a désigné ici les jointures et un filtre et permis le renfort ciblé.
- NVIDIA. NeMo Agent Toolkit, text-to-SQL, documentation technique. docs.nvidia.com Donne indépendamment le même ordre de grandeur pour le corpus d'exemples et la même exigence de validation sur un jeu tenu à l'écart. Deux sources d'origines très différentes qui convergent sur « vingt à cent paires bien choisies ».
- Brown, T. et al. (2020). « Language Models are Few-Shot Learners », NeurIPS. arXiv:2005.14165 L'article qui a établi l'apprentissage en contexte : un exemple donné dans la conversation suffit à orienter le modèle, sans toucher à ses poids. Les modèles tabulaires fondationnels transposent exactement cette idée d'un texte à un tableau.
- Hollmann, N., Müller, S., Purucker, L. et al. (2025). « Accurate predictions on small data with a tabular foundation model », Nature, 637, 319-326. 10.1038/s41586-024-08328-6 TabPFN, l'école allemande. Établit qu'un modèle pré-entraîné une fois sur des tableaux synthétiques bat, en un seul passage et sans réglage, des méthodes ajustées sur les données elles-mêmes. C'est le résultat qui rend ce deuxième étage possible.
- SAP (2026). SAP Completes Prior Labs Acquisition, communiqué du 17 juillet 2026. news.sap.com Le rachat du laboratoire de Fribourg, annoncé en mai et clos en juillet 2026, avec plus d'un milliard d'euros engagés sur quatre ans. Cité ici comme mesure de l'intérêt industriel porté aux modèles tabulaires et non comme argument technique.
- Qu, J., Holzmüller, D., Varoquaux, G. et Le Morvan, M. (2025). « TabICL: A Tabular Foundation Model for In-Context Learning on Large Data », ICML. arXiv:2502.05564 L'école française. Une attention par colonnes puis par lignes construit une représentation de taille fixe pour chaque ligne, ce qui fait tenir des tableaux bien plus grands. Jeu égal avec TabPFN v2 sur deux cents jeux de données, jusqu'à dix fois plus rapide et au-dessus au-delà de dix mille lignes.
- Équipe SODA, Inria. tabicl, code et poids du modèle. github.com/soda-inria/tabicl La raison concrète du choix fait ici : le code d'entraînement, le code d'inférence et les poids sont publiés, donc auditables et exécutables chez le client, sans qu'aucune donnée ne sorte.
- « One-Half the Money I Spend for Advertising Is Wasted, But I Have Never Been Able To Decide Which Half », Quote Investigator, 11 avril 2022. quoteinvestigator.com Retrace la formule attribuée à John Wanamaker. La plus ancienne trace connue est un discours de 1919 qui la lui prête déjà ; ni les archives Wanamaker ni celles d'Unilever, pour la variante Leverhulme, n'en gardent trace. C'est la source du paragraphe sur l'attribution et la raison pour laquelle cet article présente la citation comme apocryphe plutôt que comme un fait.
- Shapley, L. S. (1953). « A Value for n-Person Games », dans H. Kuhn et A. Tucker (dir.), Contributions to the Theory of Games II, Princeton University Press, 307-317. L'article d'origine, écrit pour partager le gain d'une équipe entre ses membres. Il pose l'axiome qui fait tout : puisque l'ordre d'arrivée change la part de chacun, on moyenne sur tous les ordres. Shapley a reçu le prix Nobel d'économie en 2012 avec Alvin Roth. Soixante ans séparent ce texte de son usage en apprentissage automatique.
- Lundberg, S. et Lee, S.-I. (2017). « A Unified Approach to Interpreting Model Predictions », NeurIPS. arXiv:1705.07874 Importe en apprentissage la valeur de Shapley, qui répartit un gain collectif entre des joueurs selon leur contribution marginale moyenne. Appliquée à une prédiction, elle dit combien chaque variable a pesé et dans quel sens.
- Ribeiro, M. T., Singh, S. et Guestrin, C. (2016). « Why Should I Trust You? Explaining the Predictions of Any Classifier », KDD. arXiv:1602.04938 L'explication locale par substitut : on approche le modèle, au voisinage de la seule ligne examinée, par un modèle simple et lisible. Montrée ici à côté de la précédente, parce que deux méthodes qui divergent sur une ligne sont un signal en soi.
- Bertin, J. (1967). Sémiologie graphique. Les diagrammes, les réseaux, les cartes, Gauthier-Villars. Le traité qui établit qu'une forme graphique n'est pas un habillage mais un encodage et que chaque variable visuelle a ses propriétés propres. C'est le fondement du filtre déterministe : une figure incompatible avec les colonnes présentes ne doit jamais être proposée.
- Cleveland, W. S. et McGill, R. (1984). « Graphical Perception: Theory, Experimentation and Application to the Development of Graphical Methods », Journal of the American Statistical Association, 79(387), 531-554. 10.1080/01621459.1984.10478080 Classe expérimentalement les encodages visuels par précision de lecture, la position sur une échelle commune devant la longueur, elle-même devant l'angle et la surface. C'est la mesure qui justifie les règles appliquées automatiquement aux figures de cet article.
- Harchaoui, W. sprezzature-figures, moteur de figures libre. github.com/warith-harchaoui/sprezzature-figures Le catalogue de cent soixante-huit types de graphiques du dernier étage et le vérificateur qui accompagne chacun : contraste, polarité annoncée, étiquettes qui ne se chevauchent pas. Les sept figures de cet article en sortent.
- pgvector, extension de recherche vectorielle pour PostgreSQL, licence PostgreSQL. github.com/pgvector/pgvector Permet de ranger la base de connaissances dans le PostgreSQL déjà en place, donc sans rien déployer de neuf. C'est ce qui donne à la boucle d'amélioration sa persistance : les exemples validés survivent aux redémarrages et sont communs à toutes les instances du service.
- Qu, J. et al. (2026). Kumo Tabular, billet de présentation, NVIDIA, 29 septembre 2026. huggingface.co/blog/nvidia/kumo-tabular Le troisième modèle du genre, en trois tailles de vingt-huit à deux cent quinze millions de réglages internes, entraîné sur des tableaux synthétiques tirés de modèles causaux. Premier sur TabArena avec 1 950 points Elo en réglage par défaut, annoncé premier aussi sur trois autres bancs d'essai. Mesures faites par les auteurs eux-mêmes, à lire comme telles. La recette d'entraînement et le générateur de données sont annoncés pour plus tard. Le premier auteur se présente comme « Senior AI Engineer at NVIDIA », ingénieur principal en IA chez NVIDIA, sur github.com/jingangQu. Poids : huggingface.co/nvidia/Kumo-Tabular.
- Leskovec, J. (2026). Présentation vidéo de Kumo Tabular au nom de NVIDIA, LinkedIn, fin septembre 2026. linkedin.com/posts/leskovec Deux minutes de présentation. Les affirmations citées ici, cent millions de lignes en contexte, plus de quatre-vingt-onze modèles comparés sur TabArena, des grands maîtres de Kaggle battus, sont orales et sans mesures publiées. Elles sont rapportées comme telles.
- Erickson, N., Purucker, L., Tschalzev, A., Holzmüller, D., Mutalik Desai, P., Salinas, D. et Hutter, F. (2025). « TabArena: A Living Benchmark for Machine Learning on Tabular Data », NeurIPS 2025, Datasets and Benchmarks. arXiv:2506.16791 Le banc d'essai vivant des modèles tabulaires : cinquante et un jeux de données retenus parmi mille cinquante-trois selon des critères publics, une note Elo calée sur la forêt aléatoire par défaut à 1 000 points, AutoGluon réglé quatre heures comme référence. Le classement en ligne se consulte sur tabarena.ai.
- OpenMDW License 1.1, licence des poids de Kumo Tabular. openmdw.ai/license/1-1 Le texte qui tranche la question pour un usage professionnel. Il accorde gratuitement le droit d'utiliser, de modifier et de redistribuer le modèle « sans restriction », sans rien imposer sur ce que le modèle produit. Deux conditions seulement : garder la licence et les mentions d'origine quand on redistribue, et renoncer au modèle si l'on attaque en justice pour brevet ou droit d'auteur à son sujet.
- Équipe SODA, Inria. tabicl, fichier de licence. github.com/soda-inria/tabicl BSD trois clauses pour l'essentiel, avec une exception déclarée : le dossier de prévision est un travail dérivé de TabPFN-TS et reste sous licence Apache au nom de Prior Labs. La preuve concrète que les deux écoles se lisent, dans un document que personne n'écrit pour la galerie.
Deux lectures pour élargir. Mes livres préférés en IA donne la vue d'ensemble commentée. The Visual Display of Quantitative Information d'Edward Tufte traite de ce que le dernier étage automatise sans pouvoir le remplacer : le jugement sur la question que la figure doit poser.