En bref
L'apprentissage par renforcement (RL, pour reinforcement learning) apprend à une machine à agir par essais et erreurs, guidée par une récompense chiffrée. En 2018, Joelle Pineau a montré devant deux grands congrès pourquoi les résultats publiés de ce domaine inspiraient peu confiance. Nous avons repris sa liste de seize failles avec deux instruments. Le premier relit les articles de 2018 à 2026 avec sa grille de lecture, la liste des critères qu'elle notait dans chaque article. Le second refait ses expériences sous un protocole, un plan d'expérience écrit d'avance. Notre réponse, après avoir lu huit ans d'articles, refait ses expériences et proposé de nouvelles : Pineau a été écoutée sur ce qui se publie à côté du résultat, beaucoup moins sur la façon de juger le résultat lui-même.
- Ce qui a changé. Dans le RL classique, celui des robots et des jeux simulés, avec la même grille de lecture des deux côtés, le lien vers le code passe de 31 % à 74 % des articles, le calcul chiffré (la quantité de calcul que demandent les expériences) de 27 % à 58 %, l'effet d'un réglage montré (comment le résultat change quand on modifie un réglage) de 44 % à 80 %, une incertitude rapportée de 63 % à 88 %. Cette dernière hausse est la plus fragile : elle ne résiste pas à tous nos contrôles, l'analyse refaite en changeant un choix.
- Ce qui n'a pas bougé de façon détectable. Le test statistique (6 % puis 12 %), les méthodes de référence (celles auxquelles un article se compare) décrites avec tous leurs réglages, l'évaluation dans des conditions tenues à part, que l'agent n'a pas vues pendant son entraînement.
- L'apport de nos expériences. Quand on lance plusieurs fois le même programme, chaque entraînement complet est un essai. Deux groupes de ces essais tirés au hasard trompent rarement un test statistique. Deux groupes triés, les meilleurs d'un côté et les pires de l'autre, le trompent près d'une fois sur trois. Garder les trois meilleurs essais sur dix gonfle la moyenne d'un tiers. Le t de 9 de 2018, le résultat du test statistique qui faisait passer deux groupes du même programme pour deux algorithmes, vient très probablement d'un test qui compte les parties que le programme joue pendant son entraînement (les épisodes) au lieu des entraînements indépendants (les graines aléatoires).
Deux courbes, un seul programme
Au printemps 2018, à Vancouver, Joelle Pineau monte sur la scène d'ICLR, l'un des trois grands congrès de l'apprentissage automatique1. Elle est professeure à l'université McGill et dirige le laboratoire de recherche en intelligence artificielle de Facebook à Montréal. En décembre, à Montréal, elle reprend et augmente son propos devant NeurIPS, le plus grand des trois2.
La conférence de Vancouver, en entier, en anglais.
Elle projette deux courbes d'apprentissage. Un guépard articulé, dessiné en deux dimensions dans un simulateur de physique, apprend à courir. Chaque courbe suit le score du guépard au fil de l'entraînement, en moyenne sur cinq essais. Les deux courbes se séparent nettement. Un test statistique, le calcul qui juge si un écart peut venir du hasard, les déclare différentes : t = −9,09, p = 0,0016. Ces deux chiffres, expliqués à la section suivante, disent que le hasard expliquerait très mal un tel écart. Un relecteur d'article scientifique y verrait deux algorithmes, l'un meilleur que l'autre.
Or les deux courbes sortent d'un seul programme, l'algorithme d'apprentissage TRPO, avec les mêmes réglages. Seule change la graine aléatoire, ce nombre de départ dont l'ordinateur tire tout le hasard d'un entraînement. Pineau précise sur scène que les deux groupes de cinq essais ne sont pas triés : ce sont « juste cinq essais » de chaque côté. Le hasard seul a fabriqué une « amélioration » publiable.
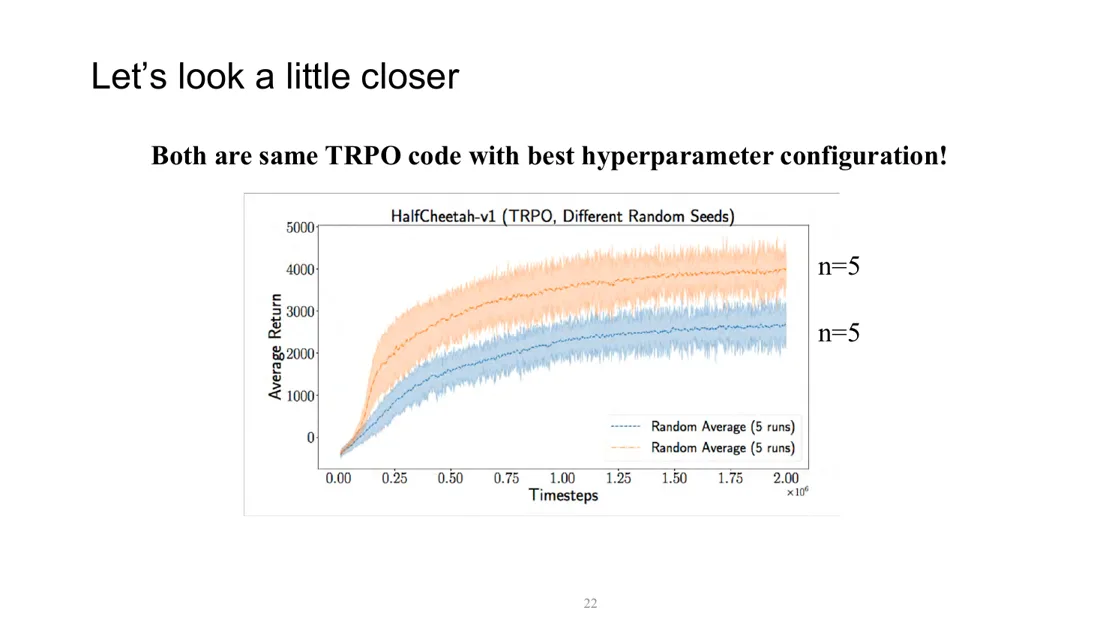
Deux groupes de cinq entraînements du même programme TRPO sur HalfCheetah, qui ne diffèrent que par leur graine aléatoire.
Joelle Pineau, NeurIPS 2018, page 22 de ses diapositives, d'après Henderson et ses coauteurs (2018).
La figure des deux courbes vient d'un article de son équipe, signé Peter Henderson et ses coauteurs3. Elle sert un propos plus large. Pineau part d'un sondage de la revue Nature : sur 1 576 chercheurs de toutes disciplines, plus de 70 % disaient avoir déjà échoué à reproduire l'expérience d'un collègue4. Elle cite ensuite deux chercheurs de Stanford, Buckheit et Donoho, qui écrivaient en 1995 qu'un article scientifique sur le calcul est seulement la publicité de la recherche. La recherche elle-même, ce sont le logiciel complet et les instructions qui ont produit les figures5. Puis elle montre, figure après figure, ce qui manque à son domaine pour mériter la confiance.
Le guépard, la graine aléatoire et le test
Un programme, l'agent, agit dans un monde simulé. À chaque pas, il observe une situation, choisit une action et reçoit une récompense chiffrée. Il cherche la façon d'agir qui rapporte le plus au total. Le guépard de la diapositive s'appelle HalfCheetah : l'agent commande ses six articulations et gagne des points quand le guépard avance. Au début il gigote, après un million de pas il court. Trois autres corps simulés servent dans nos expériences. Hopper saute sur une jambe, Walker2d marche sur deux jambes et Swimmer nage.
L'entraînement tire beaucoup de nombres au hasard, des paramètres de départ du réseau de neurones, ces nombres que l'apprentissage ajuste peu à peu, jusqu'aux actions tentées pour explorer et à la position initiale du guépard.
Même programme, même graine aléatoire : même résultat.
Même programme, autre graine aléatoire : autre résultat.
Un « essai » désigne ici un entraînement complet avec une graine aléatoire donnée.
Les réglages que l'expérimentateur fixe à la main, comme la vitesse d'apprentissage ou la taille du réseau, s'appellent les hyperparamètres. Pour montrer qu'une méthode nouvelle fait mieux, un article la compare à des méthodes existantes, les méthodes de référence. La comparaison est loyale quand toutes ont reçu le même soin de réglage.
Les scores moyens de deux méthodes diffèrent toujours un peu, même quand les deux méthodes sont identiques. Un test statistique dit si l'écart observé dépasse ce que le hasard produit d'habitude. Il calcule pour cela un nombre, le t : l'écart entre les deux moyennes, divisé par la variation que le hasard produit d'habitude. Plus le t est grand, en oubliant son signe, plus l'écart paraît solide. Le test en tire la valeur p, la probabilité d'observer un écart au moins aussi grand si les deux méthodes étaient en vérité équivalentes. Sous 0,05, soit une chance sur vingt, les chercheurs déclarent par convention l'écart « significatif ». Avec deux groupes de cinq essais, un t de trois suffit déjà à franchir ce seuil. Un t de 9 est donc énorme. C'est celui de la diapositive de 2018, au signe près. Un intervalle à 95 % donne la plage où la vraie valeur de l'écart se trouve très probablement. S'il contient zéro, l'écart peut n'être que du hasard.
Seize failles en quatre familles
Pineau montre chaque faille par un exemple. Nous en avons relevé seize dans ses deux conférences, rangées en quatre familles.
- Le matériel. L'article paraît sans son code, sans les réglages exacts ni le calcul nécessaire, sans les versions des logiciels employés, dont le résultat dépend aussi.
- Le réglage. Les hyperparamètres sont donnés en partie, la façon de les choisir est tue. Les méthodes de référence reçoivent moins de soin que la méthode défendue.
- Les graines aléatoires et la statistique. Les articles lancent trois ou cinq essais, jamais dix dans le tableau qu'elle montre. Seuls les meilleurs essais sont publiés. Deux groupes du même code ressemblent à deux algorithmes. Aucun test statistique n'est appliqué.
- La portée des conclusions. Le meilleur algorithme change d'une tâche à l'autre. Deux programmes qui codent le même algorithme donnent des résultats différents. L'agent est évalué dans le monde même où il s'est entraîné, sur des bancs d'essai (les tâches standard sur lesquelles tout le monde se compare) si simples qu'il les apprend par cœur.
Huit ans ont passé. NeurIPS a adopté en 2019 la liste de contrôle que Pineau proposait, des questions que chaque auteur remplit en soumettant son article6. L'avons-nous écoutée ? Deux instruments répondent. L'un relit des articles avec sa grille de lecture, complétée par une seconde grille pour les failles que sa grille ne mesurait pas. L'autre refait ses expériences avec les algorithmes de 2026, sous un protocole écrit avant le premier entraînement : tout changement ultérieur s'y inscrit avec sa date et sa raison.
La plupart de nos expériences lancent dix graines aléatoires, donc dix essais, par programme et par tâche. Nous les avons ensuite refaites avec vingt. Le protocole avait fixé d'avance que les dix premières font foi : les chiffres qui suivent viennent de ces dix graines aléatoires. Nous signalons chaque fois que les vingt nuancent un résultat.
Relire 2018 avant de juger 2026
Pineau avait lu 50 articles de RL de 2018 et noté huit critères pour chacun. Nous avons pris tous les articles des trois grands congrès, ICLR 2026, ICML 2026 et NeurIPS 2025, dont le titre parle d'apprentissage par renforcement, soit 1 252 sur 17 836. Un premier tirage au sort en a retenu 50. Parmi eux, 27 appliquent ce qu'ils appellent RL à de grands modèles de langue, 14 relèvent du RL classique (robotique, jeux, pilotage de machines) et 9 sont théoriques. Les grands modèles de langue sont les modèles d'IA générative qui écrivent du texte, comme ChatGPT. Nous avons tiré d'autres articles de RL classique, jusqu'à 50, parce que quatorze sont trop peu pour détecter un écart de trente points.
Qui a lu ces articles ? Des programmes d'IA générative, de la même famille que ChatGPT. Nous saluons ces nouveaux lecteurs qui lisent même les annexes. Pour chaque article et chaque critère, le lecteur décide oui ou non, avec une citation exacte de l'article et sa page, que chacun peut vérifier dans le dépôt du projet, en ligne. Dix articles ont été relus par un second lecteur qui ignorait la première lecture. Les deux lecteurs tombent d'accord sur 127 décisions sur 130 (98 %). Comme tous ces lecteurs sont des copies du même modèle d'IA générative, cet accord mesure la constance du modèle. Aucun humain n'a refait la lecture de son côté. Un « non » pouvait aussi cacher un oubli du lecteur. Avec des mots-clés fixés d'avance, nous avons cherché ce qui pouvait démentir chaque « non ». Sur 377 décisions « non », 10 passent à « oui », 2 en 2018 et 8 en 2026. Aucun verdict ne change : nos conclusions sur les pratiques restent les mêmes.
Un écart nous sépare de Pineau elle-même. Nous avons relu 50 articles de 2018 avec sa grille de lecture. Notre lecture trouve 55 % d'articles qui donnent tous les réglages de leur méthode, quand Pineau en comptait 90 %. Comparer nos articles de 2026 à ses chiffres mêlerait deux changements, celui des pratiques et celui de la lecture. Chaque verdict compare donc le RL classique de 2026 aux articles de 2018 tels que nous les avons lus, avec les mêmes grilles et les mêmes lecteurs.

Écart, en points de pourcentage, entre 50 articles de RL classique de 2026 et 50 articles de 2018, lus avec les mêmes grilles par les mêmes lecteurs. Le point donne l'écart observé, la barre son intervalle de confiance à 95 %.
Les quatre pratiques en vert ont des intervalles qui évitent zéro.
Quatre pratiques ont changé. Le lien vers le code passe de 31 % à 74 % des articles, l'effet d'un réglage montré de 44 % à 80 %, le calcul chiffré de 27 % à 58 %, une incertitude rapportée (barres d'erreur ou bande autour de la courbe) de 63 % à 88 %. Comparer huit pratiques donne au hasard huit occasions de produire un faux écart. Nous avons donc rendu plus sévère le seuil sous lequel un écart compte, comme le veut l'usage dans ce cas. Nous avons aussi refait l'analyse de plusieurs façons, en changeant chaque fois un choix. Ces variantes sont nos contrôles. Le code et le calcul passent le seuil dans tous nos contrôles, l'effet d'un réglage dans presque tous. La hausse de l'incertitude est fragile : deux de nos contrôles la font échouer, avec p = 0,07 chaque fois, au-dessus du seuil.
Les autres pratiques n'ont pas bougé de façon détectable. Le test statistique passe de 6 % à 12 %, les méthodes de référence décrites avec tous leurs réglages de 35 % à 29 %, l'évaluation dans des conditions tenues à part de 33 % à 45 %, la version des bancs d'essai de 23 % à 26 %. Avec 50 articles de chaque côté, un changement de dix points peut encore passer inaperçu : « pas de changement détectable » ne veut pas dire « aucun changement ». Un contraste, en revanche, est net. Presque tous les articles tracent désormais des barres d'erreur, bien peu appliquent un test statistique.
Une montée lente, commencée avant la liste
Comparer deux années ne dit pas quand le changement a eu lieu entre elles. Nous avons donc lu 20 articles de RL classique par année d'ICML et de NeurIPS, en 2019, 2020, 2022 et 2024, tirés au hasard et lus avec les deux grilles.

Part des articles de RL classique qui suivent chaque pratique, année par année : 48 articles de 2018 (ceux qui comportent des expériences), 20 par année de 2019 à 2024, 50 de 2026. Avec 20 articles, une part a une incertitude d'environ vingt points de part et d'autre.
Les quatre pratiques du haut montent régulièrement. Le test statistique, en gris, ne montre aucune tendance.
Les quatre pratiques montent sans saut net juste après la liste de contrôle de 2019. L'effet d'un réglage fait exception : il monte plus tard, de 40 % sur 2019 et 2020 à 73 % sur 2022 et 2024. Ces séries décrivent une hausse lente, commencée avant la liste ou avec elle. Elles ne disent pas ce qui l'a causée.
La liste de contrôle nous a réservé une surprise. Chaque article de NeurIPS joint la liste remplie par ses auteurs. Sur les 30 articles de NeurIPS 2025 que nous avions lus, nous avons comparé ces réponses au texte de l'article. La question de la liste sur la signification statistique (le test) se contente de barres d'erreur « ou d'une autre information appropriée ». Les 18 articles qui y répondent oui n'appliquent aucun test. Sur le code, 5 articles sur 22 répondent oui sans lien vers leur code. Une case cochée ne garantit pas la pratique qu'elle nomme.
Autre surprise : ce qui a bougé n'est pas toujours le plus facile. Montrer l'effet d'un réglage demande des entraînements supplémentaires. La pratique a progressé malgré ce coût. Donner la version d'un banc d'essai ne demande qu'une ligne de texte, qui manque aussi souvent qu'avant.
Trente graines aléatoires, un seul programme
La relecture des articles a dit ce qui a changé dans les publications. Nos expériences mettent maintenant les failles à l'épreuve, en commençant par la plus célèbre, les deux courbes du même programme. Nous avons refait l'expérience de 2018 à plus grande échelle : trente entraînements de PPO, l'un des algorithmes d'apprentissage par renforcement les plus employés, sur HalfCheetah, un million de pas chacun, avec le même code et les mêmes hyperparamètres. Entre deux entraînements, la graine aléatoire diffère et rien d'autre.

Trente entraînements du même programme sur la même tâche, PPO sur HalfCheetah. Chaque point est un essai, placé à son score final. Seule la graine aléatoire change d'un point à l'autre.
Moyenne 1 688, médiane 1 580.
La moyenne vaut 1 688. L'écart type, qui dit de combien un essai s'écarte en général de la moyenne, vaut 568, soit 34 % de la moyenne. Vingt-sept essais finissent entre 1 138 et 1 999, trois décollent au-delà de 3 000. Aucune ligne du programme ne change d'un essai à l'autre. Les scores ne dessinent pourtant pas de courbe en cloche, cette forme où ils se rangeraient en symétrie autour de la moyenne : les essais qui décollent tirent la moyenne au-dessus de la médiane, le score de l'essai du milieu.
Nous avons ensuite tiré 10 000 fois deux groupes de même taille parmi ces trente essais, puis appliqué à chaque paire de groupes le test de Welch, le test le plus courant pour comparer deux moyennes. Les deux groupes sortent du même programme : chaque écart déclaré significatif est une erreur du test, un faux positif.

Part des 10 000 tirages où le test déclare différents deux groupes d'essais du même programme, au seuil habituel de 5 %.
Tirés au hasard, les groupes trompent le test moins souvent que ce seuil. Triés, ils le trompent près d'une fois sur trois.
Le résultat déjoue ce que la diapositive laissait attendre. Deux groupes de cinq tirés au hasard ne trompent presque jamais le test, dans 1,2 % des tirages. Ils trompent l'œil, en revanche. Leurs moyennes diffèrent de 17 % en médiane et de 47 % une fois sur vingt, de quoi dessiner deux courbes bien séparées. Le test cède quand on trie : opposer les cinq meilleurs essais aux cinq pires donne 31 % de faux positifs. Le hasard trompe l'œil, le tri trompe le test.
L'énigme du t de 9
D'où vient alors le t de 9 de 2018, si des groupes tirés au hasard trompent si rarement le test ? Henderson et ses coauteurs ne testaient pas les scores finaux. Leur légende parle d'un t moyen sur toute la courbe d'apprentissage : le test est refait à chaque point de la courbe, puis on fait la moyenne des t. Nous avons refait ce calcul sur nos trente courbes. Une fois sur vingt, ce t moyen dépasse 1,4 quand les groupes sont tirés au hasard, 2,5 quand on les trie. Aucun de nos 20 000 tirages n'atteint 9.
Première piste : avec leur algorithme, TRPO, les scores varient peut-être davantage d'une graine aléatoire à l'autre qu'avec PPO. Nous avons entraîné trente fois TRPO, avec un plan écrit avant tout entraînement. Ses scores varient bien plus, puisque son écart type vaut 48 % de sa moyenne. Malgré cette variation, le t moyen ne dépasse 1,4 qu'une fois sur vingt au hasard, 1,9 triés. La deuxième piste est une autre façon de calculer le t, qui empile les points des cinq courbes de chaque groupe, cent en tout, comme si chaque point venait d'un essai à part. Son t, une fois sur vingt, monte à 5,0 au hasard et à 6,3 triés. Pire, ce calcul déclare une différence dans 53 % des tirages au hasard, entre deux groupes du même code. Aucun de ces calculs n'atteint 9.
Le chiffre publié contenait l'indice. Un t de 9,09 avec p = 0,0016 suppose environ 3,4 degrés de liberté, un réglage du test qui dépend du nombre de mesures comparées. Or comparer deux groupes de cinq essais donne toujours au moins 4 degrés de liberté. Avec 3,4, ce chiffre ne peut pas venir d'une comparaison de cinq essais à cinq essais. Il trahit un autre calcul. En juin 2017, Peter Henderson avait publié un petit programme, un script, au nom parlant : « de la même distribution »7. Ce script fait la moyenne des courbes des cinq graines aléatoires de chaque groupe. Puis, à chaque point de la courbe, il compare les deux groupes par un test bâti sur la variation des scores entre les épisodes, ces parties successives qu'un même agent joue au cours de l'entraînement. La variation entre graines aléatoires, celle que la figure devait montrer, n'entre jamais dans le test.
L'instant eurêka
Nous avons appliqué ce script à nos trente essais de TRPO, avec un plan écrit avant le calcul. Le t moyen dépasse 9,09 dans 38 % des tirages au hasard. Le test y déclare une différence dans 43 % des cas. Le chiffre de 2018 ressort de nos propres essais.
Rappelons que le t divise l'écart entre deux groupes par la variation que le test mesure. Mesurer la variation entre épisodes revient à comparer la taille moyenne de deux classes en se fiant à la précision du mètre ruban au lieu des différences de taille entre élèves. Le moindre écart entre les deux classes paraît alors immense. Les épisodes d'un même agent jouent le rôle du mètre ruban, les graines aléatoires celui des élèves. Chez notre TRPO, l'écart type entre les épisodes d'un même agent vaut 7 % de l'écart type entre agents, soit entre graines aléatoires : divisé par une variation aussi petite, le même écart donne un t énorme. Avec PPO, dont les épisodes varient davantage, le même calcul n'atteint jamais 9.

Deux groupes de cinq essais tirés au hasard parmi trente, 10 000 fois, pour chaque algorithme et chaque façon de calculer le t. La barre donne la part des tirages où le t moyen, signe oublié, atteint 9,09, le chiffre publié en 2018.
Seul le script de 2017, appliqué à TRPO, y parvient.
Rien ne prouve que ce script a produit la figure de 2018. Son nom et les chiffres qu'il produit le rendent probable. Le t de 9 n'a eu besoin d'aucun tri : un test qui compte les épisodes au lieu des graines aléatoires suffit à le produire. La faille est plus profonde que la figure ne le disait. Le hasard des graines aléatoires a trompé le test même qui devait le mesurer.
Garder les meilleurs, gonfler d'un tiers
Pineau montrait une autre pratique. Des auteurs lancent dix essais et publient la moyenne des meilleurs. Chaque score publié a vraiment été obtenu. Leur moyenne dépasse pourtant ce que la méthode donne d'habitude. Sur nos trente essais de PPO, nous avons tiré dix essais au hasard, un grand nombre de fois. En moyenne sur ces tirages, garder les trois meilleurs sur dix gonfle la moyenne de 33 % : 2 249 au lieu de 1 692.
La même sélection s'applique ensuite à quatre programmes sur quatre tâches, dix graines aléatoires chacun. Ce sont deux versions de PPO, écrites avec deux boîtes à outils de calcul différentes (PyTorch et JAX), puis SAC et CrossQ, un descendant de SAC paru en 2024. Les tâches sont HalfCheetah, Hopper, Walker2d et Swimmer.

Hausse de la moyenne quand on ne publie que les trois meilleurs des dix essais, pour chaque programme et chaque tâche.
Les seize hausses sont positives : le tri sert toujours celui qui le pratique.
La moyenne gonfle de 32 % en médiane, de 6 % à 84 % selon le programme et la tâche. Sur 24 comparaisons entre deux programmes, 3 s'inversent : le perdant devient le vainqueur. Deux d'entre elles opposent les deux versions de PPO. Quand l'écart est faible, garder ses meilleurs essais suffit à changer de vainqueur. Refaite sur dix autres graines aléatoires, la même sélection gonfle la moyenne de 43 % en médiane et renverse encore 3 comparaisons sur 24.
Dans les articles, la pratique se voit rarement : 14 % des articles de RL classique de 2026 la laissent voir, contre 19 % en 2018. Ces parts sont des minimums, car un article qui garde ses meilleurs essais sans le dire échappe à notre lecture.
Combien d'essais les articles lancent-ils ? Sur 41 articles de RL expérimentaux du premier tirage de 2026, 20 ne disent pas combien, 4 n'en ont qu'un et la médiane des autres vaut cinq, la valeur la plus fréquente dans le tableau de Pineau. Le nombre n'a pas bougé en huit ans. Or, entre deux de nos programmes dont les moyennes diffèrent de moins de 20 %, cinq graines aléatoires ne retrouvent le bon ordre que 71 fois sur cent en médiane. Mesuré sur nos vingt graines aléatoires, ce chiffre tombe à 62 fois sur cent. Un tel écart se lit à l'envers plus d'une fois sur trois.
Le programme en tête dépend de la tâche et du budget
En 2018, Henderson et ses coauteurs montraient que l'algorithme en tête sur HalfCheetah cessait de l'être sur Hopper ou Swimmer. Avec nos quatre programmes de 2026, le programme en tête change lui aussi d'une tâche à l'autre. Chaque score est une moyenne interquartile : on écarte le quart le plus bas et le quart le plus haut des dix essais, puis on fait la moyenne du reste, pour qu'un essai hors norme ne tire pas le score à lui seul8.

Score de chaque programme rapporté au meilleur de sa tâche, sur dix graines aléatoires : la barre à 100 désigne le premier.
PPO s'entraîne un million de pas, SAC et CrossQ 200 000.
SAC mène sur HalfCheetah, PPO écrit en JAX sur Hopper et Swimmer, CrossQ sur Walker2d. Le même SAC est loin derrière sur Hopper et sur Walker2d. Le programme en tête ne bat pourtant nettement tous les autres que sur Walker2d : sur les trois autres tâches, dix graines aléatoires ne suffisent pas à le départager du deuxième.
Un détail du protocole pèse lourd : le budget, le nombre de pas d'entraînement. PPO s'entraîne un million de pas, cinq fois plus que SAC et CrossQ. Pour comparer à budget égal, nous avons aussi lu le score de PPO à 200 000 pas, selon une règle écrite avant de regarder ces scores. PPO ne mène alors plus sur aucune tâche. Avec dix graines aléatoires, SAC garde encore la tête de HalfCheetah. Avec vingt, CrossQ arrive en tête des quatre tâches, sans que son avance sur SAC soit établie pour HalfCheetah. Le classement dépend de la tâche, mais aussi du budget que chaque programme reçoit. Un article qui compare deux méthodes à budgets différents compare aussi ces budgets.
Les deux versions de PPO, le même algorithme programmé avec deux boîtes à outils, n'obtiennent pas non plus le même score. Sur Walker2d, PPO écrit en PyTorch obtient 2 158, PPO écrit en JAX 1 272, soit 41 % de moins. Les deux intervalles se chevauchent encore avec dix graines aléatoires : dix ne disent pas laquelle des deux versions fait mieux. Une méthode dont le score tomberait entre les deux gagnerait ou perdrait contre « PPO » selon la version choisie. Avec vingt graines aléatoires, la règle de décision fixée d'avance désigne un vainqueur sur deux tâches. PPO écrit en PyTorch l'emporte sur Walker2d, avec 2 204 contre 1 435. PPO écrit en JAX l'emporte sur Swimmer. Le même algorithme, deux boîtes à outils, deux vainqueurs.
Vingt pour cent plus lourd
Le classement change avec la tâche, avec le budget et avec la version du programme. Pineau demandait aussi de séparer l'entraînement de l'évaluation. Un élève qui a vu le sujet de l'examen la veille peut réussir sans avoir rien compris. En RL, l'agent s'évalue souvent dans le monde de son entraînement. Il est cet élève, qui a pu apprendre ce monde par cœur. Nous avons évalué nos agents deux fois, avec des graines aléatoires jamais vues à l'entraînement : dans la physique de leur entraînement, puis avec des masses alourdies de 20 % et des frottements réduits de 20 %.

Hopper, quatre programmes, dix graines aléatoires chacun. À gauche, le score dans la physique de l'entraînement. À droite, le score avec des masses plus lourdes et des frottements plus faibles.
Les rangs comparent des moyennes interquartiles, sans test.
Douze couples de programme et de tâche sur seize perdent une part détectable de leur score, c'est-à-dire une baisse que le hasard des graines aléatoires n'explique pas. La perte dépend du programme. Sur Hopper, PPO ne garde que 22 % de son score dans sa version PyTorch et 18 % dans sa version JAX, quand SAC en garde 64 % et CrossQ 65 %. Ces parts sont calculées essai par essai, puis résumées par la même moyenne interquartile, ce qui ne donne pas exactement le rapport des deux scores de la figure. PPO écrit en JAX, premier sur Hopper dans la physique d'entraînement, finit dernier dans la physique modifiée. CrossQ y prend la tête.
Pour vérifier ce renversement, nous avons écrit une règle avant tout nouveau calcul : réévaluer chaque agent en ne changeant qu'une grandeur à la fois, les masses de 30 % plus légères à 30 % plus lourdes, les frottements de 40 % plus faibles à 20 % plus forts. Un couple perd quand il fait moins bien que dans la physique d'entraînement, sans que le hasard des graines aléatoires l'explique. En termes précis, l'intervalle à 95 % de son score rapporté à celui de la physique d'entraînement reste sous 1.

Quatre programmes sur quatre tâches, dix graines aléatoires chacun, soit 16 couples de programme et de tâche. Chaque point compte les couples qui perdent une part détectable de leur score quand une seule grandeur de la physique change, masses ou frottements.
Un couple perd quand l'intervalle à 95 % de son score rapporté à celui de la physique d'entraînement reste sous 1. À 0 %, la physique d'entraînement sert de référence : aucune perte n'y est possible.
La perte croît avec la modification de la physique et dessine un V. Des masses allégées de 10 % coûtent une part détectable de leur score à 3 couples sur 16. Alourdies de 20 %, elles en font perdre 12. Les frottements comptent moins, sauf augmentés de 20 % : 9 couples y perdent. Sur Hopper, PPO écrit en JAX n'est plus premier dans 10 physiques modifiées sur 12, avec dix graines aléatoires comme avec vingt. Le renversement tient.
Les articles ont-ils changé sur ce point ? Dans le RL classique, l'évaluation sur des conditions tenues à part passe de 33 % à 45 % des articles, une hausse trop faible pour se distinguer du hasard de l'échantillon. L'évaluation à part est devenue la règle ailleurs, dans les articles qui appliquent ces méthodes aux grands modèles de langue, dont les recueils de problèmes séparent dès le départ l'entraînement et le test.
Une méthode de référence un peu trop belle
Les critères de Pineau s'appliquent d'abord à nous-mêmes. Une de nos expériences voulait illustrer la méthode de référence mal réglée. Elle oppose deux PPO sur Hopper. Le premier garde les valeurs par défaut de sa bibliothèque de programmes, le logiciel tout prêt dont nous tirons PPO. Les valeurs par défaut sont les réglages que cette bibliothèque propose quand on ne règle rien. Le second prend les réglages publiés par le recueil RL Baselines3 Zoo, qui font foi pour cette bibliothèque9. Premier résultat : 2 877 pour les valeurs par défaut, 1 003 pour la version réglée. Les réglages publiés feraient près de trois fois moins bien que les valeurs par défaut ?
Le résultat était trop beau pour être cru sans vérification. Nous avons trouvé une erreur de notre côté. Notre code préparait les données vues par l'agent avec un réglage de 0,99, là où le recueil emploie 0,999. Notre erreur était réelle, mais elle n'expliquait rien. Une fois l'erreur corrigée, les réglages publiés font aussi mal. Dix agents entraînés avec le script officiel du recueil obtiennent 995, contre 2 423 pour les valeurs par défaut, les deux groupes entraînés cette fois sur la version du banc d'essai pour laquelle le recueil a été réglé. Notre explication la plus probable : la recette publiée a vieilli, parce que les logiciels qui l'entourent ont changé depuis sa publication. Un résultat trop beau se vérifie jusqu'à la fin.
Une récompense à pile ou face
Jusqu'ici, toutes nos expériences avaient pour terrain des corps simulés, ceux sur lesquels la robotique met souvent au point ses mouvements avant de les confier à de vrais robots. Le vocabulaire du RL a aussi gagné les modèles d'IA générative qui écrivent du texte, comme ChatGPT : on emprunte au RL certains de ses algorithmes (avec une ressemblance vague) pour affiner leurs réponses, sans agent qui agit dans un monde. On leur pose un problème de mathématiques, un programme vérifie la réponse, les bonnes sont récompensées. En 2025, une équipe de l'université de Washington a montré qu'une récompense tirée au sort, sans regarder si la réponse est juste, améliore les modèles Qwen en mathématiques, mais pas les modèles Llama ou OLMo10. Sur Qwen2.5-Math-7B et le banc d'essai MATH-500, la vraie récompense, celle qui paie les bonnes réponses, fait gagner 29,1 points de pourcentage, une récompense tirée au hasard 21,4. Une pièce de monnaie qui apprend les mathématiques ?
Nous avons voulu voir le phénomène de près, à petite échelle. Nous avons écrit nous-mêmes GRPO, l'un des algorithmes d'entraînement les plus répandus pour cet usage11 et l'avons appliqué à deux petits modèles ouverts, que chacun peut télécharger : Qwen2.5 de 0,5 milliard de paramètres et Llama 3.2 de 1 milliard. Chaque modèle s'entraîne cent pas, chaque pas corrigeant un peu ses paramètres, avec la vraie récompense, puis avec une récompense tirée à pile ou face. Nous avons lancé trois graines aléatoires chaque fois, avant d'en ajouter deux.

Part des problèmes résolus à la première tentative, au départ puis après cent pas d'entraînement, pour chaque modèle, chaque récompense et chacune des cinq graines aléatoires.
Avec la vraie récompense, le même programme donne des résultats très différents d'une graine aléatoire à l'autre. À pile ou face, la réussite tombe à zéro ou presque.
À pile ou face, la réponse est nette : la réussite tombe à 1 % ou moins dans les neuf essais finis. Le dixième, un essai de Llama, s'est arrêté deux fois dès son premier pas, sur un garde-fou qui coupe l'entraînement quand ses calculs s'emballent. Nous le comptons parmi les résultats, au même titre que les neuf autres. Chez nous, à pile ou face, la pièce tombe toujours du mauvais côté.
Avec la vraie récompense, le résultat est venu en deux temps. Sur trois graines aléatoires, Qwen part d'environ 10 % et finit à 36 %, 61 % et 13 % : la faille des graines aléatoires de 2018 en miniature, le même programme donnant trois résultats très différents. Le gain moyen vaut +26 points, avec un intervalle de +2 à +51.
Avec deux graines aléatoires de plus, les nouveaux essais finissent à 13 % et 0 %. Sur cinq graines aléatoires, le gain moyen tombe à +14 points, avec un intervalle de −3 à +34 : il contient zéro. Deux essais ont suffi à défaire le résultat.
Le gain de départ reposait sur les deux premiers essais, faits sur la carte graphique. Les trois essais qui ont tourné sur le processeur, après des plantages de la carte graphique, ont un gain moyen de −2 points. Le matériel et la graine aléatoire s'y mêlent : avec cinq essais, on ne sait pas si l'écart vient de la machine ou du hasard de la graine aléatoire. Sur Llama, le gain moyen vaut +6 points, de juste sous zéro à +15. Ce volet de nos expériences reste une illustration sur de petits modèles, loin d'une réplication de l'équipe de Washington.
Le piège de la coupure
Nos entraînements de GRPO ont fait apparaître un piège de banc d'essai. Les réponses du modèle sont coupées à 160 jetons, ces morceaux de mots qu'il produit un par un. Avec le modèle de départ, avant tout entraînement, 23 réponses sur 32 atteignent cette limite avant de donner un résultat. Aucune de ces réponses coupées n'est juste.

Les réponses du modèle Qwen2.5 de 0,5 milliard de paramètres avant tout entraînement, huit par problème.
La plupart atteignent la limite de 160 jetons avant de donner un résultat et comptent pour fausses.
Avec la vraie récompense, le modèle apprend à finir avant la coupure : sur les dix essais, la part de réponses coupées finit entre 0 % et 29 %. À pile ou face, elle finit au-dessus de la moitié dans six essais sur neuf, entre 2 % et 16 % dans les trois autres. Or une réponse coupée compte pour fausse. Un modèle qui apprend à répondre plus court gagne des points sans mieux calculer. Une part du « gain » mesuré peut donc venir d'un détail du banc d'essai, apprendre à se taire à temps. Nous mesurons désormais la part de réponses coupées à chaque évaluation.
Écoutée en partie
Joelle Pineau a été écoutée sur ce qui se publie à côté du résultat : le code, le calcul, l'effet d'un réglage. Elle l'a été beaucoup moins sur la façon de juger le résultat lui-même. Le test reste rare, les réglages des méthodes de référence restent peu décrits, l'évaluation se fait encore souvent dans le monde de l'entraînement.
Nos expériences précisent la faille la plus célèbre. Les graines aléatoires fabriquent des écarts visibles. Deux choix de l'expérimentateur les aggravent : trier les essais change ces écarts en faux positifs, garder les meilleurs gonfle la moyenne. Le t de 9 a, selon toute vraisemblance, une autre origine, un test qui compte les épisodes au lieu des graines aléatoires. Nous en tirons trois consignes :
- ne jamais trier les graines aléatoires avant de comparer ;
- montrer un intervalle à côté de chaque courbe ;
- appliquer le test aux écarts entre graines aléatoires, jamais aux écarts entre épisodes.
Deux pièges nous ont guettés à notre tour : un résultat trop beau, où nous avons trouvé une erreur de notre code qui n'expliquait rien, puis un premier indicateur sur les modèles de langue qui mesurait aussi une limite de longueur. Le protocole écrit d'avance nous a mis sur la piste de l'erreur de code, la vérification des résultats surprenants nous a menés à la limite de longueur. Et le protocole garde la trace de chaque correction, datée. Chacun peut voir ce que nous avons changé et pourquoi. En 2018, Pineau conseillait d'être aussi critique envers ses bons résultats qu'envers ses mauvais.
Sept questions pour lire une annonce de RL
La liste de contrôle s'adresse aux auteurs. Une personne qui lit un article, un communiqué ou une démonstration en tire sept questions, qui ne demandent pas de savoir programmer.
- Combien de graines aléatoires ? Avec moins de cinq essais, ou avec « les meilleurs essais », le résultat dit peu de chose.
- Quelle incertitude ? Une moyenne sans intervalle ni bande autour de la courbe ne permet pas de juger un écart.
- Quelle méthode de référence, réglée comment ? Si la méthode a reçu un mois de réglages et la méthode de référence ses valeurs par défaut, l'écart mesure le mois de réglages.
- Quel budget ? Comparer deux méthodes entraînées sur des nombres de pas différents, c'est aussi comparer ces nombres de pas.
- Évalué où ? Un agent jugé sur les situations de son entraînement a pu les apprendre par cœur.
- Quel code ? Sans code publié, on ignore ce que l'article a vraiment fait.
- Quel calcul ? Un résultat que personne d'autre n'a les moyens de recalculer ne se reproduit pas.
Le document complet et le code
Cet article résume un document bien plus long, qui reprend les seize failles une à une, avec tous les chiffres, leurs intervalles et leurs limites : le document complet (PDF). Le code, les protocoles écrits d'avance, les journaux d'entraînement, les lectures d'articles avec leurs citations et les scripts qui régénèrent chaque figure se trouvent dans le dépôt du projet12.
Nos verdicts valent pour le RL classique, lu par des programmes d'IA générative sur cinquante articles de chaque côté. Un changement de dix points peut encore y passer inaperçu. Joelle Pineau demandait que la critique s'applique d'abord à soi : notre travail est en ligne, chiffre par chiffre, pour qui voudra le refaire.
Parlons IA.
Les figures de cet article ont été faites avec sprezzature.ai par Deraison.ai
 sprezzature.ai
 Deraison.ai
Bibliographie
Chaque titre ci-dessous a servi à une section précise. Sa notice dit laquelle.
- Pineau, J. (2018). Reproducibility, Reusability, and Robustness in Deep Reinforcement Learning. Conférence invitée, ICLR 2018, Vancouver. iclr.cc La conférence de Vancouver, où Pineau présente les failles du RL profond.
- Pineau, J. (2018). Reproducible, Reusable, and Robust Reinforcement Learning. Conférence Posner, NeurIPS 2018, Montréal. Diapositives La reprise de Montréal : la diapositive des deux groupes de cinq essais, la grille des cinquante articles de 2018 et la liste de contrôle.
- Henderson, P., Islam, R., Bachman, P., Pineau, J., Precup, D. et Meger, D. (2018). Deep Reinforcement Learning that Matters. AAAI 2018. arxiv.org La source écrite des figures : les deux groupes de cinq graines aléatoires, le classement par tâche, les implémentations qui divergent.
- Baker, M. (2016). 1,500 scientists lift the lid on reproducibility. Nature, 533, p. 452-454. nature.com Le sondage de 1 576 chercheurs sur la reproductibilité qui ouvre la conférence.
- Buckheit, J. B. et Donoho, D. L. (1995). WaveLab and Reproducible Research. Dans Wavelets and Statistics, Springer, p. 55-81. doi.org La phrase sur l'article, simple publicité de la recherche.
- Pineau, J., Vincent-Lamarre, P., Sinha, K. et al. (2021). Improving Reproducibility in Machine Learning Research (A Report from the NeurIPS 2019 Reproducibility Program). Journal of Machine Learning Research, 22(164), p. 1-20. jmlr.org L'adoption de la liste de contrôle par NeurIPS en 2019.
- Henderson, P. (2017). from_same_dist.py, dépôt ReproducibilityInContinuousPolicyGradientMethods. GitHub. github.com Le script qui teste la dispersion entre épisodes et retrouve le t de 9.
- Agarwal, R., Schwarzer, M., Castro, P. S., Courville, A. et Bellemare, M. G. (2021). Deep Reinforcement Learning at the Edge of the Statistical Precipice. NeurIPS 2021. arxiv.org La moyenne interquartile et les intervalles par rééchantillonnage employés dans nos expériences.
- Raffin, A. (2020). RL Baselines3 Zoo. github.com Le recueil de réglages publiés dont la recette a vieilli avec les bibliothèques.
- Shao, R., Li, S. S., Xin, R. et al. (2025). Spurious Rewards: Rethinking Training Signals in RLVR. arxiv.org La récompense tirée au sort qui améliore Qwen, mais pas Llama ni OLMo.
- Shao, Z., Wang, P., Zhu, Q. et al. (2024). DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models. arxiv.org L'algorithme GRPO, que nous avons écrit nous-mêmes pour le volet des modèles de langue.
- Harchaoui, W. (2026). Apprentissage par renforcement : A-t-on écouté Joelle Pineau en 2018 ? Document complet, protocoles, données et code. Dépôt du projet Le document dont cet article est tiré, avec chaque chiffre et ses sources.