« Tant que le compteur est plus petit que dix, recommence. » C'est une des plus anciennes phrases de l'informatique et elle marche pour une raison que plus personne ne remarque : la machine sait répondre à la question qu'on lui pose. Comparer un compteur à dix lui coûte un cycle d'horloge, alors qu'un processeur en enchaîne des milliards chaque seconde. Un milliardième de seconde, à peu de chose près, pour une réponse sans erreur possible. Toute la force de la boucle vient de là : elle demande à chaque tour la permission de continuer et cette permission ne coûte presque rien.
Essayez maintenant avec les questions qui décident de la qualité d'un travail. Ce graphique se lit-il ? Ce paragraphe suit-il vraiment celui d'avant ? Ce modèle de prévision mérite-t-il qu'on s'en serve pour de vrai ? Un cycle d'horloge ne répond à aucune. Alors nous les avons sorties des boucles et reléguées à la toute fin, dans une relecture unique, faite à la main, par quelqu'un qui a déjà beaucoup travaillé.
La boucle Ralph les y remet. Elle garde l'ossature du « tant que » et installe un jugement à la place du test. Ce jugement vient d'un œil humain, d'un modèle de vision qui décrit l'image ou d'un jeu de données mis de côté. Une seule pièce change et tout ce qu'on sait automatiser change avec elle. Un piège vient avec : interrogez toujours le même juge et la boucle finit par apprendre les manies du juge au lieu du sujet. Les statisticiens parlent de surapprentissage. Nous allons le mesurer et le regarder se produire sur de vraies données. Nous en tirerons deux règles de conduite : un juge qui n'est pas celui qui agit et un nombre d'essais compté d'avance.
La technique Ralph, sur une seule ligne
Le nom vient de Geoffrey Huntley, un ingénieur australien qui a décrit en juillet 2025 ce qu'il appelle la technique Ralph1. Son Ralph est Ralph Wiggum, l'écolier des Simpson qui répond à côté avec une constance admirable. Et toute la technique se tape sur une seule ligne, dans le terminal où l'on donne à l'ordinateur des ordres écrits :
while :; do cat PROMPT.md | claude-code ; done
Lisons-la mot à mot : tant que vrai, passe le contenu du fichier PROMPT.md à l'agent, puis recommence. Vous écrivez dans un fichier ce que vous voulez obtenir. Un agent de codage le reçoit encore et encore, sans que personne l'arrête. Cet agent est un modèle de langage, comme celui de ChatGPT, à qui l'on a donné le droit de lire et d'écrire des fichiers et de lancer des commandes. On attendrait une pile de fichiers incohérents. Il en sort du logiciel utilisable.
Comment est-ce possible ? Un modèle de langage garde sous les yeux, pendant un échange, une quantité limitée de texte : sa fenêtre de contexte. Elle est courte et plus on la remplit, moins elle est fiable, si bien qu'à la fin d'une longue conversation le modèle perd le fil de ce qu'il avait lui-même décidé. Les fichiers du projet n'ont pas cette faiblesse. À chaque tour de la boucle de Huntley, l'agent repart de zéro, relit l'état réel des fichiers, fait une chose et l'écrit. Le travail s'empile sur le disque et la mémoire du modèle n'en garde rien. C'est l'oubli qui fait marcher la technique.
Huntley se garde de la présenter comme une solution. Il la dit « mauvaise de façon déterministe dans un monde indéterministe ». Il réclame un projet neuf et un ingénieur expérimenté à la barre, puis il prévient que le résultat sort « sous-cuit, cuit ou cuit avec des comportements latents non spécifiés ». Il rapporte aussi un contrat facturé 50 000 dollars livré pour 297 dollars de calcul. Ce chiffre est le sien et rien dans cet article ne le vérifie.
Arrêtons-nous sur un détail de cette ligne, car tout cet article en sort. while : se lit « tant que vrai » : il n'y a rien dans la condition. La boucle d'origine ne teste rien et tourne jusqu'à ce qu'un humain l'arrête. Mettez quelque chose dans cette condition vide et les choses intéressantes commencent. En janvier 2026, Huntley lui-même a soutenu que l'idée vaut pour toute tâche2, sans dire comment. Essayons de le dire.
Quatre temps : agir, rendre, juger, décider
Toutes les variantes qu'on rencontre se ramènent à quatre temps.
- Agir : changer une seule chose, pour savoir ensuite à quoi attribuer le résultat.
- Rendre : faire de ce changement un objet qu'on pose devant soi, une image, un texte imprimé, un tableau de mesures.
- Juger : examiner cet objet.
- Décider : le garder ou le jeter, et noter pourquoi.
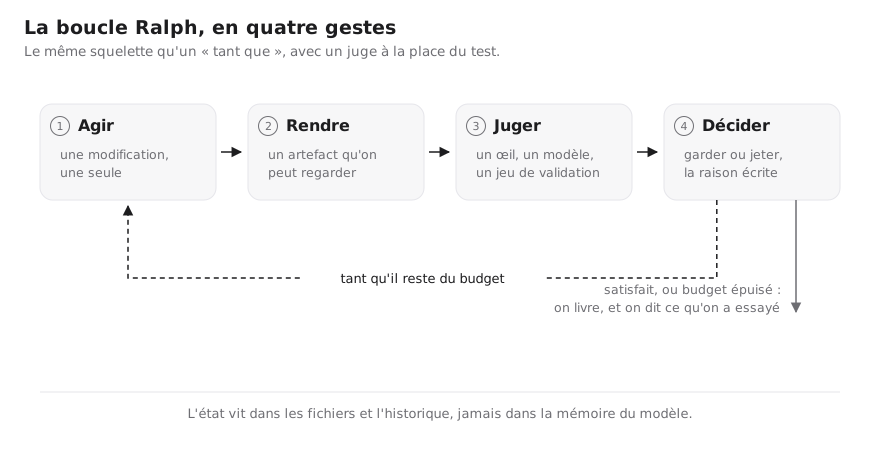
Le squelette commun. D'une boucle à l'autre, seuls changent l'objet rendu et l'identité du juge.
Le deuxième temps est celui qu'on saute, parce qu'il a l'air de ne servir à rien. Sautez-le et vous jugerez une intention à la place d'un résultat : la boucle tournera sans rien apprendre. Le quatrième, on paie plus tard de l'avoir négligé. Sans raison écrite, le compte se perd et trois semaines après, plus personne ne sait combien d'idées ont précédé celle qui a survécu. De la paperasse, ce compte ? La validité de tout le reste dépend de ce nombre.
L'idée a déjà servi sous d'autres noms. Depuis trente ans, le génie logiciel l'appelle le problème de l'oracle : quand aucun cahier des charges ne le dit à votre place, comment savoir si un programme se comporte bien ou mal ? En 2015, une revue du sujet désigne l'humain comme dernière source de vérité3. L'apprentissage automatique y est arrivé par l'échec : seul face à ses erreurs, un modèle de langage se corrige mal et il lui arrive de se dégrader en essayant4. Une revue de juillet 2026 couvre mille deux cent cinquante articles et en tire ceci : toute boucle d'amélioration parie qu'un signal peut remplacer le jugement humain5. La boucle vaut donc ce que vaut son signal. Cessons de regarder l'agent et tournons-nous vers le juge qu'on lui donne.
Premier terrain : les figures
Nous sommes en 2026 et n'importe quel modèle devrait, croirait-on, sortir sans aide une figure professionnelle. Or les figures comptent encore parmi les objets les plus durs à déléguer : une image sortie d'une machine se reconnaît au premier coup d'œil. C'est pourquoi la boucle fait ses débuts ici, dans cet écart entre la promesse et le résultat.
Une phrase, on la relit et on sait. Un graphique, non : son code peut être juste de la première à la dernière ligne et le dessin faux. L'étiquette sort du cadre. La légende atterrit sur les données. Deux points tombent l'un sur l'autre. Une palette rouge et verte tourne à la boue pour qui ne distingue pas ces deux couleurs. Relisez le code cent fois, aucun de ces défauts n'y apparaîtra : il faut regarder l'image.
La Ralph Eyeball Loop6, chez sprezzature.ai, a transformé ce constat en méthode : rendre, regarder, corriger la source, recommencer, tant qu'il reste quelque chose à repérer. Son moteur de rendu ne fait jamais appel au hasard : à source égale, image égale. Puis, figure après figure, l'outil remplit un journal de critiques sous huit rubriques imposées : composition, contraste, hiérarchie du regard, espacements, accessibilité, couleurs, lisibilité des étiquettes à la taille réelle, verdict d'ensemble. Chaque passage ajoute au journal sans rien effacer, ce qui conserve l'histoire de tout ce qui a été vu et corrigé. Plus de 150 sortes de graphiques sont ainsi passées par cette boucle dans la galerie de sprezzature.
Qui regarde ? L'agent qui vient d'écrire le code, par défaut, juge sa propre sortie. Sur option, un modèle de vision installé en local fait le premier examen et un humain le relit. Entre les deux, il y a une différence qui compte : un juge machine peut se soumettre à une mesure. Un banc d'essai publié en septembre 2026 a fait juger des graphiques à des modèles qui lisent les images aussi bien que le texte. Ils montrent des défauts systématiques et d'abord une forte tendance à tout accepter7. Les plus indulgents de tous sont les modèles qu'on a récompensés, pendant leur apprentissage, quand leur réponse plaisait. Ce juge s'est déformé sous la pression même qu'il devait arbitrer. Un œil humain reste donc dans la boucle.
L'exemple le plus proche est sous vos yeux. Ce blog descend d'un export d'outil de mise en page. Sa feuille de style déclarait un espacement entre paragraphes. Une autre règle l'annulait. Sur les huit articles alors publiés, les blocs de texte se touchaient donc. Le code était valide, les tests passaient, les audits automatiques ne trouvaient rien à redire. Une photo de la page rendue, regardée par quelqu'un, a fait ce que rien d'autre n'avait fait. Ce même passage a débusqué deux défauts de la même famille : des numéros de bibliographie assis sur la première lettre de leur note et des lignes blanches parasites entre les éléments de liste. Trois défauts qu'une seconde de regard montre et qu'aucune lecture du code ne montre.
La boucle donne sa pleine mesure quand le juge voit ce que celui qui agit ne peut pas voir. Prenez une personne qui distingue normalement les couleurs. Elle peut soigner sa figure autant qu'elle veut, jamais elle ne la verra comme un lecteur daltonien, parce que cette information manque à son œil. On demande donc à un simulateur de redessiner l'image telle que ces lecteurs la perçoivent, puis en noir et blanc. C'est le test le plus sévère : une figure lisible en gris reste lisible sous toutes les autres déficiences de la vision des couleurs. Une seconde de calcul suffit : la condition d'arrêt coûte presque aussi peu que comparer un compteur à dix.
Deuxième terrain : la prose
Changez le juge dans la condition d'arrêt et le même squelette s'applique aux textes. La charte d'écriture dont relève cet article en fait une règle8 : on relit un texte par paires de paragraphes qui se suivent, au lieu de le relire paragraphe par paragraphe. La raison est simple : ce qui accroche un lecteur se trouve à la couture entre deux paragraphes. On lit donc à voix haute le paragraphe n puis le paragraphe n+1, d'un trait, en regardant le passage de l'un à l'autre. Puis on corrige le texte lui-même (l'ordre des phrases, la dernière ligne du premier, la première du second) sans se contenter de noter en marge que « ça coince ». Puis la fenêtre avance d'un paragraphe.
Les fenêtres se chevauchent : chaque paragraphe passe donc l'épreuve deux fois, à l'arrivée puis au départ. La voix tient ici la place du rendu. Nous croyons connaître notre texte puisque nous l'avons écrit. Lu à voix haute, il devient un signal qu'on reçoit au lieu de l'émettre. Cet article a subi ce traitement.
Le danger de se relire soi-même a été mesuré, lui aussi. En 2024, Jane Pan, He He, Samuel Bowman et Shi Feng font écrire et noter le même modèle en boucle : la note monte pendant que la qualité, jugée par de vrais lecteurs, stagne ou baisse. Et plus le rédacteur et le correcteur partagent leur contexte, plus le phénomène s'aggrave9. On ne trouve pas d'argument plus net pour confier la relecture à quelqu'un qui n'a pas écrit le texte.
La voix a pourtant un angle mort. Elle éprouve la couture entre deux paragraphes et ne dit rien de l'intérieur de chacun. Une phrase ambiguë sortie de votre main coule sans accroc, puisque vous savez déjà ce qu'elle veut dire : la mémoire bouche le trou avant que l'oreille l'entende. Il faut donc un second instrument, sur la même unité de texte, qui regarde ailleurs.
Ce second instrument s'appelle ABABA, un nom qui dit ce qu'on fait. Un passage écrit en français part en anglais, revient en français, repart. A désigne une langue, B l'autre. Comptez les lettres : cinq états, quatre traductions, deux allers-retours complets.
Notons \(T_{AB}\) la traduction vers l'anglais et \(T_{BA}\) le chemin du retour. Un tour complet est leur composition \(R = T_{BA} \circ T_{AB}\) : d'abord l'aller, ensuite le retour. Les versions se succèdent alors ainsi :
Un passage bien écrit rentre intact du voyage, parce que ses mots disent son sens sans compter sur la bienveillance du lecteur. Les mathématiciens l'appellent un point fixe de \(R\) : le tour ne le change plus. On parle en apprentissage automatique de cohérence de cycle. Cette idée a mis cent ans à revenir au texte, après un détour par les photos de chevaux.
Tout commence par une vengeance d'écrivain. En 1903, Mark Twain publie sa nouvelle de la grenouille sauteuse en trois versions : la sienne, la traduction française qu'en avait donnée Thérèse Bentzon, puis sa propre retraduction de ce français vers l'anglais, mot à mot, en gardant la syntaxe française10. Le résultat est grotesque et c'est le but : Twain montre ce que le voyage a fait à son texte. Le procédé devient sérieux en 1970, quand Richard Brislin en fait le contrôle qualité standard de la recherche interculturelle11. Un questionnaire traduit puis retraduit montre, par l'écart, la question mal posée, avant qu'elle ne fausse une étude clinique.
Arrivent les chevaux. En 2017, Jun-Yan Zhu, Taesung Park, Phillip Isola et Alexei Efros cherchent à changer des photos de chevaux en zèbres12. Comment l'apprendre à une machine, quand il n'existe aucune paire de photos correspondantes, donc aucun corrigé ? Leur méthode, CycleGAN, exige qu'un aller-retour redonne l'image de départ. D'où leur est venue cette idée ? Efros le raconte et la réponse boucle le cercle13 : de Mark Twain et de la retraduction ! Le procédé, tout le monde le comprend. Pour faire passer un texte dans une langue que vous ignorez, vous payez un traducteur pour l'aller, un autre pour le retour, puis vous regardez si cela tient encore debout. Partie du texte, la technique était allée vers l'image. Nous la ramenons à la maison.
Dans la même conférence, Efros explique par une image ce que l'aller-retour apprend. Imaginez un montage qui comprime une donnée puis la reconstruit. Le goulot du milieu est ici une langue étrangère : le texte doit s'y glisser, puis ressortir. En chemin il perd beaucoup, les tournures qui nous sont propres sans rien vouloir dire, l'ordre des mots qu'on avait cru élégant. Surtout, une ambiguïté ne passe pas, parce que le traducteur doit choisir une lecture et s'y tenir.
Quand une phrase rentre déformée, le texte laissait donc trop de liberté à qui le lit. S'agit-il d'une ambiguïté, d'une idée pas assez précisée, d'une tournure que l'autre langue ne rend pas, d'un usage propre à l'une des deux langues, d'un simple goût du traducteur ? La boucle désigne l'endroit sans trancher et c'est à nous d'aller voir.
Elle voit pourtant ce que nous ne voyons plus. Nous savions déjà ce que nous voulions dire. Le traducteur l'ignore : c'est le premier lecteur naïf à notre disposition. Un sigle jamais expliqué, un terme défini nulle part, un pronom dont on a oublié à quoi il renvoie trois phrases plus haut : aucun des trois ne survit au voyage.
Un texte stable ne prouve encore rien, comme Efros le dit lui-même dans la même conférence. Si l'on demande seulement de revenir au point de départ, le réseau de neurones qui apprend à transformer les images peut tricher en ne bougeant pas du tout : ne rien changer boucle parfaitement. Une seconde exigence est donc venue s'ajouter, le cheval transformé doit vraiment ressembler à un zèbre. La même année, on a mesuré cette triche. Casey Chu, Andrey Zhmoginov et Mark Sandler montrent que CycleGAN apprend à dissimuler l'image de départ dans un bruit invisible glissé dans sa propre sortie14. Le cycle se referme à la perfection et rien n'a été traduit. Ses découvreurs parlent de stéganographie.
Le critère a donc deux parties, toutes deux obligatoires.
- La stabilité compare chaque version au tour précédent : le texte bouge-t-il encore ?
- La fidélité la compare à l'original, toujours, jamais au tour d'avant. En pratique, on liste ce qu'affirme le texte de départ, on liste ce qu'affirme le texte arrivé, puis on compare les deux listes.
Pourquoi cette asymétrie ? Parce qu'une dérive de sens avance à petits pas, invisibles un par un et considérables une fois additionnés. Et elle se maquille toute seule : dès le deuxième tour, le texte s'est mis d'accord avec sa propre erreur.
Le piège annoncé en ouverture reparaît ici, très net : la boucle apprend les manies de son juge. Après des allers-retours répétés, le texte est attiré vers un état particulier, quel que soit son point de départ : la prose moyenne du traducteur. Itérer jusqu'à ce que le texte ne bouge plus mène donc là, au vocabulaire aplati, au rythme mort, aux transitions plaquées. La boucle clarifie et aplatit ensemble, sans savoir séparer les deux. On a mesuré ailleurs quelque chose d'approchant. En 2024, Ilia Shumailov et ses coauteurs montrent qu'un modèle réentraîné sur ses propres sorties perd d'abord ce qui était rare dans ses réponses15. La comparaison a une limite : ils réentraînent le modèle, nous nous contentons de l'interroger. Chez nous, le texte s'appauvrit et le modèle reste ce qu'il est.
Une interdiction nous protège : on ne garde jamais la sortie de la boucle. On garde ce qui bouge d'un tour à l'autre. Un passage qui refuse de se stabiliser est un passage mal écrit et c'est celui-là qu'on réécrit à la main. Le signal, c'est l'instabilité, pas le texte final. Si un tour transforme « X » en « Y », l'information utile est que X pouvait se réécrire, donc qu'un lecteur pouvait le comprendre comme Y. Nous n'en demandions pas plus. La suite s'écrit à la main : le style reste le nôtre.
Alterner les traducteurs coûte peu : Twain comme Efros le faisaient déjà en engageant deux personnes différentes. Avec un seul modèle, le texte finit par parler comme ce modèle. Avec deux modèles en alternance, un texte qui se stabilise doit satisfaire les préférences des deux, ce qui l'éloigne des manies de chacun. C'est une intuition et aucune démonstration ne l'établit.
Le choix de la langue de passage demande le même soin. Français et anglais se ressemblent trop. Une tournure recopiée mot à mot d'une langue à l'autre y passe sans résistance et une phrase mal bâtie en français reste mal bâtie en anglais sans que rien ne sonne faux. Pour diagnostiquer, prenez une langue vraiment éloignée, le japonais ou le finnois : elle force un vrai réencodage.
Une objection sérieuse vient de Harold Somers, qui a montré en 2005 que l'aller-retour note très mal un traducteur automatique16. L'erreur de l'aller et celle du retour se compensent, si bien qu'un tour réussi ne dit rien de la qualité de chaque traduction. L'objection est juste et elle vise un autre usage. Lui fait varier le traducteur à texte fixe, puisqu'il veut noter le traducteur. Nous faisons le contraire : à traducteur fixe et supposé bon, c'est le texte qui varie.
Ainsi employée, la méthode tient : deux mesures récentes le confirment. En 2020, Jihyung Moon, Hyunchang Cho et Eunjeong Park montrent que l'aller-retour prédit bien la qualité si l'on compare des sens et non des mots17. En avril 2026, Ronald Skorobogat, Ameya Prabhu et Matthias Bethge mesurent une corrélation de 0,94 (1 serait un accord parfait) entre un score d'aller-retour et les préférences de vrais utilisateurs. Deux bancs d'essai multilingues établis, eux, tombent à zéro ou passent en négatif18. Somers garde pourtant raison sur un point : ces erreurs qui se compensent interdisent de conclure sur un seul tour avec un seul modèle.
Nous avons donc deux instruments sur la même unité de texte : l'oreille teste la couture, la traduction teste l'intérieur. On commence par la voix, gratuite, qui règle la moitié des problèmes. On ne lance l'aller-retour que sur les paires qui résistent et jamais plus de deux tours sur un passage qui cède. Passé cinq tours, c'est le style du traducteur qu'on mesure, plus le texte.
Le piège : un juge qui se laisse acheter
Une boucle optimise ce qu'elle mesure. Mettez un juge dans la condition d'arrêt et la boucle se met à optimiser ce juge. En 1975, Charles Goodhart l'observe sur la politique monétaire britannique : dès qu'une régularité statistique sert de cible, elle s'effondre19. L'anthropologue Marilyn Strathern en a donné en 1997, en étudiant l'évaluation des universités, la formule qui est restée : quand une mesure devient une cible, elle cesse d'être une bonne mesure20. La version moderne a été mesurée sur les modèles de langage. Leo Gao, John Schulman et Jacob Hilton poussent l'optimisation de plus en plus fort contre un juge artificiel. La note grimpe sans fin. La qualité réelle, elle, monte, stagne, puis redescend21. Le juge se déforme à mesure qu'on pousse, sans casser d'un coup : rien n'est plus difficile à remarquer.
La corruption, dans une boucle Ralph, a un prix calculable. Imaginons qu'on améliore petit à petit un modèle de prévision. À chaque tour, l'agent propose une modification et on la mesure sur un jeu de validation : des données mises de côté, qui ne servent jamais à entraîner, seulement à départager. Cette mesure est bruitée : faite sur un nombre limité de données, elle donnerait autre chose sur d'autres données. Notons \(\sigma\) la taille typique de ces fluctuations. Chaque idée a de plus un effet réel, parfois bon, parfois mauvais, de taille typique \(\tau\). Essayons \(K\) idées et gardons celle qui affiche la meilleure mesure.
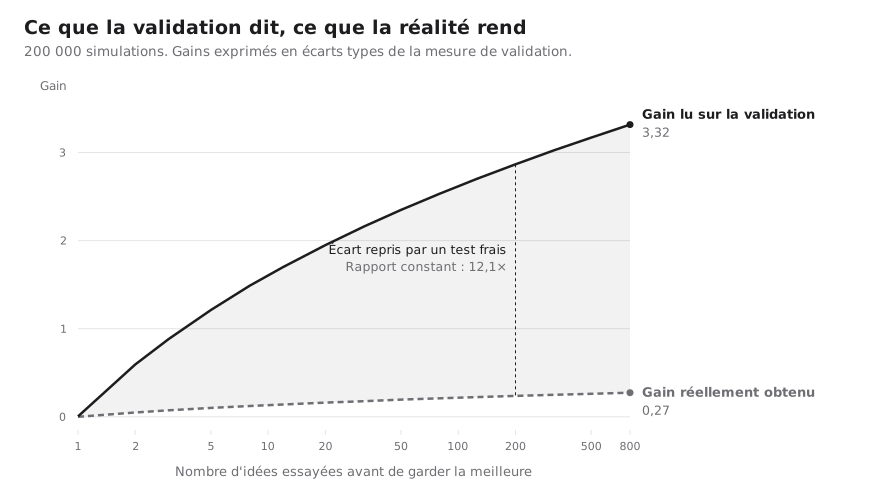
Deux cent mille tirages simulés. Le bruit de mesure y est environ 3,3 fois plus grand que la dispersion des vrais effets. En haut, ce qu'annonce la validation. En bas, ce qui reste quand on mesure ailleurs.
Dans la simulation ci-dessus, le bruit de mesure est environ 3,3 fois plus grand que l'écart entre une bonne et une mauvaise idée. En pratique, cela n'a rien d'extravagant. Essayons huit cents idées : la modification gagnante affiche 3,32 de gain sur la validation. Son gain réel est de 0,27. Douze fois moins ! Cet écart entre les deux courbes, la mise en production vient toujours le reprendre.
Cet écart n'a rien d'accidentel. Pensez à un concours. L'élève qui décroche la meilleure note a en général du niveau et de la chance : choisir la meilleure copie, c'est aussi choisir la chance. Pour estimer son niveau réel, mieux vaut donc viser un peu sous sa note. Ce rabais a une formule. Pour une mesure \(m\), la meilleure estimation de l'effet réel \(\theta\) n'est pas \(m\) : il faut tirer \(m\) vers zéro, d'autant plus fort que la mesure est bruitée :
Lisons-la en mots. À gauche, ce qu'on cherche : l'effet réel, une fois la mesure connue. À droite, la mesure multipliée par un nombre plus petit que 1 : la part des vrais effets dans toute la dispersion, bruit compris. Sans bruit, ce rapport vaut 1 et on croit la mesure. Quand le bruit domine, il tombe vers zéro et la mesure ne vaut presque plus rien.
Ce calcul s'appelle le rétrécissement bayésien : il combine ce qu'on vient de mesurer et ce qu'on savait déjà. Il appartient à la famille des estimateurs rendus célèbres par Charles Stein en 1956, puis par James et Stein en 196122. Bradley Efron l'a relié en 2011 au biais de sélection23 : une valeur choisie parce qu'elle était la plus grande surestime toujours ce qu'elle mesure. Avec les valeurs de la simulation, ce rabais revient à diviser par 12,1 : tout ce que la validation annonce, il faut le diviser par douze. Vérifions sur les deux courbes : 3,32 divisé par 12,1 donne bien 0,27.
Le nombre d'idées essayées laisse ce facteur intact. Il change la taille du gain qu'on croit lire et qui n'existe pas. Ce mirage grandit comme \(\sqrt{2\ln K}\) : le logarithme ne gagne un cran que si le nombre d'idées est multiplié et la racine carrée ralentit encore cette montée. Cette fonction monte très lentement et ne s'arrête jamais. Laissez tourner la boucle : elle annoncera à la longue un gain aussi grand que vous voudrez sur son juge, sans avoir rien amélioré. Le même mécanisme explique pourquoi tant de résultats publiés ne se reproduisent pas, comme John Ioannidis l'a montré en 200524. Les économistes du pétrole l'avaient déjà nommé en 1971 : le vainqueur d'une enchère est celui qui a le plus surestimé le gisement, d'où le nom de malédiction du vainqueur25.
Cette simulation suppose des idées indépendantes et sans talent moyen. C'est pessimiste pour un ingénieur compétent, dont les propositions ne sont pas tirées au sort, et optimiste pour un agent qui produit vingt variantes de la même idée. Elle décrit donc un mécanisme et ne juge aucune boucle en particulier. Deux constats survivent à ces réserves : ce qu'on lit dépasse ce qu'on obtient et l'écart grandit avec le nombre d'essais.
Le piège, sur de vraies données
On objectera qu'une simulation n'est qu'une simulation. Voici donc la même expérience sur de vraies données, plus brutale encore que le modèle. Prenons huit cents images de chiffres manuscrits et coupons-les en deux. Quatre cents servent au juge, par validation croisée, dont le fonctionnement est expliqué plus loin. Les quatre cents restantes forment un test gelé, invisible pour la boucle. À chaque tour, la boucle propose une petite modification des variables d'entrée, l'accepte si le score de validation monte, la rejette sinon. Sur deux cents propositions examinées, dix sont acceptées. Le protocole complet est donné pour qu'on puisse le refaire au lieu de le croire. Il comprend la graine aléatoire, le nombre qui fixe le hasard : en relançant le programme, on retrouve la même expérience. Jeu load_digits de scikit-learn, graine aléatoire 20260922, régression logistique (un modèle simple qui choisit entre des catégories), validation croisée à cinq plis.
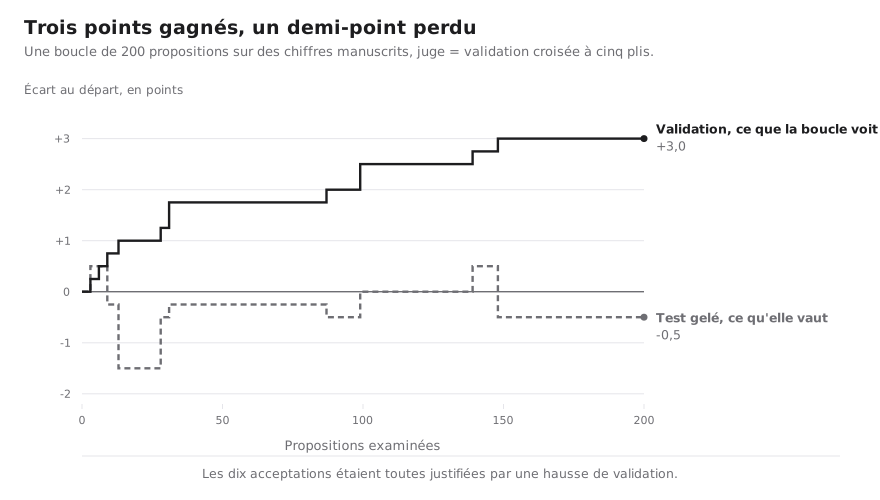
Chaque marche de la courbe haute est une modification acceptée pour avoir fait monter la validation. La courbe basse dit ce que valaient vraiment ces dix décisions.
En dix paliers, chacun justifié par une hausse mesurée, la validation gagne trois points. Le test gelé en perd un demi. Tout ce progrès annoncé, c'était du bruit que la boucle a poursuivi. Le plus inquiétant est qu'elle a échoué de la manière même dont elle aurait réussi : sa courbe de validation monte par paliers, comme celle d'une boucle qui gagne vraiment. Vues de l'intérieur, les deux situations se ressemblent. Pour les distinguer, il faut un jeu gelé, consulté une seule fois.
Une seconde objection pèse plus lourd que la première, car la plus grande vérification empirique va dans l'autre sens. Rebecca Roelofs et ses coauteurs ont étudié plus de cent concours de prévision en ligne, sur la plateforme Kaggle. Ils mettent face à face les classements publics, nés de milliers de soumissions, et les classements privés, révélés une seule fois à la fin. Ils trouvent peu de surapprentissage29. L'explication s'appelle la multiplicité effective : vingt variantes de la même idée ne comptent pas pour vingt essais indépendants. Nos chiffres manuscrits, eux, tirent des essais presque indépendants : nous avons choisi exprès le cas défavorable. La bonne question est donc de savoir combien d'essais vraiment différents une boucle a faits.
Le budget rend un chiffre croyable
Faut-il alors renoncer à chercher en boucle ? Une comparaison dit non. Pour régler un modèle, le réflexe classique est la grille : on écrit d'avance une liste de combinaisons de réglages, on les évalue toutes, on garde la meilleure. En 2012, James Bergstra et Yoshua Bengio montrent qu'à budget égal, des combinaisons tirées au hasard font déjà mieux qu'une grille régulière26. Une boucle Ralph fait un pas de plus : ce qu'elle propose ensuite dépend de ce que la dernière mesure a dit. Les statisticiens appellent cela une analyse adaptative et s'en méfient à juste titre, parce qu'un jeu de validation s'use beaucoup plus vite quand les questions dépendent des réponses déjà obtenues. Pour ce cas, Cynthia Dwork et ses coauteurs ont construit des garanties chiffrées27. Tout annonce donc une boucle moins bonne que la grille. La simulation dit le contraire.
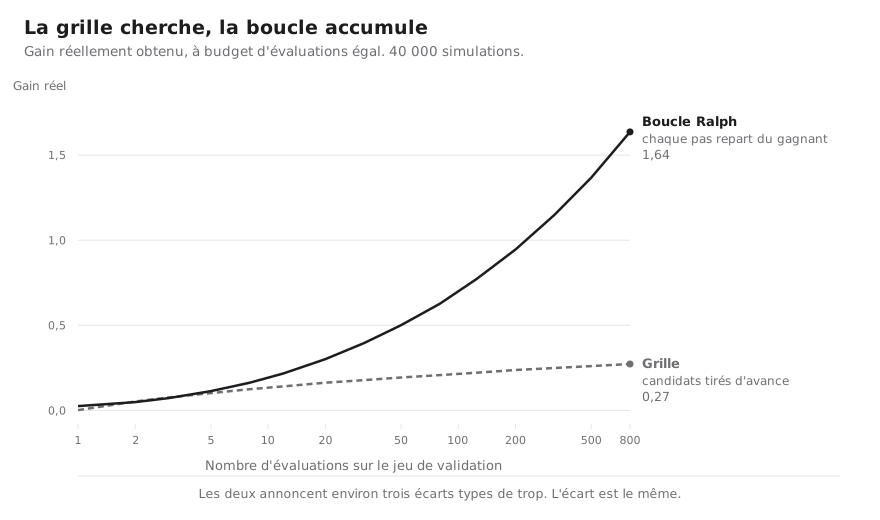
Un même juge, un même budget d'évaluations et deux manières de chercher. La grille tire chaque candidat de zéro. La boucle repart à chaque fois du gagnant précédent.
À budget égal, la grille obtient un gain réel de 0,27 et la boucle de 1,64 : six fois plus. D'où vient l'avantage ? Une troisième expérience répond, à la manière du groupe témoin d'un essai de médicament. La même marche pas à pas, en acceptant tout sans jamais regarder la mesure, n'apporte rien. Le travail vient donc de la sélection, pas de l'accumulation. Confiez au contraire cette marche à un oracle qui verrait les effets réels : elle gagnerait soixante fois plus. Avec son juge bruité, la boucle ne récupère que deux pour cent de ce qui était disponible, soit à peu près un soixantième. Le mirage, lui, est identique des deux côtés : grille et boucle surestiment leur gain d'autant. Le gonflement dépend seulement du nombre de fois qu'on a consulté le juge, quelle que soit la façon de chercher.
La règle de budget qui en découle n'est pas de moi. En 2014, David Bailey, Jonathan Borwein, Marcos López de Prado et Qiji Zhu ont traité ce problème pour les rétrotests financiers28. Un rétrotest rejoue une stratégie d'investissement sur le passé. Sous une certaine quantité de données, établissent-ils, un historique flatteur ne prouve rien. Cinq ans de données n'autorisent pas plus de quarante-cinq configurations différentes. Pour une boucle, fixons d'avance une tolérance \(\delta\) : de combien de fois le bruit \(\sigma\) on accepte que le gain annoncé dépasse le gain réel. La même borne donne alors une règle prudente :
En mots : le nombre d'essais permis reste sous l'exponentielle de la moitié du carré de cette tolérance. Prenez une tolérance de 3 : le carré vaut 9, la moitié 4,5, l'exponentielle environ quatre-vingt-dix. Le calcul exact en autoriserait davantage : environ trois pour une tolérance de 1, vingt-sept pour 2, quatre cent quarante-trois pour 3. La formule n'en concède qu'un, sept et quatre-vingt-dix : elle est donc prudente. Et \(K\) se compte en essais vraiment différents, pas en tours de boucle.
Un seul point survit à toutes les réserves, démontré depuis 2014 dans un tout autre domaine : limiter le nombre de tours va bien au-delà d'une économie de calcul. Sans cette limite, le chiffre final ne veut plus rien dire.
La boucle gagne sa place par autre chose que ce facteur six : une grille suppose qu'on puisse écrire la liste des candidats d'avance. Ajouter une variable calculée, changer ce que le modèle cherche à réduire, retirer une réponse glissée par erreur dans les entrées : ces modifications-là ne s'écrivent pas en liste. On ne les met pas dans une grille, faute de pouvoir en écrire les axes. La boucle cherche là où il n'y a pas de grille à tracer. C'est son avantage irremplaçable. Le reste se paie.
Le juge de tous les jours : la validation croisée
Tout ce qui précède dépend de \(\sigma\), le bruit du juge. Or, dans un vrai projet, ce bruit se règle à votre insu, le jour où vous choisissez comment découper les données. L'outil courant s'appelle la validation croisée. Coupez le jeu de données en \(k\) parts, qu'on appelle des plis. Entraînez sur tous les plis sauf un et mesurez sur celui qui reste. Refaites-le \(k\) fois en changeant de pli mis de côté. Annoncez enfin la moyenne des \(k\) scores, avec une barre d'erreur censée dire ce que vaut cette moyenne.
Cette barre est presque toujours trop optimiste, pour une raison simple : le calcul fait comme si les \(k\) mesures étaient indépendantes, alors que deux plis partagent presque toutes leurs données d'entraînement. Gaël Varoquaux a chiffré le problème : sur les petits échantillons, les barres publiées sont couramment deux fois trop étroites30. Sur nos chiffres manuscrits, la variabilité qui compte, d'un échantillon à l'autre, atteint près du double de celle qu'on cite entre plis. Sous-estimer \(\sigma\) d'un facteur deux revient à croire à quatre fois plus de progrès qu'il n'y en a, puisque le bruit entre au carré dans la formule du rétrécissement. Le découpage fixe donc le taux de change entre ce qu'on lit et ce qu'on obtient.
C'est ce que codifie la suite d'outils publiée par probabl autour de scikit-learn, skrub et skore31. Elle découpe par groupes quand plusieurs lignes viennent du même sujet, par ordre chronologique avec une zone tampon quand le temps compte. Elle met aussi en garde contre les habitudes qui produisent des barres trop confiantes. On y reconnaît une boucle Ralph écrite en entier : un journal de bord où vit l'état, un juge qui est un rapport distinct de l'auteur de la chaîne de traitement, une raison écrite avec chaque proposition. Plusieurs étapes s'arrêtent net au lieu de continuer sur une dépendance manquante.
Dans cette suite, un détail mérite d'être copié partout. Son tout premier contrôle, qui vérifie seulement que tout tourne, repose sur un compte exact : le nombre de prédictions doit égaler le nombre de lignes à prédire. Cette vérification attrape une faute précise et fréquente. Une question qui demandait un jugement devient ainsi un test gratuit. Toute boucle Ralph gagne à en fabriquer autant qu'elle peut, parce que ce que la machine sait trancher n'a rien à faire dans la condition coûteuse.
Un projet en cours applique ces règles à la prévision de séries financières. Deux élèves du mastère spécialisé en intelligence artificielle de CentraleSupélec le mènent, sur une proposition de Marianne Clausel, de l'Université de Lorraine, de Georges Oppenheim et de moi-même. Son protocole d'évaluation s'appelle LookForward, que d'autres nomment walk-forward. À chaque date \(t\), il calcule une statistique \(S_t\) sur les pas qui suivent \(t\), la zone jaune de la figure. Ce calcul lit seulement les dates bleues, celles dont l'information était déjà publiée : un indicateur publié le quinze ne sert donc jamais à une prévision faite le dix. La qualité de \(S_t\) se juge plus tard, le jour où les valeurs jaunes sont connues.
Le bleu prend deux formes, toutes deux du LookForward. La fenêtre croissante part du début de la série et s'allonge avec \(t\) : elle lit toutes les dates \(s\) de \(1\) à \(t\). La fenêtre glissante garde une largeur fixe \(r\) et avance avec \(t\) : elle lit les dates de \(t-r+1\) à \(t\). Puis la date avance d'un cran pour le calcul suivant. Quelles dates \(t_{\min}\) et \(t_{\max}\) bornent \(t\) ? C'est une autre question, encore ouverte.
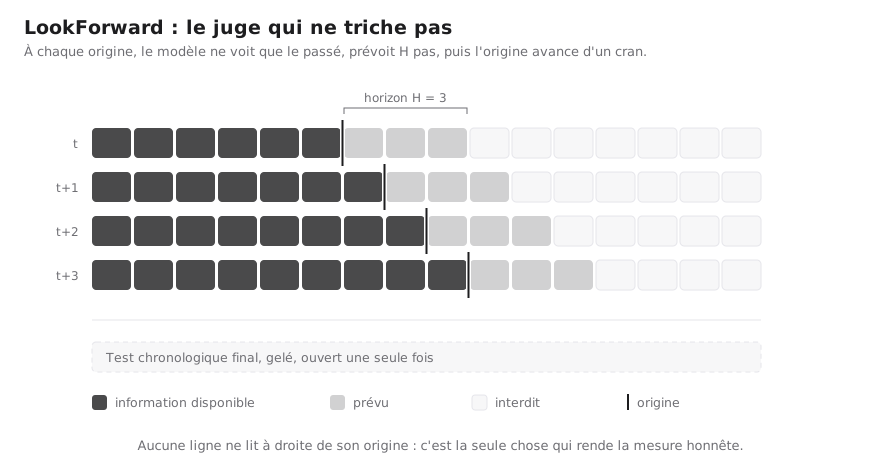
LookForward en fenêtre croissante (en haut) et en fenêtre glissante de largeur r (en bas). Ici, le juge est une discipline de calendrier et non un jeu de données tiré au hasard : aucune ligne ne lit à droite de sa date t.
Dans ce projet, une boucle Ralph sous budget teste chaque modification en LookForward et écrit pourquoi elle l'accepte ou la rejette. À part, gelé, ouvert une seule fois, un test chronologique final donne le chiffre qu'on publiera. Le projet compare des méthodes statistiques classiques, des méthodes d'apprentissage automatique et des modèles de fondation pour les séries temporelles, selon le protocole ouvert TFB32, avec Chronos et TimesFM parmi les candidats33, 34. Il s'autorise aussi l'abstention, appuyée sur le contrôle conforme du risque35, dont la garantie repose sur une hypothèse que les séries financières malmènent.
| Boucle | Ce qu'on rend | Qui juge | Par où le juge se laisse acheter | La garde |
|---|---|---|---|---|
| Code | Le dépôt après un tour | La suite de tests, puis un humain | Les tests deviennent la cible, le code passe sans être juste | Des tests écrits avant, par quelqu'un d'autre |
| Figures | Une image, toujours la même pour une source donnée | Un œil ou un modèle de vision | On s'habitue à sa propre figure et l'on cesse de la voir | Le gris, la simulation de daltonisme, un regard neuf |
| Prose | Le texte lu à voix haute, puis traduit et retraduit | L'oreille pour la couture, un traducteur pour l'intérieur | Le texte converge vers la prose moyenne du traducteur | Garder ce qui change d'un tour à l'autre et non la sortie, alterner les traducteurs |
| Prévision | Des erreurs datées, horizon par horizon | Une validation glissante | La validation s'épuise à mesure qu'on la consulte | Un budget, une raison écrite, un test gelé |
La boucle de Huntley sur le code, puis les trois terrains de cet article : figures, prose, prévision. La quatrième colonne dit quatre fois la même chose, dans la langue de chaque terrain : le juge devient la cible.
L'origine de l'idée et l'apport de cet article
Mettons les choses au point, car le mot commence à tout désigner. Enchaîner production, critique et correction n'a rien de propre à Ralph, qui arrive après. Self-Refine, publié en 2023, fait critiquer le modèle par lui-même36. Reflexion, la même année, garde d'un essai à l'autre une mémoire de commentaires37. La technique de Huntley se distingue par une combinaison.
- Un contexte neuf à chaque tour, au lieu d'une conversation qui s'allonge.
- Un état conservé hors du modèle.
- Le code produit, exécuté pour de vrai.
- Une seule chose faite à chaque tour.
Quant aux boucles sur la prose, les figures et la prévision décrites plus haut, elles sont ma généralisation et non un sens établi du terme. Cherchez « Ralph loop » ailleurs : vous trouverez du code et rien d'autre.
La partie chiffrée vient d'ailleurs, elle aussi. En 2014, la finance quantitative démontre que choisir parmi \(N\) rétrotests impose un historique d'une longueur minimale28. En 2015, l'informatique théorique démontre qu'un jeu mis de côté résiste seulement à un nombre limité de questions adaptatives27. Entre 2022 et 2024, les chercheurs qui veulent faire poursuivre à une intelligence artificielle ce qu'on lui demande vraiment ont mesuré que pousser trop fort contre un juge de substitution détruit la qualité réelle21. Le rétrécissement vers la moyenne, lui, date des années cinquante. Et pendant ce temps, en 2025, l'ingénierie logicielle mettait en production une boucle sans condition d'arrêt. À ma connaissance, ces littératures se citent peu entre elles. Le seul apport de cet article est de dire qu'elles décrivent le même objet : la règle de budget vaut pour les programmes qui font tourner un agent en boucle comme pour les stratégies de marché.
Les garde-fous
Avant de lancer quoi que ce soit, vérifiez ces garde-fous.
- L'état est conservé hors du modèle, dans les fichiers et leur historique, jamais dans une conversation.
- Le juge est indépendant de celui qui agit : l'œil qui évalue n'est pas la main qui a dessiné, le jeu de validation n'est pas le jeu d'entraînement.
- Un budget borne le nombre de tours.
- Chaque tour laisse une raison écrite : sans elle, le compte des essais se perd et le gain final devient invérifiable.
- L'abstention est une sortie permise, au même titre que la réussite : une boucle qui n'a pas le droit de conclure à l'échec trouvera toujours quelque chose.
Retirez un seul de ces garde-fous et le chiffre final n'est plus vérifiable : la boucle redevient un « recommence jusqu'à ce que ça passe ».
Tous obéissent au même principe, qu'Efros dit mieux que moi dans la conférence déjà citée13. Un juge incorruptible n'existe pas. Les données sont en nombre fini, donc il restera toujours un chemin pour tricher. Boucher un trou en fait apparaître un autre. On peut seulement arranger le problème pour que tricher coûte plus cher que travailler. Efros prend l'image d'un pays bien gouverné : on peut y enfreindre la loi, simplement on n'y a pas intérêt. Dans un pays mal gouverné, tricher est le calcul rationnel et tout le monde triche.
Il le montre dans sa propre salle de cours. Un semestre de travail coûte cher. Apprendre par cœur les annales de l'an dernier coûte peu et suffit souvent à passer l'examen. L'étudiant qui fait ce calcul est rationnel, pas malhonnête : c'est l'examen qui est mal construit. Un jeu de validation consulté deux cents fois, ce sont ces annales. Le budget, la raison écrite et le test gelé ne font aucune morale à la boucle. Ils rendent la triche plus chère que le travail.
Où le rapprochement avec le « tant que » cesse-t-il de tenir ? Laissez une boucle classique tourner sans fin, vous le voyez aussitôt : la machine chauffe et rien ne sort. Laissez tourner sans fin une boucle Ralph : à chaque tour sort un travail plausible, une figure un peu différente, un paragraphe un peu remanié, un score un peu meilleur. Elle ressemble à du progrès et non à une panne. C'est ce qui la rend dangereuse.
Alors, avant votre prochaine boucle : rendez ce que vous venez de faire, regardez-le vraiment, corrigez la source et non l'image, comptez vos tours. Trois de ces étapes coûtent quelques secondes. La quatrième, celle qu'on oublie, décide à elle seule de la valeur des trois autres. Le talent de l'agent compte moins que l'évaluation qui l'entoure, à condition qu'il ne puisse pas la surapprendre.
Parlons IA.
Les figures de cet article ont été faites avec sprezzature.ai par Deraison.ai
 sprezzature.ai
 Deraison.ai
Bibliographie
Chaque titre ci-dessous a servi à écrire une section précise : la notice dit laquelle. Aucun n'est cité de seconde main.
- Huntley, G. (2025). Ralph Wiggum as a « software engineer ». ghuntley.com/ralph La page qui nomme la technique et en donne la ligne de shell. L'auteur y pose aussi les réserves reprises ici : projet neuf seulement, ingénieur expérimenté indispensable, résultat dont la cuisson n'est pas garantie. Elle ne comporte aucune condition d'arrêt : c'est l'opérateur qui tranche. Le chiffre de coût cité est le sien.
- Huntley, G. (2026). everything is a ralph loop. ghuntley.com/loop Soutient que le motif vaut pour toutes les tâches et décrit plusieurs variantes d'orchestration. C'est l'antécédent le plus direct de la généralisation défendue ici ; la généralité y est affirmée plutôt que structurée, sans squelette commun ni analyse des modes de défaillance.
- Barr, E. T., Harman, M., McMinn, P., Shahbaz, M. et Yoo, S. (2015). « The Oracle Problem in Software Testing: A Survey », IEEE Transactions on Software Engineering, 41(5), 507-525. 10.1109/TSE.2014.2372785 Recense trente ans de tentatives pour décider automatiquement si un comportement observé est correct et conclut que lorsque spécifications, modèles et tests métamorphiques s'arrêtent, la dernière source d'oracle reste l'humain. C'est la formulation de ce problème par le génie logiciel, antérieure de loin aux agents.
- Huang, J., Chen, X., Mishra, S., Zheng, H. S., Yu, A. W., Song, X. et Zhou, D. (2024). Large Language Models Cannot Self-Correct Reasoning Yet, ICLR. arxiv.org/abs/2310.01798 Sépare l'autocorrection fondée sur les seules forces du modèle de celle qui s'appuie sur un signal extérieur et montre que la première échoue, la performance se dégradant parfois après correction. C'est l'argument empirique pour que le juge vienne d'ailleurs que de l'acteur.
- Chen, M., Wang, L. et Qu, B. (2026). Recursive Self-Improvement in AI: From Bounded Self-Refinement to Autonomous Research Loops. arxiv.org/abs/2607.07663 Revue de mille deux cent cinquante articles qui pose que toute boucle d'amélioration est un pari sur la substitution d'un signal au jugement humain et classe ces signaux du vérificateur formel à l'auto-évaluation. C'est l'énoncé le plus proche du cadrage de cet article et il lui est antérieur de plusieurs mois.
- Harchaoui, W. The Ralph Eyeball Loop, Sprezzature. sprezzature.ai/ralph-eyeball-loop.html Applique la boucle aux artefacts visuels et sépare trois passes complémentaires : fabriquer depuis du code, auditer la source, regarder le rendu. C'est la source des quatre étapes, des huit rubriques de critique et du raisonnement sur le gris comme test le plus sévère.
- Wu, L., Zhao, H. H., Zhang, Z., Tang, J., Wu, J. et Wang, A. J. (2026). ChartJudgeBench: Evaluating LMM Judges for Chart-to-Code Generation. arxiv.org/abs/2609.24210 Évalue les modèles multimodaux employés comme juges de graphiques et documente quatre défauts systématiques, dont une propension marquée à accepter et une indulgence accrue chez les modèles entraînés par renforcement. C'est la mesure du juge visuel dont dépend la boucle des figures.
- Harchaoui, W. ECRITURE.md, charte d'écriture en français. gist.github.com La section 10 transpose la boucle à la prose : relecture par paires de paragraphes consécutifs, fenêtres glissantes qui se chevauchent, correction du texte plutôt que de l'impression. C'est la charte que cet article s'applique à lui-même.
- Pan, J., He, H., Bowman, S. R. et Feng, S. (2024). Spontaneous Reward Hacking in Iterative Self-Refinement. arxiv.org/abs/2407.04549 Montre que dans une boucle où le même modèle rédige et note, la note monte pendant que la qualité perçue par de vrais lecteurs stagne ou baisse, d'autant plus que rédacteur et correcteur partagent leur contexte. Le mode de défaillance décrit ici était donc déjà nommé et mesuré sur la prose.
- Twain, M. (1903). The Jumping Frog: In English, Then in French, Then Clawed Back into a Civilized Language Once More by Patient, Unremunerated Toil, Harper & Brothers. Twain publie côte à côte sa nouvelle, la traduction française qu'en donne Thérèse Bentzon et sa propre retraduction mot à mot vers l'anglais. La démonstration est comique et exacte : l'aller-retour rend visible ce que le texte avait de fragile. C'est l'ancêtre littéraire de la boucle décrite ici.
- Brislin, R. W. (1970). « Back-Translation for Cross-Cultural Research », Journal of Cross-Cultural Psychology, 1(3), 185-216. 10.1177/135910457000100301 Fonde la rétro-traduction comme contrôle qualité en recherche interculturelle ; c'est depuis la procédure standard pour traduire un questionnaire clinique ou psychométrique, où une nuance perdue fausse une étude entière. Établit que l'écart de retour est un signal exploitable et non un bruit.
- Zhu, J.-Y., Park, T., Isola, P. et Efros, A. A. (2017). « Unpaired Image-to-Image Translation using Cycle-Consistent Adversarial Networks », ICCV, 2242-2251. arXiv:1703.10593 CycleGAN : faute de paires d'images correspondantes, la contrainte d'apprentissage devient l'aller-retour lui-même. C'est la formalisation de la cohérence de cycle reprise ici, doublée de la preuve qu'elle suffit à remplacer un corrigé absent.
- Efros, A. A. (2018). Self-supervision, Meta-supervision, Curiosity: Making Computers Study Harder, conférence au CIIRC, Université technique tchèque de Prague, 25 mai 2018. youtube.com/watch?v=_V-WpE8cmpc Efros y attribue explicitement l'idée de CycleGAN à Mark Twain et à la rétro-traduction et décrit le montage comme un auto-encodeur dont le passage étroit est une autre langue (à 48 min). Il y pose aussi la limite reprise ici : sans seconde contrainte, le réseau triche en ne bougeant pas. Et la formule qui sert de fil à la fin de cet article : rendre la triche plus coûteuse que le travail.
- Chu, C., Zhmoginov, A. et Sandler, M. (2017). CycleGAN, a Master of Steganography, atelier « Machine Deception », NIPS. arXiv:1712.02950 Montre que CycleGAN dissimule l'image source dans un bruit de haute fréquence imperceptible, ce qui lui permet de reconstruire à l'identique sans avoir rien traduit. C'est la démonstration que la cohérence de cycle seule est dégénérée. De là vient que la fidélité se mesure ici contre l'original, jamais contre le tour précédent.
- Shumailov, I., Shumaylov, Z., Zhao, Y., Papernot, N., Anderson, R. et Gal, Y. (2024). « AI models collapse when trained on recursively generated data », Nature, 631, 755-759. 10.1038/s41586-024-07566-y Mesure ce que devient un modèle réentraîné sur ses propres sorties : les queues de la distribution disparaissent d'abord, c'est-à-dire ce qui était rare. Cité ici comme analogue mesuré de l'attracteur, avec sa limite explicite : il s'agit d'une boucle de réentraînement, pas d'une boucle d'interrogation.
- Somers, H. (2005). « Round-trip Translation: What Is It Good For? », Australasian Language Technology Workshop, 127-133. aclanthology.org/U05-1019 L'objection de fond : l'aller-retour note très mal un traducteur automatique, car les erreurs de l'aller et du retour se compensent. Reprise ici sans être écartée ; elle ne vise pas le même usage, mais elle motive directement l'alternance des traducteurs.
- Moon, J., Cho, H. et Park, E. L. (2020). « Revisiting Round-Trip Translation for Quality Estimation », EAMT. arXiv:2004.13937 Réhabilite l'aller-retour en changeant ce qu'on compare : des plongements de sens au lieu d'une coïncidence de mots. C'est la réponse technique à Somers, donc la justification du critère de fidélité employé ici, qui porte sur les affirmations et non sur la forme.
- Skorobogat, R., Prabhu, A. et Bethge, M. (2026). Round-Trip Translation Reveals What Frontier Multilingual Benchmarks Miss, 14 avril 2026. arXiv:2604.12911 Mesure une corrélation de 0,94 entre un score d'aller-retour et les préférences d'utilisateurs, là où deux bancs d'essai multilingues établis tombent à −0,09 et −0,26. C'est la mesure la plus récente que l'aller-retour capte quelque chose de réel. Elle porte toutefois sur les modèles, non sur le texte : elle appuie l'usage fait ici sans le démontrer.
- Goodhart, C. A. E. (1975). « Problems of Monetary Management: The U.K. Experience », Papers in Monetary Economics, Reserve Bank of Australia. L'observation d'origine, faite sur les agrégats monétaires britanniques : une régularité statistique cesse de tenir dès qu'on s'en sert comme cible de politique. Elle fonde la section sur la corruption du juge.
- Strathern, M. (1997). « "Improving ratings": audit in the British University system », European Review, 5(3), 305-321. Donne la formulation courte devenue proverbiale, à partir d'une enquête ethnographique sur l'évaluation des universités. La source est citée pour la formulation exacte, non pour une reprise de seconde main.
- Gao, L., Schulman, J. et Hilton, J. (2023). « Scaling Laws for Reward Model Overoptimization », ICML, PMLR 202, 10835-10866. arxiv.org/abs/2210.10760 Fait tenir à un modèle de récompense le rôle du juge humain et mesure ce qui arrive quand on optimise contre lui : la note monte, la qualité réelle plafonne puis redescend, selon une forme fonctionnelle ajustée. C'est la loi de Goodhart rendue quantitative, sur un sujet que cet article ne traite pas directement.
- Efron, B. et Morris, C. (1977). « Stein's Paradox in Statistics », Scientific American, 236(5), 119-127. Exposé accessible du rétrécissement vers la moyenne : une valeur choisie parce qu'elle était la plus grande surestime ce qu'elle mesure. Ce qu'il faut lui retrancher dépend du rapport entre bruit et dispersion réelle. C'est la formule encadrée de cet article, qui date donc des années cinquante.
- Efron, B. (2011). « Tweedie's Formula and Selection Bias », Journal of the American Statistical Association, 106(496), 1602-1614. 10.1198/jasa.2011.tm11181 Relie explicitement le rétrécissement au biais de sélection : les quelques plus grandes estimations surestiment leurs paramètres, la correction s'écrivant à partir de la densité marginale observée. C'est l'adresse exacte du facteur employé ici.
- Ioannidis, J. P. A. (2005). « Why Most Published Research Findings Are False », PLoS Medicine, 2(8), e124. 10.1371/journal.pmed.0020124 Rend quantitative la dépendance entre le nombre d'hypothèses explorées et la probabilité qu'un résultat rapporté soit faux. C'est le même mécanisme que celui simulé ici, appliqué à la littérature scientifique.
- Capen, E. C., Clapp, R. V. et Campbell, W. M. (1971). « Competitive Bidding in High-Risk Situations », Journal of Petroleum Technology, 23(6), 641-653. Origine de l'expression « malédiction du vainqueur », sur les enchères de concessions pétrolières : le gagnant est celui dont l'estimation était la plus haute, donc la plus fausse. Même structure que la sélection sur un jeu de validation.
- Bergstra, J. et Bengio, Y. (2012). « Random Search for Hyper-Parameter Optimization », Journal of Machine Learning Research, 13, 281-305. jmlr.org/papers/v13/bergstra12a Montre qu'à budget égal, tirer les réglages au hasard bat une grille régulière, parce que la performance ne dépend fortement que de quelques réglages et qu'une grille répète ses essais sur les autres. C'est la référence de comparaison de la section sur la sélection de modèle.
- Dwork, C., Feldman, V., Hardt, M., Pitassi, T., Reingold, O. et Roth, A. (2015). « The reusable holdout: Preserving validity in adaptive data analysis », Science, 349(6248), 636-638. 10.1126/science.aaa9375 Sépare les questions posées d'avance de celles qui dépendent des réponses déjà obtenues et construit un mécanisme qui rend au jeu mis de côté une validité chiffrée sous interrogation adaptative, au prix d'un budget explicite de désaccords. C'est la démonstration, côté informatique théorique, que le budget est une nécessité et non une prudence.
- Bailey, D. H., Borwein, J. M., López de Prado, M. et Zhu, Q. J. (2014). « Pseudo-Mathematics and Financial Charlatanism: The Effects of Backtest Overfitting on Out-of-Sample Performance », Notices of the American Mathematical Society, 61(5), 458-471. 10.1090/noti1105 Calcule l'espérance du maximum de \(N\) essais sans talent, en majore la croissance par \(\sqrt{2\ln N}\) et en tire un théorème de longueur minimale d'historique. C'est la source de la règle de budget de cet article, qui ne fait que la transposer ; l'antériorité est entière et la majoration elle-même vient de la théorie des valeurs extrêmes.
- Roelofs, R., Shankar, V., Recht, B., Fridovich-Keil, S., Hardt, M., Miller, J. et Schmidt, L. (2019). A Meta-Analysis of Overfitting in Machine Learning, NeurIPS. Compare, sur plus de cent compétitions Kaggle, les classements publics issus de milliers de soumissions aux classements privés révélés une fois : le surajustement observé est faible. C'est la contre-preuve empirique de la théorie du pire cas et la raison de parler de multiplicité effective plutôt que de nombre de tours.
- Varoquaux, G. (2018). « Cross-validation failure: Small sample sizes lead to large error bars », NeuroImage, 180, 68-77. 10.1016/j.neuroimage.2017.06.061 Montre que l'écart type entre plis sous-estime fortement l'incertitude réelle d'une estimation par validation croisée, au point de rendre douteuses des comparaisons publiées, avec des barres de l'ordre de dix points pour cent échantillons. C'est la justification de la décomposition mesurée ici.
- probabl (2026). skills, compétences d'agent pour scikit-learn, skrub et skore, licence BSD à trois clauses. github.com/probabl-ai/skills Suite de compétences qui enchaîne exploration, construction, test de fumée, évaluation et audit, avec une boucle extérieure de proposition d'expérience. Elle sert ici d'exemple de boucle Ralph dont le juge et les conditions d'arrêt sont écrits, notamment son arbre de décision sur le choix du découpage.
- Qiu, X. et al. (2024). TFB: Towards Comprehensive and Fair Benchmarking of Time Series Forecasting Methods. arxiv.org/abs/2403.20150 Protocole de comparaison ouvert pour la prévision de séries temporelles, construit pour éviter les comparaisons faussées par des réglages inégaux. C'est le cadre d'évaluation retenu par le projet décrit ici.
- Ansari, A. F. et al. (2024). Chronos: Learning the Language of Time Series. arxiv.org/abs/2403.07815 Modèle de fondation qui traite une série numérique comme une suite de symboles, à la manière d'un modèle de langage. Candidat du comparatif, sans présomption de supériorité.
- Das, A. et al. (2024). A decoder-only foundation model for time-series forecasting. arxiv.org/abs/2310.10688 L'autre famille de modèles préentraînés du comparatif, entraînée sur un vaste corpus de séries pour prévoir sans réapprentissage. Sa taille en fait le test de faisabilité sur processeur du projet.
- Angelopoulos, A. N., Bates, S., Fisch, A., Lei, L. et Schuster, T. (2022, révisé 2025). Conformal Risk Control. arxiv.org/abs/2208.02814 Étend la prédiction conforme à des notions de risque plus générales que le taux de couverture, avec une garantie valable en moyenne sous hypothèse d'échangeabilité. C'est l'hypothèse que la dépendance des séries financières met en difficulté, comme le reconnaît la fiche du projet.
- Madaan, A., Tandon, N., Gupta, P., Hallinan, S., Gao, L., Wiegreffe, S. et al. (2023). Self-Refine: Iterative Refinement with Self-Feedback, NeurIPS. arxiv.org/abs/2303.17651 Boucle où le même modèle produit, critique sa production puis la corrige, sans signal extérieur. Antérieure à la technique Ralph, elle établit que l'itération critique-correction n'a rien de propre à celle-ci.
- Shinn, N., Cassano, F., Berman, E., Gopinath, A., Narasimhan, K. et Yao, S. (2023). Reflexion: Language Agents with Verbal Reinforcement Learning, NeurIPS. arxiv.org/abs/2303.11366 Conserve d'un essai à l'autre une mémoire de commentaires en langue naturelle qui tient lieu de signal d'apprentissage. Second antécédent qui montre que la mémoire entre tours précède également la technique Ralph.
Deux pistes pour aller plus loin : Mes livres préférés en IA, pour le panorama commenté et la galerie de sprezzature, pour voir un corpus de figures entièrement passé par la boucle.