En bref
Depuis dix ans, j'applique aux projets d'intelligence artificielle en entreprise le même crible : trois portes, à franchir dans cet ordre. Utile : le problème est-il réel et chiffré ? Utilisable : l'outil résiste-t-il à des mains réelles ? Utilisé : revient-on encore vers lui à la troisième semaine ? Chaque porte a sa façon d'échouer et j'ai vu les trois à l'œuvre sur le terrain.
Les questions à poser, porte par porte, ferment l'essai dans la boussole du lundi matin. Le sommaire, juste en dessous, vous laisse choisir votre chemin.
Une corde et un cerf-volant
Qu'est-ce qui empêche un cerf-volant de monter ? Sa corde, répond le bon sens. Coupez-la pour voir : le cerf-volant tombe.
C'est l'image qu'André Gide lance à son public le 25 mars 1904 à Bruxelles, à la Libre Esthétique. Ce salon d'avant-garde accroche cette année-là près de deux cents toiles de Manet, Monet, Degas, Renoir, Van Gogh1. Quatre conférences accompagnent le salon. La poésie, la peinture et la musique sont déjà prises : on lui confie le théâtre. Gide parle en blessé. Sa pièce Le Roi Candaule n'a tenu qu'une seule représentation en 1901 et son Saül attend depuis six ans un directeur qui ose le monter2.
Le théâtre de son temps, soutient-il ce soir-là, meurt de sa propre facilité et il faut lui retrouver des contraintes pour le sauver. Croire que l'art s'élève d'autant plus haut qu'il est plus libre, « c'est croire que ce qui retient le cerf-volant de monter, c'est sa corde ». Il aligne ses preuves. Un défaut du marbre aurait donné, raconte-t-on, sa pose ramassée au Moïse de Michel-Ange. Le petit nombre d'acteurs disponibles a donné à Eschyle le silence de Prométhée enchaîné. La Grèce a proscrit celui qui ajouta une corde à la lyre. « Le grand artiste est celui qu'exalte la gêne, à qui l'obstacle sert de tremplin. » Puis vient la phrase :
« L'art naît de contrainte, vit de lutte, meurt de liberté. »
Gide l'a forgée en transposant Léonard de Vinci, qui écrivait de la force mécanique qu'elle « naît par violence et meurt par liberté »3. La contrainte a pris la place de la violence, l'art celle de la physique. Une phrase de mécanique est devenue une phrase sur l'art.
Moi, je pratique des mathématiques appliquées avec un ordinateur en entreprise. On appelle cela aujourd'hui intelligence artificielle. Je préfère la version longue, parce que chaque mot y travaille. Les mathématiques apportent la rigueur : un modèle est une phrase qu'on peut prouver fausse. L'ordinateur apporte le réel du calcul, des données qui arrivent sales, des machines qui coûtent, des temps de réponse qui se mesurent. L'entreprise apporte le réel des gens, des budgets, des clients, des équipes qui n'ont pas le temps.
Depuis plus de dix ans, j'aide des entreprises à bâtir ces systèmes du prototype à la production. J'en ai bâti pour la fraude à la carte bancaire, l'analyse de prélèvements en laboratoire, des examens optiques raccourcis, la prévision de demande, la vidéo et la musique à l'échelle industrielle, puis des agents. Tout cet essai se joue entre le prototype et la production, alors regardons-les de près. Le prototype, vous l'avez déjà vu : c'est la maquette qui épate la réunion, dix exemples choisis sur lesquels elle marche, un mercredi, devant des gens bienveillants. La production ressemble au même système, sauf qu'il faut désormais vivre avec lui. Il y a les vraies données, les pannes, les budgets, les humeurs, des équipes qui ne vous ont rien demandé, le vendredi à dix-huit heures compris.
Les métiers de mes clients sont des langues. J'apprends celle de chacun, je leur prête la mienne. Dans ces allers-retours, la phrase de Gide est devenue la définition pratique du métier que j'aime.
La contrainte est le problème à résoudre : la vraie définition du succès, le chiffre qu'on s'engage à faire bouger. J'appelle cela utile, parce que la valeur naît d'une contrainte résolue. Un projet qui n'en résout aucune n'a pas de raison d'exister.
La lutte oppose la belle théorie à la réalité du terrain : l'interface, l'intégration, la confiance. J'appelle cela utilisable, parce que l'outil se forge dans cette lutte contre le réel. Il y a des problèmes de terrain à résoudre, des habitudes à bousculer sans les briser, pour que l'innovation paie dans les mains des métiers.
La liberté a pour moi le goût du travail accompli : la transmission, un système qui tourne sans moi, le droit de passer au projet suivant. J'appelle cela utilisé, parce que la preuve se récolte avec cette liberté. Un usage devenu quotidien libère tout le monde, les équipes d'abord, le praticien ensuite.
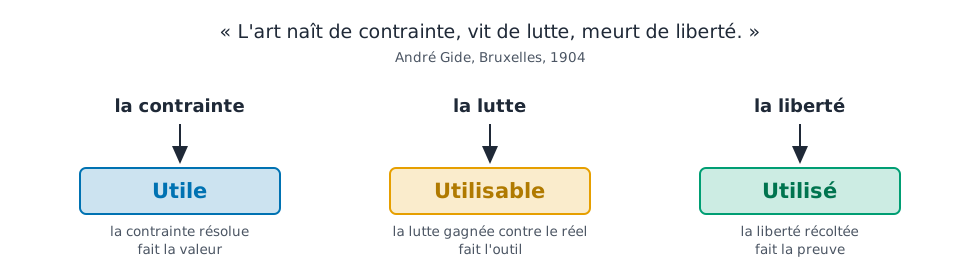
La phrase de Gide, transposée au métier : trois mots, trois U.
Utile, utilisable, utilisé : trois adjectifs pour un crible, celui qui sépare un projet qui dure d'une démonstration qui brille un jour.
Un crible sans inventeur
Les trois U viennent d'avant moi. À ma connaissance, personne ne peut les revendiquer, ce qui est plutôt bon signe : les cadres qui servent n'appartiennent à personne.
Les fondations ont plus de trente ans. En 1989, Fred Davis montre que deux perceptions prédisent l'adoption d'une technologie : son utilité d'abord, sa facilité d'usage ensuite, la première pesant plus lourd que la seconde4. Jakob Nielsen décompose ce qui rend un système bon à prendre : l'utilité (fait-il la bonne chose ?) multipliée par l'utilisabilité (peut-on s'en servir ?)5. La norme ISO 9241-11 définit cette utilisabilité noir sur blanc : efficacité, efficience, satisfaction, pour des utilisateurs donnés dans un contexte donné6. La recherche francophone a son propre triptyque : utilité, utilisabilité, acceptabilité7. Puis les praticiens ont usé les mots à force de s'en servir. Useful, usable, used est passé dans la langue des designers8 et la recherche en santé réclame désormais des résultats « useful, usable and used », utiles, utilisables et utilisés9.
Le parti pris de ce crible s'appelle le troisième U. L'université prédit une acceptabilité, le praticien constate un usage. Personne ne me paie pour qu'un système soit acceptable sur le papier. On me paie pour qu'un lundi matin ordinaire, quelqu'un l'ouvre sans même y penser. De là trois devises, forgées sur le terrain :
- La pertinence dans les systèmes bat les slogans. L'utile ne se proclame pas, il se lit dans les chiffres d'un système qui tourne.
- L'intégration dans les habitudes de travail bat la démonstration. La plus belle démonstration du monde pèse moins qu'un outil qui entre dans la routine du mercredi matin, dans les logiciels déjà ouverts.
- La rétention bat le volume. Le nombre d'utilisateurs du premier mois est une vanité. La rétention compte ceux qui reviennent au troisième mois, quand la curiosité est retombée et qu'il ne reste que le service rendu.
Pourquoi un crible ? Parce que les projets d'intelligence artificielle échouent en masse. Les chiffres qui circulent à ce sujet méritent, eux aussi, leurs barres d'erreur et trois d'entre eux tombent à la première vérification :
- Le fameux « 85 % des projets IA échouent » vient d'un communiqué Gartner de 2018 qui prédisait autre chose, des résultats erronés pour cause de biais à l'horizon 2022. Cette prédiction n'a jamais été évaluée depuis10.
- Le « 87 % », lui, vient d'un article sponsorisé qui ne cite aucune source primaire11.
- Le « 95 % des pilotes d'IA générative sans retour mesurable » du MIT se qualifie lui-même de « directionally accurate », directionnellement exact, élégante façon de demander l'indulgence12.
Vient alors la RAND Corporation, la source qu'on cite le plus et qu'on lit le moins. Dès l'ouverture de son rapport de 2024, une incise attend le lecteur et tout le monde la saute : « selon certaines estimations », plus de 80 % des projets d'intelligence artificielle échouent. Trois mots changent le statut du chiffre, puisque l'incise l'emprunte au lieu de le mesurer. RAND a produit en propre soixante-cinq entretiens avec des praticiens chevronnés du public et du privé. Ces entretiens remontent aux causes, pas au taux. La première qui en ressort est un malentendu sur le problème à résoudre13. La leçon sur les causes est donc de première main, le pourcentage de seconde main. Je n'ai aucun autre chiffre à mettre à sa place.
Gardons la hiérarchie des causes : on échoue sur le problème (utile), sur le terrain (utilisable), sur l'adoption (utilisé). Le crible ne dit rien de plus. Entrons par la première porte.
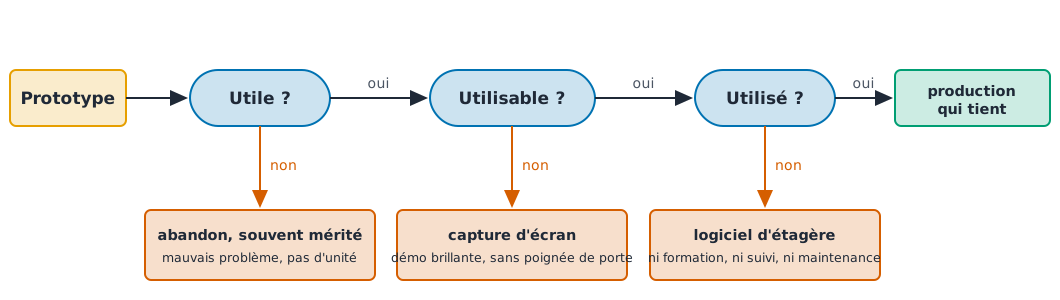
Le crible des trois U, du prototype à la production : à chaque porte son mode d'échec.
Utile : la contrainte
Quand on soupçonne un infarctus, on dose dans le sang une protéine, la troponine : plus elle monte, plus le cœur souffre. Confiez à un modèle l'estimation de ce risque. Il a deux façons de se tromper. S'il vise trop haut, un patient occupe un lit pour rien. S'il vise trop bas, ce patient rentre chez lui où il peut en mourir. L'erreur a la même taille dans les deux cas. Seul son signe change et la conséquence se renverse. Un système d'intelligence artificielle qui ignore cette asymétrie a choisi, par défaut, de traiter les deux erreurs pareil. Ce « par défaut symétrique » ressemble à une absence de choix : c'est un mauvais choix fait en silence.
Tout commence bien avant le premier modèle, à l'instant où un besoin se change en idée. Bien avant le « ce serait formidable », une idée d'intelligence artificielle commence par quelqu'un qui a un problème. L'effet wow passe devant ce problème et mon travail consiste à aller chercher ce qu'il masque. Je poursuis donc avec une question qui paraît triviale : quelle est l'unité ? Il y en a cinq : l'argent, le temps, l'énergie, le soin et l'impossible devenu possible. Le temps se compte en minutes de soignant ou d'ouvrier rendues au métier. L'énergie, en calculs, en trajets, en gaspillages évités. Le soin, en erreurs médicales esquivées, en inconfort réduit. L'impossible est la seule monnaie exotique des cinq : ce qui ne se faisait pas du tout, lire chaque avis client, écouter chaque minute d'antenne, décrire chaque image d'un catalogue entier. Si votre projet ne paie dans aucune de ces monnaies, vous tenez un jouet. Et le silence qui suit ma question est déjà une donnée.
Pour passer de l'unité au chiffre, il me faut un outil que tout le monde sache lire : la matrice de confusion. Le nom intimide, l'objet est simple. Prenez une décision binaire, fraude ou pas fraude, puis croisez deux questions : qu'a dit le système ? qu'est-ce qui était vrai ? Deux réponses possibles à chaque question font quatre issues, pas une de plus :
- Le système signale une fraude réelle : c'est une bonne détection (les ingénieurs disent vrai positif). L'alarme a sonné au bon moment.
- Il accuse un client honnête : c'est une fausse alarme (faux positif). L'alarme a sonné pour rien.
- Il laisse passer une fraude : c'est un raté (faux négatif). L'alarme s'est tue au pire moment.
- Il laisse tranquille un client honnête : c'est un rejet correct (vrai négatif), le silence des bons jours.
Tout modèle de décision, du plus simple au plus profond, finit dans ces quatre cases. Compter ce qui tombe dans chacune sur une année, c'est déjà le connaître.
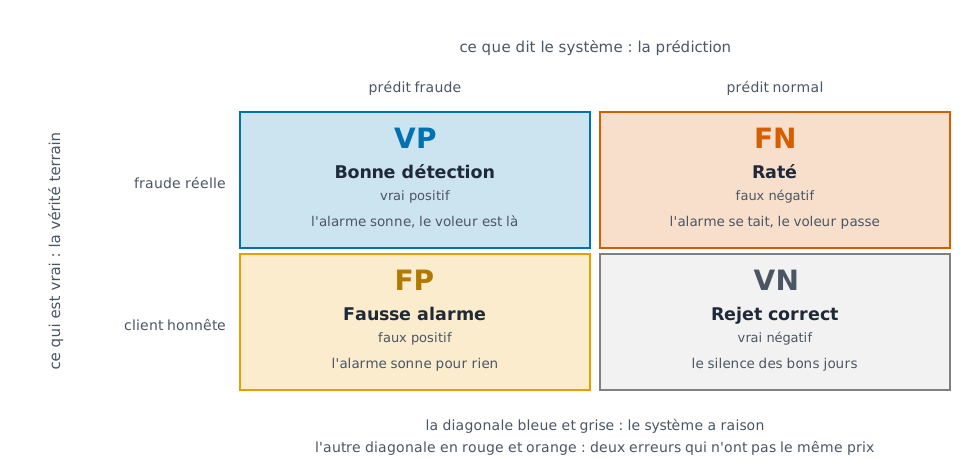
La matrice de confusion : deux questions croisées, quatre issues.
La méthode consiste alors à poser sur ce comptage la matrice des conséquences métier, chiffrées dans l'unité du client. Le bon indicateur, celui qu'un dirigeant regarde pour décider, naît dans le métier, jamais dans un laboratoire. Il mesure ce que le système rapporte, net de ses erreurs, dans la monnaie du métier.
Les ingénieurs ont leurs cadrans internes pour cela et je les présente à mes étudiants de MBA avec deux Avengers. La précision est l'archer Hawkeye : quand il tire, il touche. Elle répond à une question : quand le système crie à la fraude, a-t-il raison ? Le rappel est le colosse Hulk : rien de ce qu'il y a à détruire ne lui échappe. Il répond à une autre : sur cent fraudes réelles, combien le système en attrape-t-il ? L'archer rate peu mais laisse passer. Le colosse n'épargne rien et casse le mobilier avec. Aucun des deux n'est le bon héros en toutes circonstances, car tout dépend du prix du meuble et du prix de la cible manquée. Réunissez le rappel de Hulk et la précision de Hawkeye et vous aurez l'intelligence artificielle parfaite, celle qui attrape tout et ne touche que ses cibles. Elle n'existe pas. Mon travail est de doser l'un contre l'autre, au prix du métier. Ces cadrans servent à régler la machine. Ils ne disent rien à un conseil d'administration.
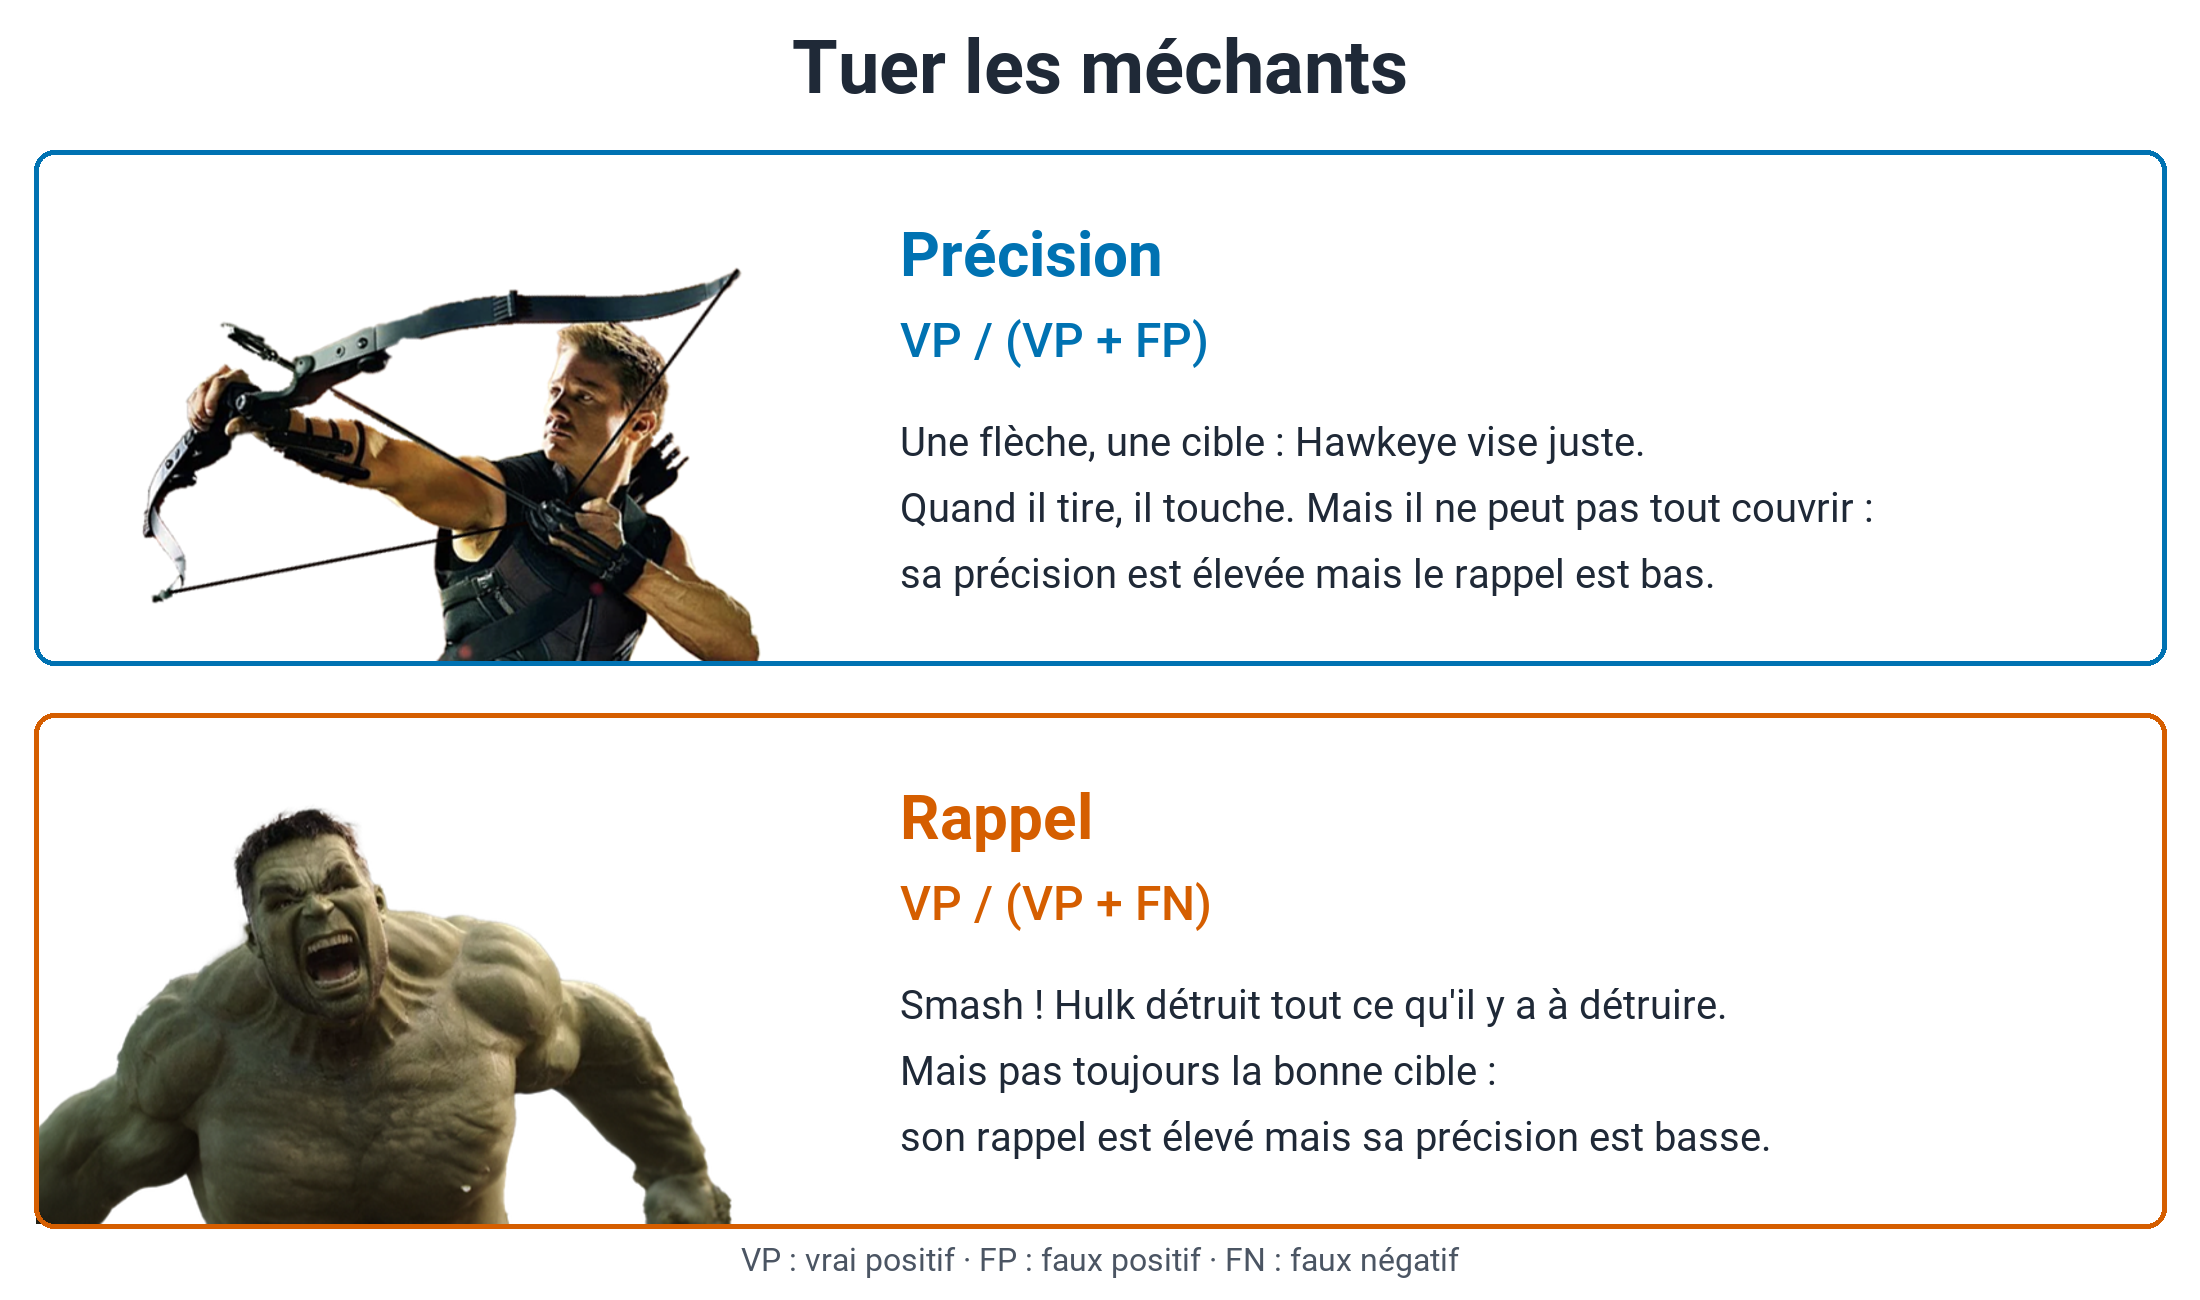
D'après une diapositive de mon cours MBA : Hawkeye pour la précision, Hulk pour le rappel. Personnages © Marvel.
Dans une salle de comité, seule la traduction en monnaie du métier fait bouger quelqu'un. En ophtalmologie, un client voulait raccourcir les examens optiques et le succès ne s'est pas mesuré en « précision » : un examen est passé de quatre minutes dix à deux minutes sept, à prescription égale. Deux cent cinquante secondes devenues cent vingt-sept, presque la moitié de gagnée ! Nous y sommes arrivés en punissant la machine plus durement pour les erreurs qui coûtent de l'inconfort au patient : c'est ce qu'on appelle une fonction de perte asymétrique. Mesuré, pas extrapolé.
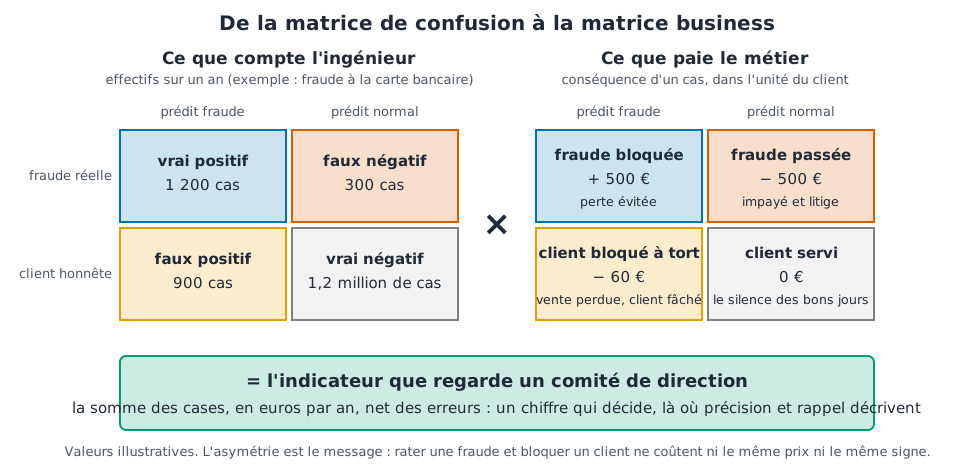
Chaque case a un prix, qui suit le montant de la commande : l'asymétrie des erreurs est le message.
Un cas entier s'impose ici, parce qu'un crible se juge sur un jour de décision. J'ai passé six ans chez un e-commerçant de pièces automobiles où la détection de fraude à la carte bancaire tournait depuis des années sans que personne s'en plaigne : le modèle affichait de bons scores, l'équipe les suivait chaque semaine, les tableaux de bord restaient verts. Le service client, lui, remontait une gêne que les scores ne voyaient pas : des clients honnêtes refusés au moment de payer, qui appelaient une fois, puis ne revenaient plus.
Aucun tableau de bord ne propose jamais le choix difficile que nous avons fait : accepter de laisser passer davantage de fraudes. Dit ainsi, c'est indéfendable. Dit dans l'unité du métier, c'est une addition. Une fraude qui passe coûte la commande, les frais de litige et le transport. Un client refusé à tort coûte la marge de cette commande, puis toutes celles qu'il passera chez le concurrent.
Nous avons donc réécrit la définition de l'erreur et laissé le modèle tranquille. Deux corrections ont suffi.
La première : une erreur n'a pas le même prix sur toutes les commandes. Refuser à tort un jeu de plaquettes de frein, laisser passer une fraude sur une boîte de vitesses complète : deux fautes de poids très différents, que la matrice de confusion range pourtant dans la même case. Nous avons remplacé les deux prix fixes par deux fonctions du montant : le prix de l'erreur se calcule désormais à partir de celui de la commande. Cette matrice-là, qui change à chaque commande, le système la minimise désormais. Un modèle de ce genre a toujours un seuil qu'on durcit ou qu'on relâche. Le régler au mieux du coût plutôt qu'au mieux d'un score est un premier progrès, faire entrer le coût dans l'apprentissage lui-même en est un second. L'ancien dilemme d'ingénieur entre précision et rappel change alors de bureau : il devient une décision de gestion, que la direction comprend, conteste, puis assume.
La seconde a remplacé le score par un regret. Le regret est l'écart entre ce que les décisions ont coûté et ce que les meilleures décisions possibles auraient coûté sur la même période. Un score se contemple. Un regret se compare à zéro, puis à celui de la politique la plus bête qu'on puisse tenir, tout accepter ou tout refuser. La politique bête devient ainsi le minimum à battre. En dessous, un système n'a rien à faire en production, quels que soient ses scores.
Regardez ce que cela a donné : la précision du modèle a baissé pendant que le chiffre d'affaires net des pertes montait. Dans n'importe quelle revue technique, c'était un échec ! Le gain s'est concentré là où l'argent se trouve, sur les grosses commandes, parce que ce sont elles qui pèsent le plus lourd dans la nouvelle définition de l'erreur. La dispute en comité a changé de terrain : elle visait désormais les deux fonctions du montant, donc la politique commerciale. Ce comité-là était la bonne salle pour en discuter.
L'intuition vaut-elle hors de ce client ? La mesure est en cours sur un jeu public de transactions par carte, dans un travail encore en évaluation par les pairs. Les données y sont coupées dans l'ordre du temps, pour que le système soit jugé sur des mois qu'il n'a jamais vus. Sur ces données, le regret baisse, surtout pour les gros montants.
Ces deux fonctions du montant cachent une décision commerciale dans un paramètre. Personne n'est là pour vérifier qu'elles sont justes. Écrivez-les mal et l'erreur entre tout droit dans ce que le système apprend, sans aucune relecture. Nous les relisons donc deux fois par an avec la finance et le produit, comme une grille tarifaire, jamais comme une constante physique. Ajoutez-y un retard cruel : un impayé se confirme des mois après la commande, si bien qu'on juge l'automne avec les réponses de l'hiver. Surveillez alors l'écart entre le regret prévu et le regret constaté : cette dérive donne la première alerte, bien avant qu'une métrique classique ne bouge. Depuis ce cas, j'ouvre mes projets autrement : j'écris la matrice des coûts avant de choisir le modèle, puis je la fais signer par quelqu'un dont le budget en dépend.
Un succès défini reste à protéger. « Quand une mesure devient une cible, elle cesse d'être une bonne mesure » : on met cette formule au compte de Goodhart, alors qu'on la doit à l'anthropologue Marilyn Strathern14, 15. Des théoriciens de l'apprentissage en ont depuis fait un théorème : tout indicateur plus simple que l'objectif qu'il remplace est piratable16. Inutile donc de chercher l'indicateur parfait. Il faut surveiller une divergence.
J'ai payé pour l'apprendre. Sur un orchestrateur audio en temps réel, nous avions un seuil de vitesse, le facteur temps réel ou RTF. Ce rapport entre durée de calcul et durée du signal devait rester sous 1. L'optimisation l'a traité comme une note à minimiser sans fin. Elle a atteint un RTF de 0,12, magnifique, pendant que le taux d'erreur de transcription augmentait de 300 %. Le système allait huit fois plus vite que demandé et se trompait quatre fois plus. Nous avons réparé la contrainte, sans toucher au modèle.
En 1974, Richard Feynman raconte l'histoire d'insulaires du Pacifique qui, après la guerre, reconstruisirent de mémoire une piste d'atterrissage : les feux, la cabane, les antennes en bambou, l'homme qui agite les signaux. Tout est exact, la forme est parfaite et aucun avion n'atterrit17. Il appelle cela la science du culte du cargo. Notre domaine excelle à ce jeu des formes : les bancs d'essai qui notent les modèles, les tableaux de bord, les tests A/B qui comparent deux versions. Tous ces instruments existent pour de bon et tous se fabriquent aussi en bambou.
Un test les départage, d'une brutalité salutaire. Cet instrument a-t-il déjà fait changer une décision ? Et si le chiffre était sorti autrement, l'aurait-il fait changer dans l'autre sens ? Un tableau de bord que personne ne regarde est un décor. Feynman arrêtait l'analogie à un endroit précis et je l'arrête au même : ces praticiens sont sincères, ni fraudeurs ni paresseux. Il leur manque une discipline envers leur propre esprit, celle qui débogue les bonnes surprises avec la même énergie que les mauvaises.
Elle coûte peu, cette discipline. Elle rapporte gros, parce que l'intuition se trompe avec aplomb. Prenez cette étude randomisée de 2025 sur des développeurs chevronnés équipés d'assistants de code. Ils se croyaient 20 % plus rapides. Ils étaient 19 % plus lents18. Près de quarante points séparent l'impression du chronomètre. On attribue à Peter Drucker l'adage « ce qui ne se mesure pas ne se gère pas ». W. Edwards Deming y voyait un mythe coûteux, parce que l'essentiel est souvent ce qu'on ne sait pas encore mesurer19. Donnez raison aux deux, dans cet ordre : mesurez d'abord à quel point vous êtes mauvais, dans la monnaie de votre métier, puis méfiez-vous de cette mesure. Reste à faire entrer ce succès dans des mains réelles.
Utilisable : la lutte
En 2020, GPT-3 existait déjà et le monde regardait ailleurs. En novembre 2022, deux ans plus tard, il a fallu cinq jours à ChatGPT pour changer la conversation publique. Qu'est-ce qui a bougé ? Une version courte de cette histoire circule, selon laquelle seule l'interface aurait changé. Elle est fausse : le cerveau a changé aussi. Au départ, il y a un modèle de la série GPT-3.5. Vient ensuite un entraînement propre au dialogue : des humains écrivent des réponses, puis le modèle apprend à partir de leurs préférences. La recette avait été publiée quelques mois plus tôt, en mars 2022, sous le nom d'InstructGPT20, 21. Entre « continuer un texte » et « suivre une consigne », il y a un entraînement entier. Aucune feuille de style ne fait ce travail.
Tout cet entraînement visait pourtant une seule chose, permettre à n'importe qui de s'adresser à cette capacité. La poignée de porte commence donc bien avant la boîte de texte. L'histoire garde quand même sa leçon : cent modèles capables n'ont jamais trouvé leur poignée. Telle est la lutte du deuxième U : la distance entre la belle théorie et la main qui doit s'en saisir.
Cette lutte a ses auteurs de chevet : Don Norman et sa psychologie des objets22, Steve Krug et son principe de moindre effort23. L'intelligence artificielle a les siens, avec les dix-huit règles d'interaction humain-IA que Microsoft a validées sur vingt produits24. La notion la plus utile en clientèle est la confiance calibrée : ajuster la confiance de l'utilisateur aux capacités réelles du système au lieu de la maximiser25. Car l'humain pardonne mal à la machine. Une seule erreur visible d'un algorithme suffit à provoquer son abandon, là où la même erreur humaine serait excusée26. À l'opposé, on observe une déférence excessive envers le chiffre machine27. Entre les deux, le design.
Mesurons l'enjeu sur une étude de terrain. Sept cent cinquante-huit consultants d'un grand cabinet ont été tirés au sort, avec ou sans assistant d'intelligence artificielle. À l'intérieur du domaine où le modèle est compétent, l'assistant a apporté un quart de vitesse en plus et une qualité jugée supérieure. À l'extérieur, il a coûté dix-neuf points de justesse28. Les auteurs parlent de frontière dentelée : la compétence de la machine avance sans la régularité d'une marée, en dessinant des caps et des criques invisibles depuis l'écran. La boîte de texte a la même apparence des deux côtés de cette frontière. L'utilisateur ne sent pas quand il quitte la zone où la machine excelle pour celle où elle déraille avec aplomb. Le premier travail du designer consiste donc à rendre cette frontière sensible : afficher la provenance, montrer l'incertitude, inviter à vérifier quand le terrain devient meuble.
Le designer industriel Raymond Loewy, qui a dessiné des locomotives comme des rouges à lèvres, avait un nom pour cela : MAYA, Most Advanced Yet Acceptable, le plus avancé qui reste acceptable. Un cran de trop et l'humain décroche. J'en ai tiré un curseur d'autonomie que je règle avec mes clients, à cinq crans : expliquer, suggérer, rédiger, approuver, agir seul. Une règle d'or place le curseur : plus une erreur coûte cher, moins l'intelligence artificielle garde d'autonomie.
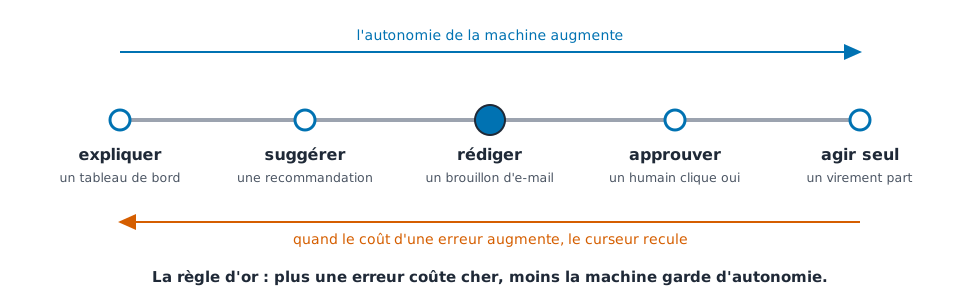
Le curseur MAYA : cinq crans d'autonomie, une règle d'or pour le placer.
Ce réglage relève du design au sens plein : la gouvernance fixe les limites, la conception décide de la place de l'humain. Telle interface pousse vers la décision, l'audit, la correction. Telle autre réduit l'opérateur à approuver sans comprendre. Les deux s'appellent « humain dans la boucle » sur les diapositives.
Une validation qui compte réclame cinq conditions :
- L'opérateur a le temps de lire.
- L'information est intelligible : un libellé, jamais un identifiant opaque.
- L'opérateur a la compétence pour juger.
- Il a le droit de refuser sans pénalité.
- Il dispose d'un canal indépendant de ce qu'on valide.
J'ai vu « réf. 58F2-C » s'afficher devant des opérateurs sommés d'approuver en cadence : un identifiant ne se valide pas, il se subit. Retirez une seule des cinq conditions et vous obtenez un théâtre de contrôle. Multiplier les confirmations sur des actions sans conséquence habitue l'opérateur à cliquer oui sans lire. Pour Ivan Illich, un outil est convivial lorsqu'il étend l'autonomie de la personne, hostile lorsqu'il l'asservit à son propre entretien29. Le deuxième U n'a pas, à mes yeux, de meilleure définition.
Dans le métier, ce deuxième U s'appelle le design : l'expérience plus l'interface. L'interface (UI, user interface) montre : l'écran, les couleurs, les boutons, la figure, le son. L'expérience (UX, user experience) fait vivre : le nombre d'actions pour arriver au résultat, ce qu'on comprend sans explication, ce qu'on ose tenter sans craindre de casser, la confiance qui s'installe ou ne s'installe pas. Les deux se confondent en réunion et cette confusion coûte cher. Il arrive qu'une interface superbe habille une expérience humiliante : trois écrans pour valider une action simple. Il arrive qu'une expérience bien pensée meure d'une interface illisible : le bon parcours écrit en gris pâle sur fond blanc. Le premier U se joue dans les chiffres. Le deuxième se joue dans le corps de l'utilisateur, ses yeux, ses mains, sa patience, sa dignité. Ce partage entre interface et expérience dépasse le goût personnel : il se mesure, donc il s'outille.
Chez moi, cet outillage est une suite logicielle en licence libre, sprezzature, publiée sur sprezzature.ai30. Elle tient en deux mots, fabriquer et auditer. Chaque brique qui produit est livrée avec l'auditeur qui la juge en quelques millisecondes, avant toute mise en service, que le code vienne d'un humain ou d'une machine. Les films de démonstration ont ainsi leur vérificateur, qui compare ce que le film affirme à ce que le projet contient. Un vrai bug de la maison l'a fait naître : cinq films annonçaient 127 types de figures quand le catalogue en comptait 167. Quarante types oubliés dans les pixels.
Tant que le design reste une opinion, il perd tous ses arbitrages face à un indicateur. Audité et bloquant avant la mise en service, il pèse comme pèse un test qui échoue. Le détail se trouve sur sprezzature.ai. Le mieux conçu des outils n'a pourtant rien prouvé encore : la dernière porte se franchit dans la durée.
Utilisé : la liberté
Jacques Tati a fait le portrait du gadget moderne : ses maisons ronronnent d'appareils qui fabriquent discrètement plus de travail qu'ils n'en épargnent. Beaucoup de pilotes d'intelligence artificielle finissent comme eux : on applaudit la démonstration, puis plus personne ne se connecte la troisième semaine. J'ai un test sans rien de scientifique, qui ne rate jamais : dans trois semaines, un jeudi après-midi ordinaire, ouvrirez-vous encore cet outil ? Un projet qui ne survit pas à ce jeudi banal est une capture d'écran.
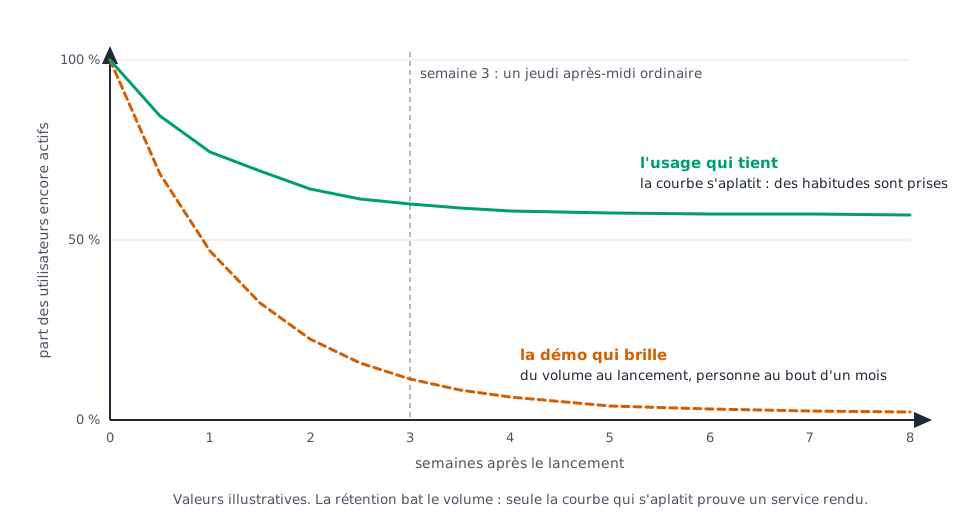
Deux destins d'un même lancement : la rétention bat le volume.
Si vous avez déjà publié une vidéo, vous connaissez une courbe de rétention : YouTube montre aux créateurs, seconde après seconde, la part du public encore là. La mienne compte des personnes qui reviennent, semaine après semaine. Alex Schultz, qui dirigeait la croissance de Facebook, en a tiré en 2014 le critère le plus simple du métier. Une courbe de rétention qui devient parallèle à l'axe du temps signale un produit qui tient. Une courbe qui file vers zéro signale qu'il n'y a rien à tenir32. Mon test du jeudi après-midi n'en est que la version artisanale.
Le troisième U a un nom savant depuis 1997. Parasuraman et Riley classent nos rapports à l'automatisation en quatre familles, usage, mésusage, désusage, abus33. Le désusage désigne ces opérateurs qui abandonnent un système fiable après quelques fausses alarmes : le silence s'installe. Dans les organisations, le même abandon s'appelle shelfware, le logiciel d'étagère acheté à prix d'or et jamais ouvert35.
L'adoption individuelle de l'intelligence artificielle générative est la plus rapide de l'histoire des technologies : un dixième de la population adulte mondiale utilise ChatGPT38. Côté organisations, presque toutes déclarent utiliser l'intelligence artificielle, mais 21 % seulement ont redessiné un flux de travail40. Et 78 % des employés du savoir apportent au bureau leurs propres outils d'intelligence artificielle, sans aval de l'entreprise41. L'usage déborde l'officiel. Je lis ce débordement comme un plombier lit une fuite : une informatique qui propose une intelligence artificielle médiocre fabrique elle-même son intelligence artificielle de l'ombre. Ce contournement accuse un produit, pas les employés.
Alors, que fait-on pour être utilisé ? Trois choses, prosaïques comme un contrat de maintenance : on forme, on suit, on entretient.
D'abord la formation. Chez un client qui analyse des prélèvements en laboratoire, la réussite n'a pas tenu au modèle. Elle a tenu à l'acculturation de toute la chaîne, direction, techniciens, scientifiques, vendeurs, avec des humains dans la boucle pour étiqueter les exemples dont la machine apprend. L'intelligence artificielle la moins chère que vous aurez jamais est votre équipe actuelle, montée en compétence. La formation a aussi une face sombre, que Lisanne Bainbridge, psychologue du travail, a nommée dès 1983 les ironies de l'automatisation : l'humain qu'on place en dernier recours est celui qu'on a le plus désentraîné42. Je recommande donc partout une réserve d'environ 20 % de travail sans assistance, comme le pilote repasse au simulateur tous automatismes coupés.
Les philosophes ont une image pour cette érosion de la compétence : le bateau de Thésée. On en remplace les planches une à une, jusqu'à se demander ce qui reste du bateau d'origine. Faites pareil avec une équipe en confiant à un agent, tâche après tâche, ce qu'elle faisait. Demandez-vous alors, avant qu'il ne soit tard : que reste-t-il de la compétence qui permettait de surveiller l'agent ? Un dirigeant technique a raconté en public ses quarante jours de développement remis à une équipe entièrement artificielle, milliards de jetons de calcul à l'appui43. Le récit est enthousiaste et la question qu'il laisse ouverte est la bonne : le jour où l'agent se trompe, qui, dans l'équipe, sait encore le voir ? La réserve sans assistance n'a rien d'une coquetterie de puriste : elle entretient le juge humain.
Ensuite le suivi. Les alertes contournées sont la règle : en médecine, 49 à 96 % des alertes de sécurité médicamenteuse lancées à la prescription sont ignorées44. Un validateur qui n'a jamais refusé n'a pas validé. Je relève donc trois chiffres : le taux de refus, le taux de contournement, la rétention à trois semaines. Chez moi, ce sont des indicateurs de première classe, au rang de la justesse du modèle.
Enfin la maintenance. La recherche l'a bien établi : dans un système d'apprentissage automatique réel, le code du modèle est une petite boîte au centre d'une immense tuyauterie. La dette technique s'y accumule : tout ce qu'on a remis à plus tard renchérit chaque changement45. CRISP-DM, la méthode sur laquelle une génération de spécialistes des données s'est formée, relègue le déploiement en sixième et dernière phase, à peine décrite46. Les ingénieurs interrogés par la recherche le disent sans détour : on n'a aucune idée du comportement d'un modèle en production avant la production47. Une conférence que je donne souvent en a pris son titre, la tuyauterie de l'intelligence artificielle : les 90 % que personne ne photographie48.
Deux fables récentes du secteur finissent la démonstration. Zillow a laissé un modèle de prix acheter des maisons : prédire était devenu agir et l'entreprise a déprécié 304 millions de dollars dans ses comptes49. Klarna a remis son support client à des agents, s'en est félicitée en public50, puis a rebroussé chemin51. On dirait volontiers « le modèle était mauvais ». La vraie faute est d'avoir autorisé le modèle à agir sans relecture sur un poste où l'erreur coûte cher. La correction porte donc sur la permission : le modèle peut rester, il perd le droit d'agir sans relecture.
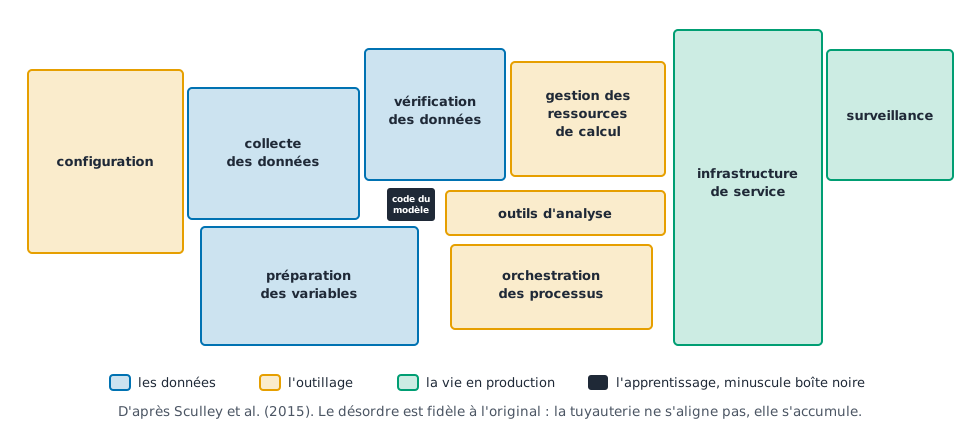
La petite boîte et la tuyauterie, d'après Sculley et al. (2015) : le code du modèle est la plus petite pièce du système.
Une chose étrange arrive quand ces trois chantiers aboutissent : l'intelligence artificielle ne s'annonce plus. Son nom même peut sortir du discours. En 2023, Microsoft disait douze fois « IA » dans ses résultats, Google cent quarante-trois fois en deux heures de conférence (plus d'une fois par minute), Apple zéro. Une intelligence artificielle qu'on ne nomme plus, parce qu'elle fait partie de l'outil, est la forme achevée du troisième U. Si votre initiative a encore besoin d'un événement de lancement et d'un courriel de rappel, vous avez livré un outil, pas un usage.
Ici la liberté prend son sens plein. Une phrase surprend à la fin de mes contrats de déploiement : nous organisons notre sortie. Je livre un guide d'intégration, je forme, j'assure le support, puis je m'en vais. Un projet réussi n'a plus besoin de moi. J'enseigne aussi pour cette raison, dans un EMBA depuis 2022 et ailleurs : transmettre est la version généralisée de partir.
Quand les agents s'en mêlent
Ce qui précède date d'avant les agents. Ils l'amplifient sans rien abolir.
Un agent, au sens où l'industrie l'entend depuis 2024, est un grand modèle de langage, du type de ChatGPT, qui dirige son propre processus : il perçoit, planifie, agit par des outils, boucle52. Anthropic distingue utilement le workflow, chemin prédéfini qui orchestre un modèle, de l'agent, qui choisit son chemin53. Le constructeur y ajoute un conseil contre-intuitif : commencez simple, n'ajoutez de l'autonomie que si elle paie.
Une chose a pourtant changé de nature : la barrière technique s'est effondrée. Un après-midi suffit désormais à l'agent pour écrire du code qui tourne, monter une maquette, brancher une base de données. Il fallait un trimestre. Je traite un agent de code comme nos aînés ont traité le compilateur. Ce programme, qui traduit le code en instructions pour la machine, a été une montée d'abstraction : il a déplacé le jugement des programmeurs sans les supprimer. Or construire ne distingue plus personne quand tout le monde construit. Le prototype devient presque gratuit, donc le crible gagne la valeur que perd la technique. Il reste à savoir quoi construire (utile), pour quelle main (utilisable), avec quelle suite dans les idées (utilisé). Plus la barrière technique s'abaisse, plus les trois U deviennent le métier.
Prenez l'utile : les agents aggravent le péché originel, coder avant de définir le succès. Gartner prédit l'annulation de plus de 40 % des projets d'intelligence artificielle agentique d'ici fin 2027, pour coûts croissants, valeur métier floue et contrôles de risque inadéquats. Il baptise la maladie agent washing, l'agent de façade54. Chez McKinsey, le paradoxe se chiffre : huit entreprises sur dix déploient de l'intelligence artificielle générative, autant n'en voient aucun effet sur le résultat55. À Princeton, des chercheurs trouvent la mesure elle-même cassée : des benchmarks d'agents optimisés sur la seule exactitude, sans coût ni reproductibilité, fabriquent des agents inutilement complexes56.
Passez à l'utilisable. Pour la première fois en soixante ans, la manière même de commander une machine change : on spécifie des intentions au lieu de commander des actions57. Le design règle désormais des niveaux d'autonomie supervisée, là où il dessinait des écrans. Le curseur MAYA n'a jamais autant servi.
Arrivez à l'utilisé et vous rencontrez un mur, la fiabilité composée. L'arithmétique tient sur un ticket de métro. Supposez un agent fiable à 95 % sur chaque étape, ce qui est flatteur, puis donnez-lui une tâche en vingt étapes. Il faut que tout réussisse, donc 0,95 multiplié par lui-même vingt fois : à peine plus d'une chance sur trois d'aller jusqu'à la fin. À cinquante étapes, moins d'une chance sur dix. Des agents brillants à la démonstration s'effondrent donc sur la longueur.
Les mesures le confirmaient brutalement au départ. À la sortie d'OSWorld en 2024, un banc d'épreuves fait de vraies tâches bureautiques, les humains en réussissaient 72 %, le meilleur agent 12 %58. Ces deux nombres ont deux ans et les écrire au présent serait mentir. Le 28 juillet 2025, le banc a été repris et nettoyé : les scores d'avant et d'après ne se comparent donc pas ligne à ligne59. Ils ont grimpé vite depuis. Un travail franchit la barre humaine dans sa révision de février 2026, 72,6 % contre 72,36 %60. Lisez le protocole avant de conclure. Ce record s'obtient en lançant l'agent plusieurs fois sur la même tâche, puis en faisant choisir la meilleure tentative par un juge. Il dit ce qu'un agent atteint quand on lui paie plusieurs essais. Réussir du premier coup est une autre promesse, à un autre prix.
Face à des utilisateurs simulés sous règles métier, les meilleurs modèles échouent plus d'une fois sur deux. Confiez-leur huit fois la même tâche et la proportion de tâches réussies à chaque fois s'effondre encore, car l'agent ne rate pas toujours la même marche61. Un service client gagne la confiance en réussissant à chaque fois. Réussir souvent n'y suffit pas. La trajectoire est réelle : la longueur des tâches qu'un agent mène à bien double environ tous les sept mois62. Une trajectoire n'est pas une garantie pour autant : c'est une pente, à surveiller comme toutes les divergences.
Et il y a la leçon amère. Richard Sutton a observé en 1100 mots que, sur soixante ans, les méthodes générales qui convertissent du calcul en performance finissent par battre les règles du métier patiemment écrites à la main par des experts63. Les échecs, le go, la parole, la vision : quatre fois la même histoire. L'économie l'explique, avec deux horloges pour un seul budget : votre projet compte en trimestres, le coût du calcul chute sur une courbe décennale. Les règles écrites à la main sont un capital figé qui vieillit, la méthode générale est un abonnement à une baisse de prix. Une question d'achat tranche : que fait votre système avec dix fois plus de calcul ? Si l'on vous répond « il va plus vite », vous êtes devant une base de règles. Si l'on vous répond « il devient meilleur », vous êtes devant un système qui apprend.
La leçon a pourtant une borne : tous les vainqueurs de cette histoire étaient des hybrides. Deep Blue, l'ordinateur d'IBM qui battit le champion du monde d'échecs en 1997, embarquait une fonction d'évaluation de huit mille critères réglés à la main, en plus de sa force de calcul. Ses critiques rappellent à juste titre que l'ingéniosité humaine ne disparaît pas. Elle déménage64. Et c'est vers nos trois U qu'elle déménage : si le calcul emporte le comment, il reste à l'humain le quoi, le pour qui et l'ensuite. Le praticien n'en sort pas dévalué, le jugement monte de prix.
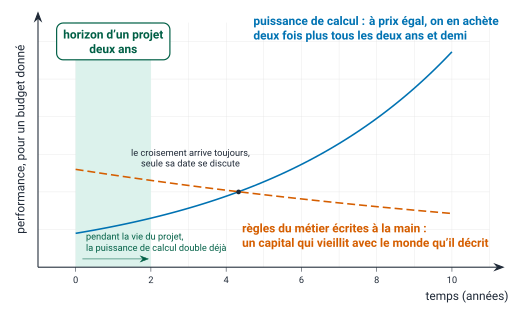
Deux horloges, un budget : l'horizon d'un projet face à la courbe du calcul.
Comment travailler avec les agents sans leur abandonner le gouvernail ? Deux disciplines y aident. La première est une méthode publique, BMAD, pour Breakthrough Method of Agile AI-Driven Development, méthode agile de développement conduite par l'intelligence artificielle. Elle simule une équipe logicielle complète par des agents spécialisés qui se passent le travail comme le feraient un analyste, un chef de produit, un architecte, un développeur et un testeur humains65. Son créateur y voit l'antithèse du vibe coding, le codage à l'ambiance66. Sa vertu est une inversion : la phase de planification force à écrire le brief, le cahier des charges produit et l'architecture avant la première ligne de code. Un humain valide chaque artefact.
Dans nos termes, BMAD institutionnalise le premier U. Il inscrit le deuxième dans les artefacts, puisque les spécifications d'expérience utilisateur y sont un livrable plutôt qu'une politesse. Il rythme enfin le troisième : chaque tâche de développement se clôt par une revue. Les réflexes de l'agilité reprennent du service, en garde-fous pour machines pressées.
La seconde discipline, artisanale, je l'ai racontée en détail ailleurs : les boucles de Ralph67. Agir, rendre, juger, décider, en boucle, avec un budget d'essais déclaré d'avance et un juge protégé, car un agent qui optimise son juge finit par le corrompre. Goodhart ne prend pas de vacances. C'est la discipline de Feynman passée au rythme des machines : ne pas se laisser raconter le résultat par celui qui l'a produit. Les figures de cet article sont passées par cette boucle, défauts consignés puis corrigés à la source. La méthode s'applique à elle-même.
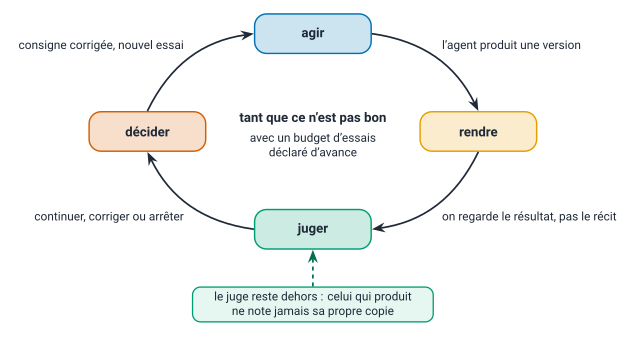
La boucle de Ralph : quatre temps, un budget, un juge qu'on ne corrompt pas.
La boussole du lundi matin
Un cadre qui ne descend pas jusqu'au lundi matin ne vaut rien. À chaque projet, je pose donc ces questions, dans cet ordre. Aucune ne demande de savoir programmer et chacune a déjà sauvé ou tué un projet sous mes yeux.
Pour l'utile. Quelle est l'unité ? Combien vaut chaque type d'erreur en euros, en minutes, en soin ? Quel chiffre des comptes de l'année doit bouger, de combien, d'ici quand ? Puis la plus dure, que je dois à Feynman : si le chiffre était sorti dans l'autre sens, aurions-nous décidé autrement ? Si non, votre instrument est en bambou.
Pour l'utilisable. Qui l'ouvrira un mardi, fatigué, pressé, sans formation fraîche ? Jusqu'où va la compétence de la machine et à quoi l'utilisateur le voit-il sur son écran ? Sur quel cran du curseur l'autonomie est-elle posée, qui a le droit de la monter, qui a le devoir de la descendre quand le coût d'erreur augmente ?
Pour l'utilisé. Qui forme-t-on, à quoi, et quelle part du travail reste sans assistance ? Qui suit les taux de refus des validateurs et la rétention à trois semaines ? Sur quelle ligne budgétaire la maintenance sera-t-elle payée l'an prochain, et par qui ? Reste la clause qui force tout le monde au sérieux dès la signature : comment organise-t-on ma sortie ?
Meurt de liberté
Reste le dernier verbe de Gide : l'art meurt de liberté. L'œuvre sans contrainte se dissout dans la facilité, dit-il. Pour l'œuvre, je lui donne raison. Sur mes projets, sa phrase s'est vérifiée deux fois, dans deux sens contraires. Il faut les séparer, car l'un décrit un échec et l'autre le but.
Premier sens : la liberté qui tue. Libérez un système d'intelligence artificielle de ses contraintes et vous le condamnez. Retirez l'unité : il optimisera un chiffre vide, comme mon orchestrateur audio devenu huit fois plus rapide que nécessaire pendant que ses transcriptions se dégradaient. Retirez le juge indépendant : il finira par corrompre sa propre évaluation. Goodhart l'avait promis et l'expérience des agents le confirme chaque semaine. Retirez la relecture humaine sur un poste où l'erreur coûte cher : Zillow, on l'a vu, a laissé son modèle acheter des maisons en toute liberté et l'aventure s'est arrêtée sur une dépréciation à neuf chiffres. La corde du cerf-volant, encore : coupez-la pour libérer l'objet et il tombe. Un agent sans contrainte est un accident en préparation. Les trois U sont les cordes qu'on lui laisse : un succès défini avant lui, une place dessinée pour l'humain, une surveillance qui ne s'endort pas.
Second sens : la liberté qui couronne. Un système d'intelligence artificielle naît de contrainte : un problème réel, une unité, un coût d'erreur, un chiffre à faire bouger. Il vit de lutte : contre l'écart entre la théorie et le terrain, pour une interface qui respecte la main et l'esprit de celui qui travaille. Et il s'accomplit de liberté. Non pas la sienne, la nôtre. Celle des équipes d'abord : un outil convivial, disait Illich, étend l'autonomie de la personne au lieu de l'asservir à son entretien. Un système utilisé rend les gens plus libres dans leur propre métier, plus rapides vers ce qui compte, déchargés de ce qui ne compte pas. Celle du praticien ensuite : ranger ses outils, transmettre ce qu'on sait, s'en aller commencer ailleurs une nouvelle contrainte. Ce qui meurt alors n'est pas le projet. C'est le besoin qu'on avait de moi.
Les deux sens se tiennent et leur paradoxe me plaît : pour que la liberté couronne les humains, il faut la refuser à la machine. Donnez toute sa liberté au système et vous la retirez à ses utilisateurs, condamnés à surveiller, corriger, réparer. Gide ne pensait évidemment pas aux agents en 1904 et la transposition s'arrête là : une pièce de théâtre ne vous rembourse pas une maison achetée trop cher. La mécanique qu'il décrivait, l'exigence qui élève et la facilité qui dissout, je la retrouve pourtant dans chaque comité de pilotage.
Utile, utilisable, utilisé. Quand le travail est bien fait, le système tourne un jeudi après-midi ordinaire et personne n'y pense. C'est tout ce que je lui souhaite.
Bibliographie
Chaque titre ci-dessous a servi à écrire une section précise, que sa notice indique. Aucun n'est cité de seconde main.
- Gide, A. (1911). De l'évolution du théâtre. Dans Nouveaux Prétextes : réflexions sur quelques points de littérature et de morale, Mercure de France La conférence de Bruxelles de 1904, « De l'évolution du théâtre », d'où viennent la phrase, le cerf-volant, Michel-Ange et Eschyle.
- Gide, A. (1904). Saül ; Le Roi Candaule. Société du Mercure de France Les deux pièces blessées du conférencier, Saül et Le Roi Candaule : Gide parle en connaissance d'échec.
- Léonard de Vinci (1881). Les manuscrits de Léonard de Vinci : le manuscrit A de la Bibliothèque de l'Institut. A. Quantin Le manuscrit A de Vinci : la force « naît par violence et meurt par liberté », matrice de la formule de Gide.
- Davis, F. D. (1989). Perceived Usefulness, Perceived Ease of Use, and User Acceptance of Information Technology. MIS Quarterly, 13(3), p. 319-340 Le modèle d'acceptation de la technologie : l'utilité perçue pèse plus lourd que la facilité d'usage.
- Nielsen, J. (1993). Usability Engineering. Academic Press Le manuel fondateur : l'utilité multipliée par l'utilisabilité.
- International Organization for Standardization (2018). ISO 9241-11:2018 : Ergonomics of human-system interaction : Part 11: Usability: Definitions and concepts. Geneva: ISO, 2e édition La norme qui définit l'utilisabilité noir sur blanc : efficacité, efficience, satisfaction, en contexte.
- Tricot, A., Plégat-Soutjis, F., Camps, J. et al. (2003). Utilité, utilisabilité, acceptabilité : interpréter les relations entre trois dimensions de l'évaluation des EIAH. Dans Environnements Informatiques pour l'Apprentissage Humain (EIAH 2003) Le triptyque francophone : utilité, utilisabilité, acceptabilité.
- Interaction Design Foundation (2016). Useful, Usable, and Used: Why They Matter to Designers. IxDF Literature, 17 mars 2016 Les designers anglophones et leur « useful, usable, used ».
- Kothari, A., Sibbald, S. L., McCutcheon, C. et al. (2025). How does integrated knowledge translation work? A realist review. Health Research Policy and Systems, 23(102). doi.org La recherche en santé exige des résultats « useful, usable and used ».
- Gartner, I. (2018). Gartner Says Nearly Half of CIOs Are Planning to Deploy Artificial Intelligence. Press release, Stamford, CT, 13 février 2018 Le communiqué de 2018 d'où sort le « 85 % » : il prédisait en réalité des résultats erronés pour 2022, prédiction jamais réévaluée.
- VB Staff (2019). Why Do 87% of Data Science Projects Never Make It into Production?. VentureBeat, 19 juillet 2019 L'article sponsorisé d'où sort le « 87 % », sans source primaire.
- Challapally, A., Pease, C., Raskar, R. et Chari, P. (2025). The GenAI Divide: State of AI in Business 2025. MIT NANDA (Project NANDA, Massachusetts Institute of Technology) Le rapport MIT des « 95 % », « directionally accurate » de son propre aveu.
- Ryseff, J., De Bruhl, B. F. et Newberry, S. J. (2024). The Root Causes of Failure for Artificial Intelligence Projects and How They Can Succeed: Avoiding the Anti-Patterns of AI. RAND Corporation L'étude RAND par entretiens. Elle reprend « selon certaines estimations » le chiffre de plus de 80 % d'échecs et trouve, en propre, que la première cause est un malentendu sur le problème à résoudre.
- Strathern, M. (1997). `Improving ratings': audit in the British University system. European Review, 5(3), p. 305-321 La formule exacte « quand une mesure devient une cible », qui est d'elle et non de Goodhart.
- Goodhart, C. A. E. (1984). Problems of Monetary Management: The UK Experience. Dans Monetary Theory and Practice: The UK Experience, Macmillan Education UK. doi.org Le texte de Goodhart dont la loi porte le nom.
- Skalse, J., Howe, N. H. R., Krasheninnikov, D. et Krueger, D. (2022). Defining and Characterizing Reward Hacking. Dans Advances in Neural Information Processing Systems 35 (NeurIPS 2022) Le théorème : tout indicateur plus simple que l'objectif qu'il remplace est piratable.
- Feynman, R. P. (1974). Cargo Cult Science. Engineering and Science, 37(7), p. 10-13 Le discours de la science du culte du cargo, et la discipline envers son propre esprit.
- Becker, J., Rush, N., Barnes, E. et Rein, D. (2025). Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity. arxiv.org L'étude randomisée : des développeurs qui se croient 20 % plus rapides et sont 19 % plus lents.
- Deming, W. E. (s. d.). The New Economics for Industry, Government, Education. MIT Center for Advanced Engineering Study Deming contre l'adage de la mesure : l'essentiel est souvent ce qu'on ne sait pas encore mesurer.
- OpenAI (2022). Introducing ChatGPT. openai.com L'annonce de ChatGPT, où OpenAI dit lui-même le modèle de départ, la série GPT-3.5, et l'entraînement au dialogue : la source qui interdit de réduire le saut de 2022 à une interface.
- Ouyang, L., Wu, J., Jiang, X. et others (2022). Training language models to follow instructions with human feedback. Dans Advances in Neural Information Processing Systems. arxiv.org InstructGPT, la recette d'entraînement par préférences humaines que ChatGPT reprend : ce qui a changé dans le cerveau, et pas seulement sur l'écran.
- Norman, D. (2013). The Design of Everyday Things: Revised and Expanded Edition. Basic Books La psychologie des objets : la poignée de porte qui dit comment on la saisit.
- Krug, S. (2014). Don't Make Me Think, Revisited: A Common Sense Approach to Web Usability. New Riders Le principe de moindre effort : ne me faites pas réfléchir.
- Amershi, S., Weld, D., Vorvoreanu, M. et al. (2019). Guidelines for Human-AI Interaction. Dans Proceedings of the 2019 CHI Conference on Human Factors in Computing Systems (CHI '19), ACM Les dix-huit règles d'interaction humain-IA, validées sur vingt produits.
- Lee, J. D. et See, K. A. (2004). Trust in Automation: Designing for Appropriate Reliance. Human Factors, 46(1), p. 50-80 La confiance calibrée : ajuster la confiance de l'utilisateur aux capacités réelles du système.
- Dietvorst, B. J., Simmons, J. P. et Massey, C. (2015). Algorithm Aversion: People Erroneously Avoid Algorithms After Seeing Them Err. Journal of Experimental Psychology: General, 144(1), p. 114-126 L'aversion à l'algorithme : une seule erreur machine visible suffit à l'abandon.
- Logg, J. M., Minson, J. A. et Moore, D. A. (2019). Algorithm Appreciation: People Prefer Algorithmic to Human Judgment. Organizational Behavior and Human Decision Processes, 151, p. 90-103 L'effet inverse : la déférence excessive envers le chiffre machine.
- Dell'Acqua, F., McFowland III, E., Mollick, E. et al. (2026). Navigating the Jagged Technological Frontier: Field Experimental Evidence of the Effects of Artificial Intelligence on Knowledge Worker Productivity and Quality. Organization Science. doi.org Les 758 consultants et la frontière dentelée : plus vite à l'intérieur, faux à l'extérieur.
- Illich, I. (1973). Tools for Conviviality. Harper & Row L'outil convivial, qui étend l'autonomie de la personne au lieu de l'asservir à son entretien.
- Harchaoui, W. (2026). Sprezzature : create and audit figures, visualizations for app and web content. sprezzature.ai} La suite elle-même : fabriquer et auditer, tout en local, documentation et galerie.
- Castiglione, B. (1991). Le Livre du courtisan. Flammarion Le Courtisan, où la sprezzatura est l'art de cacher l'art.
- Schultz, A. (2014). Lecture 6: Growth. Stanford CS183B « How to Start a Startup », Y Combinator. youtube.com Le cours de Schultz : la courbe de rétention qui s'aplatit, critère le plus simple du métier.
- Parasuraman, R. et Riley, V. (1997). Humans and Automation: Use, Misuse, Disuse, Abuse. Human Factors, 39(2), p. 230-253 La taxonomie usage, mésusage, désusage, abus : le nom savant du troisième U.
- Parasuraman, R. et Manzey, D. H. (2010). Complacency and Bias in Human Use of Automation: An Attentional Integration. Human Factors, 52(3), p. 381-410 La complaisance : s'en remettre à la machine sans plus vérifier.
- Markus, M. L. et Keil, M. (1994). If We Build It, They Will Come: Designing Information Systems That People Want to Use. Sloan Management Review, 35(4) Le logiciel d'étagère, acheté à prix d'or et jamais utilisé.
- Moore, G. A. (2014). Crossing the Chasm: Marketing and Selling Disruptive Products to Mainstream Customers. HarperBusiness Le gouffre entre les enthousiastes de la démo et la majorité pragmatique.
- Selwyn, N. (2003). Apart from Technology: Understanding People's Non-Use of Information and Communication Technologies in Everyday Life. Technology in Society, 25(1), p. 99-116 Le non-usage comme choix souvent rationnel, pas comme déficit à corriger.
- Chatterji, A., Cunningham, T., Deming, D. J. et al. (2025). How People Use ChatGPT. National Bureau of Economic Research Un dixième de la population adulte mondiale utilise ChatGPT.
- Brynjolfsson, E., Li, D. et Raymond, L. (2025). Generative AI at Work. The Quarterly Journal of Economics, 140(2), p. 889-942. doi.org Les 15 % de productivité mesurés chez des agents de support, surtout les novices.
- McKinsey & Company (2025). The State of AI: How Organizations Are Rewiring to Capture Value. McKinsey & Company, QuantumBlack Presque toutes les organisations déclarent utiliser l'IA ; 21 % ont redessiné un flux de travail.
- Microsoft et LinkedIn (2024). AI at Work Is Here. Now Comes the Hard Part: 2024 Work Trend Index Annual Report. Microsoft Corporation Les 78 % d'employés du savoir qui apportent leurs propres outils d'IA au bureau.
- Bainbridge, L. (1983). Ironies of Automation. Automatica, 19(6), p. 775-779 Les ironies de l'automatisation : l'humain de dernier recours est le plus désentraîné.
- Bonnin, L. (2026). J'ai viré mon équipe de dev pour une équipe 100\,% IA pendant 40 jours et 2,3 milliards de tokens Le récit des quarante jours de développement confiés à une équipe entièrement artificielle.
- van der Sijs, H., Aarts, J., Vulto, A. et Berg, M. (2006). Overriding of Drug Safety Alerts in Computerized Physician Order Entry. Journal of the American Medical Informatics Association, 13(2), p. 138-147 Les 49 à 96 % d'alertes de prescription ignorées : la mesure du contournement.
- Sculley, D., Holt, G., Golovin, D. et al. (2015). Hidden Technical Debt in Machine Learning Systems. Dans Advances in Neural Information Processing Systems 28 (NIPS 2015) La petite boîte et la tuyauterie : la dette technique cachée des systèmes d'apprentissage.
- Chapman, P., Clinton, J., Kerber, R. et al. (s. d.). CRISP-DM 1.0: Step-by-Step Data Mining Guide. The CRISP-DM Consortium (NCR, SPSS, DaimlerChrysler) CRISP-DM, qui relègue le déploiement en sixième et dernière phase, à peine décrite.
- Shankar, S., Garcia, R., Hellerstein, J. M. et Parameswaran, A. G. (2024). ``We Have No Idea How Models Will Behave in Production until Production'': How Engineers Operationalize Machine Learning. Proceedings of the ACM on Human-Computer Interaction, 8(CSCW1), p. 206:1-206:34 Les ingénieurs interrogés le disent : on ne connaît pas un modèle avant la production.
- Harchaoui, W. (2026). Conférences en intelligence artificielle. deraison.ai Mes conférences, dont la tuyauterie de l'intelligence artificielle.
- Zillow Group (2021). Zillow Group Reports Third-Quarter 2021 Financial Results & Shares Plan to Wind Down Zillow Offers Operations Zillow : prédire était devenu agir, 304 millions de dollars dépréciés.
- Klarna (2024). Klarna AI assistant handles two-thirds of customer service chats in its first month Klarna se félicite publiquement de ses agents de support.
- Ekblom, J. (2025). Klarna Turns From AI to Real-Person Customer Service. bloomberg.com Puis fait machine arrière.
- Wang, L., Ma, C., Feng, X. et others (2024). A Survey on Large Language Model Based Autonomous Agents. Frontiers of Computer Science. doi.org L'état de l'art des agents : percevoir, planifier, agir par des outils, boucler.
- Anthropic (2024). Building Effective Agents. anthropic.com Le workflow contre l'agent et le conseil contre-intuitif de commencer simple.
- Gartner, I. (2025). Gartner Predicts Over 40% of Agentic AI Projects Will Be Canceled by End of 2027. Communiqué de presse, 25 juin 2025 Les 40 % de projets agentiques annulés prédits d'ici fin 2027 et le nom de la maladie : agent washing.
- McKinsey & Company (QuantumBlack) (2025). Seizing the Agentic AI Advantage Le paradoxe : huit entreprises sur dix déploient, autant n'en voient aucun effet sur le résultat.
- Kapoor, S., Stroebl, B., Siegel, Z. S. et al. (2024). AI Agents That Matter. arxiv.org Les benchmarks d'agents cassés : l'exactitude seule, sans coût ni reproductibilité.
- Nielsen, J. (2023). AI: First New UI Paradigm in 60 Years. Nielsen Norman Group, 18 juin 2023 Le premier changement de paradigme d'interface en soixante ans : spécifier des intentions.
- Xie, T., Zhang, D., Chen, J. et others (2024). OSWorld: Benchmarking Multimodal Agents for Open-Ended Tasks in Real Computer Environments. arxiv.org OSWorld : 72 % de réussite humaine sur des tâches bureautiques réelles, 12 % pour le meilleur agent.
- OSWorld Team (2025). OSWorld-Verified. osworld-v1.xlang.ai Le site du banc, qui date au 28 juillet 2025 sa version corrigée : la raison pour laquelle les scores d'avant et d'après ne se comparent pas ligne à ligne.
- Gonzalez-Pumariega, G., Tu, V., Lee, C. et others (2025). The Unreasonable Effectiveness of Scaling Agents for Computer Use. arxiv.org Le travail qui franchit la barre humaine sur OSWorld dans sa révision de février 2026, en lançant l'agent plusieurs fois puis en faisant trier par un juge : le record qui oblige à lire son protocole.
- Yao, S., Shinn, N., Razavi, P. et Narasimhan, K. (2024). $\tau$-bench: A Benchmark for Tool-Agent-User Interaction in Real-World Domains. arxiv.org Face à des utilisateurs simulés sous règles métier : échec plus d'une fois sur deux, et pas toujours sur la même marche.
- Kwa, T., West, B., Becker, J. et others (2025). Measuring AI Ability to Complete Long Software Tasks. arxiv.org L'horizon des tâches réussies double environ tous les sept mois : une pente, pas une garantie.
- Sutton, R. S. (2019). The Bitter Lesson. incompleteideas.net, 13 mars 2019 La leçon amère : en soixante ans, le calcul finit par battre les règles écrites à la main.
- Brooks, R. (2019). A Better Lesson. rodneybrooks.com, 19 mars 2019 La réponse de Brooks : l'ingéniosité humaine ne disparaît pas, elle se déplace.
- Madison, B. (2025). BMAD-METHOD: Breakthrough Method of Agile AI-Driven Development. github.com La méthode BMAD : une équipe logicielle complète simulée par des agents spécialisés.
- Madison, B. et Prasetya, H. (2026). Stop Vibe Coding: Spec-Driven Development with The BMad Method. Tech Lead Journal, épisode 255, 20 avril 2026 Son créateur la présente comme l'antithèse du vibe coding.
- Harchaoui, W. (2026). Tant que ce n'est pas bon. deraison.ai L'article compagnon de celui-ci : la boucle, son budget déclaré d'avance et son juge protégé.